微信大数据比赛我用树模型怎么从514到671
我是Starry,目前微信大数据比赛分数671,采用的是lgb模型,用的是第14天作为验证集,前面的作为训练集,单折单模模型。从最初开始的514到目前的671花了我近一个月,上分之路及其坎坷,现在主要是分享下各阶段的特征方向和大致分数,希望这个可以对目前比较迷茫的选手可以指明一些大概的方向。先来看看我的分数:最初提交514 最后提交:

微信大数据比赛5月20号开始,5月23号我就兴致勃勃地下载了数据,开始我的上分之旅。刚开始始由于看到群里说几个id类的特征就可做到64,并且由于目前手上只有这一个比赛,想慢慢地做,所以刚开始的时候特征做的特别的谨慎。第一阶段:统计类特征 主要针对几个id做了一些常规的统计特征,比如某个user今天查看了多少次等等,就类似上周周星星分享的那样。注意:本题中虽然训练集是按照时间戳排序的,但是测试集是完全打乱的,所以别自作聪明地做rank类特征(说的就是我自己) 做完这类特征之后,提交之后结果就是516,我很不服气,于是继续基于此删减特征,但是就一直无法摆脱这个分数。此为我的第一阶段分数,采用几个id做单纯的统计特征分数特别低!千万别执着于此。
第二阶段:label滑窗类特征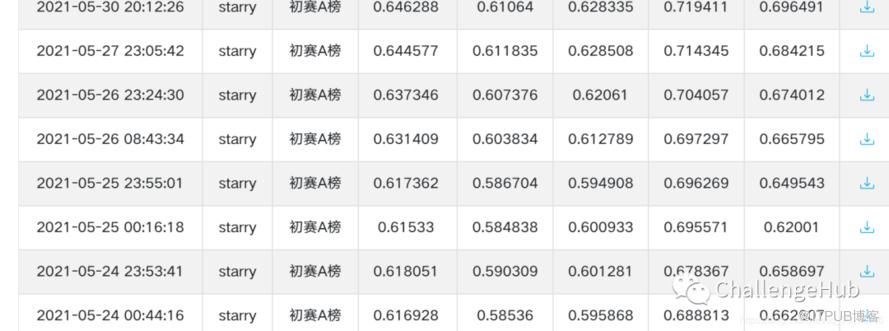 这明显是一个很不错的方向,于是我在两天时间内迅速到达了64。但是很遗憾的是它只让我达到了64,根据周星星开源的代码,做了滑窗类特征之后,也确实只有0.64+,但是我当时并不是知道,花了几天的时间调各种滑窗,虽然不知道最后的分数是多少,但是我记得并没有到达0.65。所以目前滑窗特征做到0.64+的选手可以不必太纠结于那里了。可以下一步的方向了。那么下一步的方向是什么呢?那就是tag和keyword
第三阶段:tag和keyword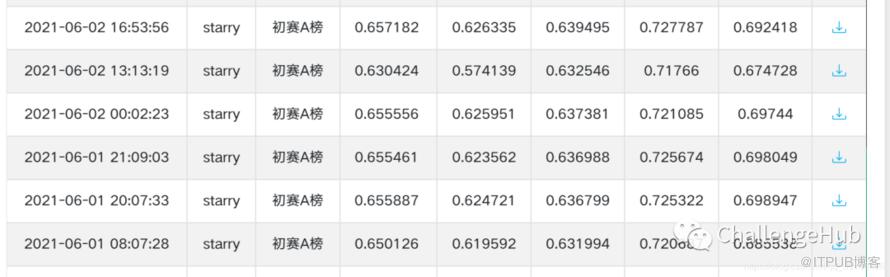 在短暂的几天调滑窗之后,我将tag和keyword降入到了特征中,方法有两种,第一仍然是滑窗,第二是当作类别类特征做统计特征。具体的详细操作大家可以找找类似的比赛,或者问问人。可以肯定的是加入了tag和keyword之后,分数的提升非常大,直接跃到了65+,最后我的成绩是657,觉得无法提升之后,我进入了下一步。
第四步:embedding特征 万物皆可embedding诚不欺我,当我做到657的时候,不少人通过nn已经做到了67,我队友当时也做到668,我就在思考,为什么nn可以轻易的做到那么高的分数,从目前的分数情况来看,单独的nn的结果也是要比树模型的结果要好的。nn最善于的就是embedding,还有之前很多推荐比赛中也有不少人用到了embedding的方法,于是我去用了,结果大家也看到了,确实可以很直观的上分吗。加入了一个w2vembedding之后成绩迅速到达了66,但是当我继续加的时候,发现不怎么上分了。 我在66呆的时间特别长,因为一直在探索新的方法和一些有效无效的尝试,主要就是调整embedding的维度,用更多的embedding,其实这些操作也能带来一点提升,但是很小,有波动,这也就是我为什么一直停留在66了。但是前几天,我又开始了新的探索。
第五步:基于embedding的特征 这一步是可以达到67的,我就不说的很直白了。前面的那些我感觉有手就行,在天才儿童的645baseline上面,很容易660的。第五步是基于第四步做的,采用了第四步得到的一些embedding去做一些特征,大家可以看下DIN模型,没准会有点启发,就是用别的推荐的思想去构建构建特征(做这方面的特征会比较复杂)。还有可以做一些类似于itemcf类的特征(这个我也在尝试中)。
以上就是我的上分的历程,主要是五个阶段,大家可以采用开源的baseline从第三步开始,希望大家早日超越我。
接下来的方向:1:接下来的话继续完善第五步的特征,还有就是由于历史遗留问题,特征已经突破了500个,肯定要删除一些没啥用的特征。2:采用多折,或者嫁接等方法(不过初赛不推荐使用,主要是没必要)
接下来说点小方法:1:baseline中的read_mean一定要用,这样的话32G内存可以做400+特征
2:组件化特征,特征离线都计算好,这样的话增删特征方便,并且验证起来速度快,只需要拼接特征就好了。
3:图神经网络确实可以上分!
行数:55
字数:1499
主题:默认主题
原文作者:ChallengeHub;如有侵权,请联系管理员删除。

