基于用户画像的商品推荐挑战赛--baseline0.5
赛题背景
讯飞AI营销云基于深耕多年的人工智能和大数据技术,赋予营销智慧创新的大脑,以健全的产品矩阵和全方位的服务,帮助广告主用AI+大数据实现营销效能的全面提升,打造数字营销新生态。
赛题任务
基于用户画像的产品推荐,是目前AI营销云服务广告主的一项重要能力,本次赛题选择了两款产品分别在初赛和复赛中进行用户付费行为预测,参赛选手需基于提供的样本构建模型,预测用户是否会购买相应商品。
评价方式
F1计算公式为:
P = 预测对的标签总数 / 预测出的标签数
R = 预测对的标签总数 / 需要预测的总标签数
F1 = 2 * P * R /(P+R)
数据描述
数据集文件如下:
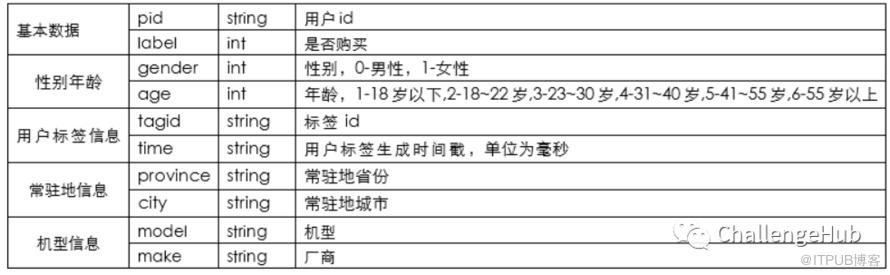
代码部分
首先加载数据:
1import pandas as pd
2import numpy as np
3from tqdm import tqdm
4train = pd.read_csv("data/trainset/train.txt", header=None, sep = ',')
5train.columns= ["pid","label","gender","age","tagid","time","province","city","model","make"]
6
7test = pd.read_csv("data/testset/apply_new.txt", header=None, sep = ',')
8test.columns= ["pid","gender","age","tagid","time","province","city","model","make"]
查看数据集标签的分布。可以看出本赛题的标签是均衡的。
1train.label.value_counts()
2
31    150000
40    150000
5Name: label, dtype: int64
合并训练测试数据集,然后查看整体的数据情况。发现gender的缺失值较多。
 1data = pd.concat((train,test)).reset_index(drop=True)
 2data.info()
 3
 4 #   Column    Non-Null Count   Dtype
 5---  ------    --------------   -----
 6 0   pid       400000 non-null  int64
 7 1   label     300000 non-null  float64
 8 2   gender    73862 non-null   float64
 9 3   age       348498 non-null  float64
10 4   tagid     400000 non-null  object
11 5   time      400000 non-null  object
12 6   province  400000 non-null  object
13 7   city      400000 non-null  object
14 8   model     400000 non-null  object
15 9   make      400000 non-null  object
对tagid的处理,在这里,我的做法是将id和时间一一对应后,按照时间排序后,取Top3的id作为特征,而对于时间列,暂时没有想到要如何处理。
 1time_tagid = []
 2last1_tagid = []
 3last2_tagid = []
 4last3_tagid = []
 5for _,x in tqdm(data.iterrows()):
 6    dicts = {j : i for i,j in zip(eval(x["time"]), eval(x["tagid"]))}
 7    lists = sorted(dicts.items(),key = lambda x:x[0],reverse = True)
 8    time_tagid.append(lists)
 9    last1_tagid.append(lists[0][1])
10    try:
11        last2_tagid.append(lists[1][1])
12    except:
13        last2_tagid.append(np.nan)
14    try:
15        last3_tagid.append(lists[2][1])
16    except:
17        last3_tagid.append(np.nan)
18
19data["time_tagid"] = time_tagid
20data["last1_tagid"] = last1_tagid
21data["last2_tagid"] = last2_tagid
22data["last3_tagid"] = last3_tagid
最后一部分特征便是target_encoder了,也比较常规的特征工程手段。
21train_df.shape, test_df.shape
 1cate_cols = ["gender","province","city","model","make","last1_tagid","last2_tagid","last3_tagid"]
 2test_df = data[data["label"].isnull()].copy().reset_index(drop=True)
 3train_df = data[data["label"].notnull()].copy().reset_index(drop=True)
 4
 5from sklearn.model_selection import StratifiedKFold
 6skf = StratifiedKFold(n_splits=5, shuffle=True, random_state=2021)
 7enc_list = cate_cols
 8for f in tqdm(enc_list):
 9    train_df[f + '_target_enc'] = 0
10    test_df[f + '_target_enc'] = 0
11    for i, (trn_idx, val_idx) in enumerate(skf.split(train_df, train_df['label'])):
12        trn_x = train_df[[f, 'label']].iloc[trn_idx].reset_index(drop=True)
13        val_x = train_df[[f]].iloc[val_idx].reset_index(drop=True)
14        enc_df = trn_x.groupby(f, as_index=False)['label'].agg({f + '_target_enc': 'mean'})
15        val_x = val_x.merge(enc_df, on=f, how='left')
16        test_x = test_df[[f]].merge(enc_df, on=f, how='left')
17        val_x[f + '_target_enc'] = val_x[f + '_target_enc'].fillna(train_df['label'].mean())
18        test_x[f + '_target_enc'] = test_x[f + '_target_enc'].fillna(train_df['label'].mean())
19        train_df.loc[val_idx, f + '_target_enc'] = val_x[f + '_target_enc'].values
20 test_df[f + '_target_enc'] += test_x[f + '_target_enc'].values / skf.n_splits总结
由于baseline过于简单,因此就不放完整代码啦,模型部分就是简单的五折lightgbm,线上分数大概会在0.500左右!抛砖引玉,想要上分还是要仔细的分析赛题任务,分析特征的分布,例如交叉特征、count特征、序列是不是可以做word2vec、是不是可以提取tfidf特征等等,都是有效的上分有段。另外赛题的指标是F1,是否与阈值有关系,调节阈值也有可能上分。最后尝试一下神经网络,魔改nn可能会出奇效。

原文作者:ChallengeHub;如有侵权,请联系管理员删除。

请登录后发表评论
登录
全部评论
