2021中国大学生保险数字挑战赛-数字赛道TOP方案
本次给大家分享的是2021中国大学生保险数字挑战赛-数字赛道的top开源,该方案在A榜取得了0.906812的分数,位列第二,在B榜取得了0.906855的分数,位列第四。分数超级稳定,可惜排名掉了。由于各种原因,目前还未整理好代码,后期附上链接。
该分享的共享者是tsay,队伍名是哦哦的团队,感谢他的分享,接下来他将以第一人称视角给大家讲述他的方案。
赛题任务:基于赛事官方提供的数据及建模分析平台,参赛者需要充分运用数据中所含的信息并结合非车保险的业务特点,进行合理的数据预处理并完成数据处理及分析,预测每一个标的(carid)对于非车产品的购买意向。
赛事链接:2021中国大学生保险数字挑战赛-数字赛道(https://www.heywhale.com/home/competition/607d279965852e0017ab9575/content)
初步的浏览题目的数据之后,发现数据有以下特点:
1.数据特征大概分为四个方向,保险情况数据:机构,险种,等.....,车辆情况:车价,车系,型号......,用户基本情况:年龄,性别,房价.....用户活跃数据:服务发放和使用次数,活跃天数..........,后面的主要的业务特征构造也是围绕这四个方向进行设计。
2:车辆情况特征中的车系,初登日期等类别特征,类别数目多,通过长尾特征聚合,提高特征鲁棒性。
3:16-20年的保额保费有固定的特点,这四年的只要有一年缺失,其他三年也一定是缺失的,并且这种情况下标签都是0。
4:进行特征填充后效果下降,并且统计发现缺失值数目越多,用户的购买意愿越低,用户建档的缺失程度一定,并增加了一些统计缺失值的特征。
从数据这是一个明显的结构化数据的挖掘任务,上分最有效的方法还是特征工程和树模型,首先来介绍一下我的树模型思路:
特征工程
根据赛题给定的数据我的特征工程从以下几个大的方向出发,下面我将分享一下我在各个方向中做的一些认为很有效的特征。
一:车辆情况
考虑到车辆信息的特征类别较多,并且较为严重的长尾,因此根据车辆的给定信息,主观地将该特征做一定的聚合,将多个粗粒度的特征聚合成一个较粗粒度的特征,减少长尾,并且提高该特征的鲁棒性。根据聚合后的特征再做相应的交叉。
二:用户活跃度
1:通过对7,30-7,90-30等先去重复天数细化活跃区间后分级 2:计算服务的发放和使用的比率 3:对点击时长和有效积分做交叉
三:用户画像有关特征
1:籍贯通过房价的进行分级编码 2:年龄性别,以及一些基本情况的简单交叉,直接使用字符类型相加,后面做labelencod 3:通过资料调研对年龄段,房价进行更加细致的数据分箱
四:保险情况
保险情况也是这四个方面最重要的特征,不过该类特征需要很好的利用上面已经构造的特征做一些针对性的二级交叉,比如和车辆性质,地域因素等特征进行交叉。从线上结果来看,效果提升明显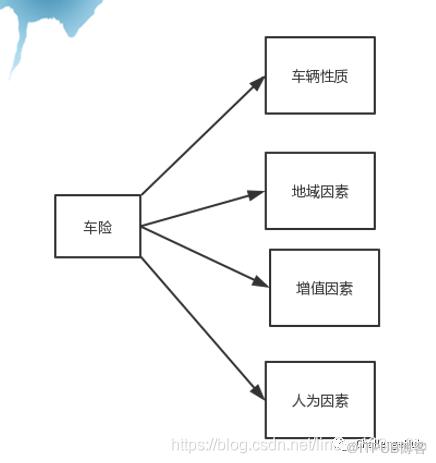 补充:1.车辆性质是根据车辆价格和各种车险比例做特征,该特征取得了较大的成绩提升。2.地域和增值因素主要是通过考虑机构和车险和非车险一个之间占比来考虑,认为因素主要考虑出险次数对保费的影响,需要注意的一点是,出险次数越多,保费也会随之增高,并且同时会影响车辆的价值和ncd的指数。
此外,仔细地考虑了非车险的一些特征,发现全部数据中除去四年保费都为空,并且不购买的这些用户,剩下的所有数据中选择在21年放弃购买非车险的,全部都是已经连续四年缴纳的,所以思考是什么原因导致他们放弃继续续保?个人认为有如下四点:1.车辆的价值随着年限和出险次数,价值降低太多了,导致没有缴纳车险的必要了。(通过年限和出险次数计算车辆当前价值,然后和保费保额做交叉,这个操作有着很大的分数提升空间) 2.用户对非车险的意愿不是很高,关注度过低,可以体现在用户活跃度的情况下 3.用户个人的财产状态或者特殊的情况导致不再缴纳非车险(是否过户,房子的情况,等) 因此可以推出以下情况下的更倾向缴纳:1.新车 2.车的价值较高,经济状况较好 3.用车的性质,职业有关 4.个人一些基本的家庭状况 基于以上考虑可以做一些特征。
模型小trick
1:该题采用网格搜索搜索参数可以带来一定的提升,以下是我搜索的参数,参数调整提升一个千。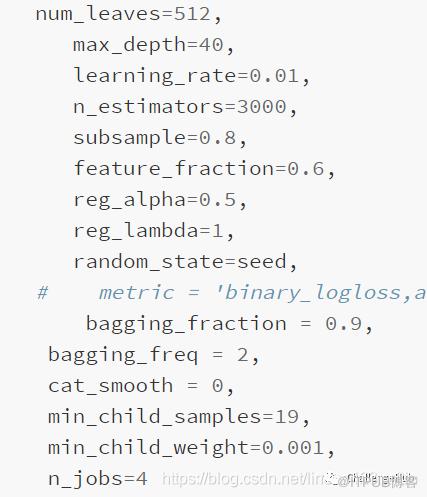 2:采用10折会比5折更好,大约1个千。3:多模型多种子融合并没有给我带来什么提升。
写在最后:
1.这是我第一次参加数据挖掘比赛,也算是个比赛新手,在思路表述和处理方面上面可能存在一定的缺陷,见笑了,也希望大家提出,一起交流进步。
2.这次比赛虽然很遗憾没有进入决赛,但是依然可以收获很多东西,也看到自己的不足的地方,包括对于方案答辩的一些能力的培养,希望有待加强。
3:代码由于写的比较垃圾,后面抽空整理会贴出,也希望借此第一次分享,以后有机会做出更加精彩的总结。
谢谢大家,欢迎大家多多交流。
大家加左图进入微信群;右图有QQ学习交流群


原文作者:ChallengeHub;如有侵权,请联系管理员删除。

