文本分类上分微调技巧实战
后台回复“学术论文”获取完整notebook代码
目录
引言 How to Fine-Tune BERT for Text Classification 论文
微调策略 ITPT:继续预训练
学术论文分类挑战赛微调
huggingface工具介绍 bert模型介绍 数据创建 模型定义 模型训练与评估 模型改进
引言 How to Fine-Tune BERT for Text Classification 论文 微调策略 ITPT:继续预训练 学术论文分类挑战赛微调 huggingface工具介绍 bert模型介绍 数据创建 模型定义 模型训练与评估 模型改进
微调策略
处理长文本 我们知道BERT 的最大序列长度为 512,BERT 应用于文本分类的第一个问题是如何处理长度大于 512 的文本。本文尝试了以下方式处理长文章。
处理长文本 我们知道BERT 的最大序列长度为 512,BERT 应用于文本分类的第一个问题是如何处理长度大于 512 的文本。本文尝试了以下方式处理长文章。
Truncation methods 截断法 文章的关键信息位于开头和结尾。我们可以使用三种不同的截断文本方法来执行 BERT 微调。
head-only: keep the first 510 tokens 头部510个字符,加上两个特殊字符刚好是512 ; tail-only: keep the last 510 tokens;尾部510个字符,同理加上两个特殊字符刚好是512 ; head+tail: empirically select the first 128and the last 382 tokens.:尾部结合
Hierarchical methods 层级法 输入的文本首先被分成k = L/510个片段,喂入 BERT 以获得 k 个文本片段的表示向量。每个分数的表示是最后一层的 [CLS] 标记的隐藏状态,然后我们使用均值池化、最大池化和自注意力来组合所有分数的表示。
不同层的特征 BERT 的每一层都捕获输入文本的不同特征。文本研究了来自不同层的特征的有效性, 然后我们微调模型并记录测试错误率的性能。
我们可以看到:最后一层表征效果最好;最后4层进行max-pooling效果最好
灾难性遗忘 Catastrophic forgetting (灾难性遗忘)通常是迁移学习中的常见诟病,这意味着在学习新知识的过程中预先训练的知识会被遗忘。因此,本文还研究了 BERT 是否存在灾难性遗忘问题。我们用不同的学习率对 BERT 进行了微调,发现需要较低的学习率,例如 2e-5,才能使 BERT 克服灾难性遗忘问题。在 4e-4 的较大学习率下,训练集无法收敛。
这个也深有体会,当预训练模型失效不能够收敛的时候多检查下超参数是否设置有问题。
Layer-wise Decreasing Layer Rate 逐层降低学习率 下表 显示了不同基础学习率和衰减因子在 IMDb 数据集上的性能。我们发现为下层分配较低的学习率对微调 BERT 是有效的,比较合适的设置是 ξ=0.95 和 lr=2.0e-5
为不同的BERT设置不同的学习率及衰减因子,BERT的表现如何?
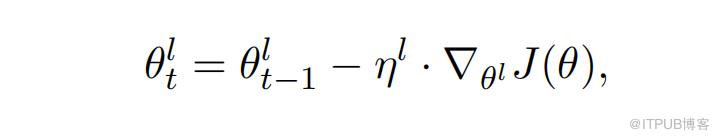 η^l代表第几层的学习率
ITPT:继续预训练
ITPT:继续预训练 Bert是在通用的语料上进行预训练的,如果要在特定领域应用文本分类,数据分布一定是有一些差距的。这时候可以考虑进行深度预训练。
Within-task pre-training:Bert在训练语料上进行预训练 In-domain pre-training:在同一领域上的语料进行预训练 Cross-domain pre-training:在不同领域上的语料进行预训练 Within-task pretraining [图片上传失败...(image-177ffd-1627289320036)] BERT-ITPT-FiT 的意思是“BERT + with In-Task Pre-Training + Fine-Tuning”,上图表示IMDb 数据集上进行不同步数的继续预训练是有收益的。
In-Domain 和 Cross-Domain Further Pre-Training
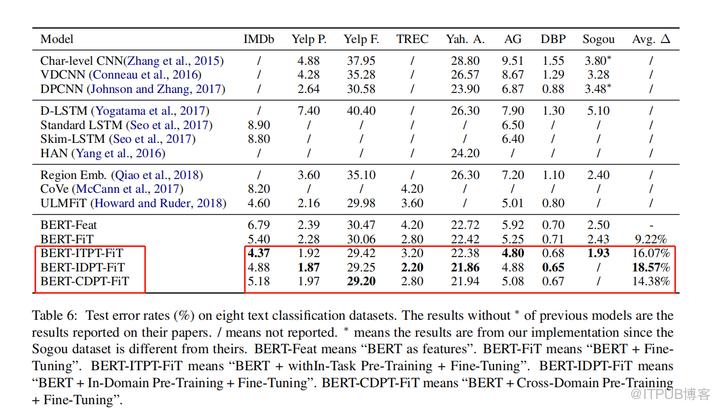
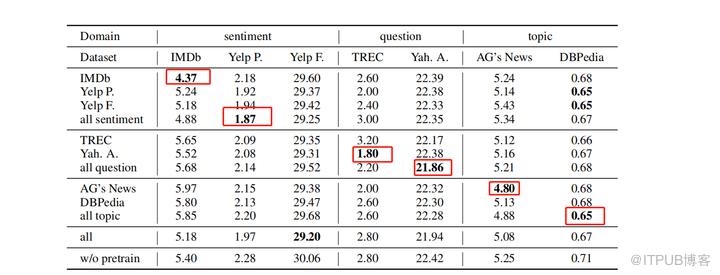 我们发现几乎所有进一步的预训练模型在所有七个数据集上的表现都比原始 BERT 基础模型。一般来说,域内预训练可以带来比任务内预训练更好的性能。在小句子级 TREC 数据集上,任务内预训练会损害性能,而在使用 Yah 的领域预训练中。Yah. A.语料库可以在TREC上取得更好的结果。这篇论文与其他模型进行了比较,结果如下表所示:
改进1 Last 4 Layers Concatenating
class LastFourModel(nn.Module):

    def __init__(self):
        super().__init__()

        config = AutoConfig.from_pretrained(PRE_TRAINED_MODEL_NAME)
        config.update({'output_hidden_states':True})
        self.model = AutoModel.from_pretrained(PRE_TRAINED_MODEL_NAME, config=config)
        self.linear = nn.Linear(4*HIDDEN_SIZE, n_classes)

    def forward(self, input_ids, attention_mask):

        outputs = self.model(input_ids, attention_mask)
        all_hidden_states = torch.stack(outputs[2])
        concatenate_pooling = torch.cat(
            (all_hidden_states[-1], all_hidden_states[-2], all_hidden_states[-3], all_hidden_states[-4]), -1
        )
        concatenate_pooling = concatenate_pooling[:,0]
        output = self.linear(concatenate_pooling)

        return soutput
def __init__(self):
super().__init__()
config = AutoConfig.from_pretrained(PRE_TRAINED_MODEL_NAME)
config.update({'output_hidden_states':True})
self.model = AutoModel.from_pretrained(PRE_TRAINED_MODEL_NAME, config=config)
self.linear = nn.Linear(4*HIDDEN_SIZE, n_classes)
def forward(self, input_ids, attention_mask):
outputs = self.model(input_ids, attention_mask)
all_hidden_states = torch.stack(outputs[2])
concatenate_pooling = torch.cat(
(all_hidden_states[-1], all_hidden_states[-2], all_hidden_states[-3], all_hidden_states[-4]), -1
)
concatenate_pooling = concatenate_pooling[:,0]
output = self.linear(concatenate_pooling)
return soutput
改进2 模型层间差分学习率
def get_parameters(model, model_init_lr, multiplier, classifier_lr):
    parameters = []
    lr = model_init_lr
    for layer in range(12,-1,-1):
        layer_params = {
            'params': [p for n,p in model.named_parameters() if f'encoder.layer.{layer}.' in n],
            'lr': lr
        }
        parameters.append(layer_params)
        lr *= multiplier
    classifier_params = {
        'params': [p for n,p in model.named_parameters() if 'layer_norm' in n or 'linear' in n
                   or 'pooling' in n],
        'lr': classifier_lr
    }
    parameters.append(classifier_params)
    return parameters
parameters=get_parameters(model,2e-5,0.95, 1e-4)
optimizer=AdamW(parameters)
parameters = []
lr = model_init_lr
for layer in range(12,-1,-1):
layer_params = {
'params': [p for n,p in model.named_parameters() if f'encoder.layer.{layer}.' in n],
'lr': lr
}
parameters.append(layer_params)
lr *= multiplier
classifier_params = {
'params': [p for n,p in model.named_parameters() if 'layer_norm' in n or 'linear' in n
or 'pooling' in n],
'lr': classifier_lr
}
parameters.append(classifier_params)
return parameters
parameters=get_parameters(model,2e-5,0.95, 1e-4)
optimizer=AdamW(parameters)
改进3 ITPT 继续预训练
import warnings
import pandas as pd
from transformers import (AutoModelForMaskedLM,
                          AutoTokenizer, LineByLineTextDataset,
                          DataCollatorForLanguageModeling,
                          Trainer, TrainingArguments)

warnings.filterwarnings('ignore')

train_data = pd.read_csv('data/train/train.csv', sep='\t')
test_data = pd.read_csv('data/test/test.csv', sep='\t')
train_data['text'] = train_data['title'] + '.' + train_data['abstract']
test_data['text'] = test_data['title'] + '.' + test_data['abstract']
data = pd.concat([train_data, test_data])
data['text'] = data['text'].apply(lambda x: x.replace('\n', ''))

text = '\n'.join(data.text.tolist())

with open('text.txt', 'w') as f:
    f.write(text)

model_name = 'roberta-base'
model = AutoModelForMaskedLM.from_pretrained(model_name)
tokenizer = AutoTokenizer.from_pretrained(model_name)
tokenizer.save_pretrained('./paper_roberta_base')

train_dataset = LineByLineTextDataset(
    tokenizer=tokenizer,
    file_path="text.txt",  # mention train text file here
    block_size=256)

valid_dataset = LineByLineTextDataset(
    tokenizer=tokenizer,
    file_path="text.txt",  # mention valid text file here
    block_size=256)

data_collator = DataCollatorForLanguageModeling(
    tokenizer=tokenizer, mlm=True, mlm_probability=0.15)

training_args = TrainingArguments(
    output_dir="./paper_roberta_base_chk",  # select model path for checkpoint
    overwrite_output_dir=True,
    num_train_epochs=5,
    per_device_train_batch_size=16,
    per_device_eval_batch_size=16,
    gradient_accumulation_steps=2,
    evaluation_strategy='steps',
    save_total_limit=2,
    eval_steps=200,
    metric_for_best_model='eval_loss',
    greater_is_better=False,
    load_best_model_at_end=True,
    prediction_loss_only=True,
    report_to="none")

trainer = Trainer(
    model=model,
    args=training_args,
    data_collator=data_collator,
    train_dataset=train_dataset,
    eval_dataset=valid_dataset)

trainer.train()
trainer.save_model(f'./paper_roberta_base')
import pandas as pd
from transformers import (AutoModelForMaskedLM,
AutoTokenizer, LineByLineTextDataset,
DataCollatorForLanguageModeling,
Trainer, TrainingArguments)
warnings.filterwarnings('ignore')
train_data = pd.read_csv('data/train/train.csv', sep='\t')
test_data = pd.read_csv('data/test/test.csv', sep='\t')
train_data['text'] = train_data['title'] + '.' + train_data['abstract']
test_data['text'] = test_data['title'] + '.' + test_data['abstract']
data = pd.concat([train_data, test_data])
data['text'] = data['text'].apply(lambda x: x.replace('\n', ''))
text = '\n'.join(data.text.tolist())
with open('text.txt', 'w') as f:
f.write(text)
model_name = 'roberta-base'
model = AutoModelForMaskedLM.from_pretrained(model_name)
tokenizer = AutoTokenizer.from_pretrained(model_name)
tokenizer.save_pretrained('./paper_roberta_base')
train_dataset = LineByLineTextDataset(
tokenizer=tokenizer,
file_path="text.txt", # mention train text file here
block_size=256)
valid_dataset = LineByLineTextDataset(
tokenizer=tokenizer,
file_path="text.txt", # mention valid text file here
block_size=256)
data_collator = DataCollatorForLanguageModeling(
tokenizer=tokenizer, mlm=True, mlm_probability=0.15)
training_args = TrainingArguments(
output_dir="./paper_roberta_base_chk", # select model path for checkpoint
overwrite_output_dir=True,
num_train_epochs=5,
per_device_train_batch_size=16,
per_device_eval_batch_size=16,
gradient_accumulation_steps=2,
evaluation_strategy='steps',
save_total_limit=2,
eval_steps=200,
metric_for_best_model='eval_loss',
greater_is_better=False,
load_best_model_at_end=True,
prediction_loss_only=True,
report_to="none")
trainer = Trainer(
model=model,
args=training_args,
data_collator=data_collator,
train_dataset=train_dataset,
eval_dataset=valid_dataset)
trainer.train()
trainer.save_model(f'./paper_roberta_base')
原文作者:ChallengeHub;如有侵权,请联系管理员删除。

