数据处理中不得不会的pandas技巧
对于任何一个数据挖掘比赛来说,必不可少的包就是pandas了,一般代码的第一行就是import pandas as pd。pandas的数据处理能力无疑是强大的,但同样由于它实在太强大了,有很多很多的方法,让初学者根本就不知道它可以实现哪些功能,直到现在我也是如此。想写这个的主要原因是看到一个朋友写的数据处理代码,写的实在是让人不敢恭维。以至于我在他数据处理阶段中看到for循环,这种代码虽然也可以运行,但是速度很慢,并且很不优雅。因此我回顾了我参加过的数据挖掘比赛,看了一下其中的代码,总结了一些我用到的pandas的数据处理方法,在这里分享给大家。代码可能有点长,萌新的话浏览一遍就可以,主要是记住pandas可以帮你实现哪些操作。本文也主要是面向萌新的。
为了更好的手把手教学,我们先创建一个数据集:
def data_A():
    item=[random.randint(1,500) for i in range(5000)]
    user=[random.randint(1,600) for i in range(5000)]
    time=[random.randint(1,100000) for i in range(5000)]
    cate1=[random.randint(0,10) for i in range(5000)]
    num1=[random.random() for i in range(5000)]
    data=[[user[i],item[i],time[i],cate1[i],num1[i]] for i in range(5000)]
    df=pd.DataFrame(data,columns=['user','item','time','fea1','fea2'])
    return df
df=data_A()
创建的是一个模拟推荐的数据,有五个字段分别为user(用户),item(商品),time(时间),fea1(整数型特征),fea2(浮点型特征)。
def data_B():
    item=[random.randint(1,500) for i in range(5000)]
    tag=[str(random.randint(1,500))+","+str(random.randint(1,500))for i in range(5000)]
    data=[[item[i],tag[i]] for i in range(5000)]
    df=pd.DataFrame(data,columns=['item','tag'])
    return df
data=data_B()
该数据有两个字段,一个是item还有一个是tag。
一:全局统计信息
首先拿到一份数据,我们要进行的操作是全局统计,查看一些全局的信息。此时我们用到的函数有:
1:df.info() 查看数据大小,index(索引)范围,特征以及相应的字段类型和空值情况,以及整个数据占内存的大小。
2:df.nunique()
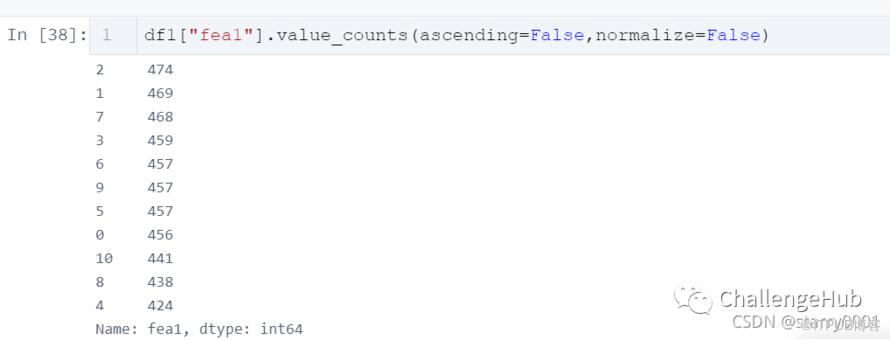
查看每个字段有多少种取值,如下所示: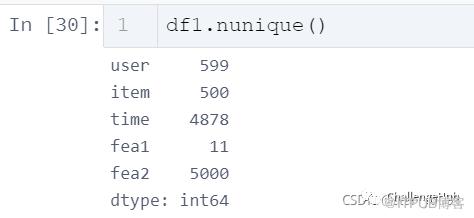 3:df["fea1"].value_counts(ascending=False, normalize=False) 两个参数分别代表按是否小到大排序和是否归一化,默认的值都是False。一般用来查看类别特征和label的分布情况
二 单特征的变换
目前user和item特征都是整数型的,如果要把它转为字符型,我们可以:
df['user']=df['user'].astype(str)
df['user']="user"+df['user']
同样我们也可以将其转化为整数型:
df['user']=df['user'].apply(lambda x:int(x[1:]))
由于df['user']中含有不能转化为整数的字符"u",因此不能直接转换,需要用到apply函数,apply输入的是一个function(函数),上面的函数很简单,因此我们一般使用lambda函数,当然我们也可以写为:
def func(x):
 x=x[1:]
 return int(x)
df['user']=df['user'].apply(func)
apply是一个很常用的pandas使用技巧,希望大家都可以熟练的使用。关于aplly我们也可以使用tqdm来观看进度:
from tqdm import tqdm
tqdm.pandas()
df['user1']=df['user'].progress_apply(lambda x:str(x))
对于比较复杂的data中的tag字段,我们一般有有一些操作:
1:获取每个item的tag的数量
data['lenTag']=data['tag'].apply(lambda x:len(x.split(',')))
2:获取每个item的第一个tag
data['Tag1']=data['tag'].apply(lambda x:x.split(',')[0])
3:获取每个item数值最小的tag(当然一般是没有实际意义的,只是告诉大家可以这样做)
data['Tags']=data['tag'].apply(lambda x:sorted(list(map(int,x.split(','))))[0])
除此之外,我们可能会需要一些别的操作,比如下面的两个大家也需要掌握:
1:拓展列
data1=data['tag'].str.split(',', expand=True)
col='tag'
2:拓展行(也是我们常说的列转行)
temp = data.set_index(["item"])[col].str.split(",", expand=True).stack().reset_index(drop=True,level=-1).reset_index().rename(columns={0: col})
 单特征还有最后一个常用的是onehot:
col="fea1"
df=pd.merge(df.drop(col,axis=1),pd.get_dummies(df[col],col),left_index=True,right_index=True)
#将fea1变成fea_1到fea_10
二 特征之间的交互
如果发现fea1和fea2相乘是强特,那么可以直接操作:
df["{}_mul_{}".format("fea1","fea2")]=df['fea1']*df['fea2']
不过很多时间问题不是那么简单,分析之后发现只有当fea1等于特定值的时候进行相乘才是有意义,那么我们根据loc指定特征的行进行相关操作。第二行代码就是筛选特定的行的index。(loc和iloc是df获取行的某一行,但是两者差距很大,loc是直接定位到index,而iloc是第几行,当index=0-N的时候两者是一样的,一般我更推荐使用loc)
df["{}_mul_{}".format("fea1","fea2")]=np.nan
ind=(df[df['fea1']==1]).index
df["{}_mul_{}".format("fea1","fea2")]=df.loc[ind,'fea1']*df.loc[ind,'fea2']
既然说到了筛选行,那么我们就继续展开吧。假如我们要获取满足条件的某些数据一般我们是:
df[df['user']==1]  #获取user=1的数据
df[(df['user']==1)|(df['user']==5)] #获取user=1或者5的数据
df[(df['user']==1)&(df['fea1']==5)] #获取同时满足两个条件的数据
df[df['user']==1]['item']  #获取user=1的浏览item,返回的是serise
df[df['user']==1][['item']]#同样获取user=1的浏览item,返回的是DataFrame
上文中我们介绍了apply函数,在2个特征交互的时候apply也是可以使用的,当然3个,4个特征也是可以这么使用的。
def func(x,y):
 """
 x:输入的特征1的值
 y:输入的特征2的值
 """
 return
df['fea3']=df.apply(lambda index:func(index['fea1'],index['fea2']),axis=1)
三 groupBy Sort_values Shift等操作
1:groupby
df.groupby(['user'])['fea1'].sum()
df['fea2_mean']=df.groupby(['user'])['fea2'].transform('mean')

b=df.groupby(['user'])['fea2'].mean() #获得是一个serise
a=b.to_dict()  #但是这个serise可以转化为dict(字典)
df['fea2_mean2']=df['fea2'].map(b)#map可以传入serise
df['fea2_mean3']=df['fea2'].map(a)##同样也可以传入dict
比较复杂的groupby:
b=df.groupby(['user','fea1'])[['fea2','time']].agg(['mean','sum'])
b.columns=['{}_{}'.format(i,j) for i in ['fea2','time'] for j in ['mean','sum']]
b=b.reset_index()
2:sort_values
#根据用户和时间进行排序,ascending是控制升序还是降序
df=df.sort_values(['user','time'],ascending=True)
当存在对多个字段进行排序的时候我们可以这样:
df=df.sort_values(['user','time'],ascending=[True,False])
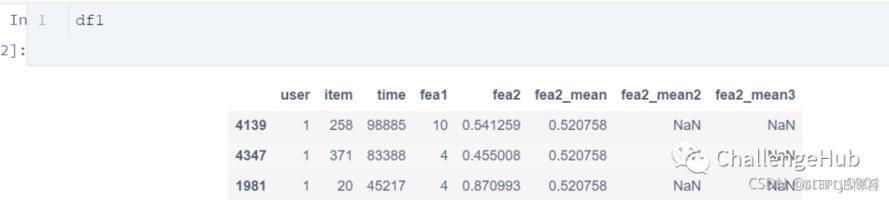 进行排序之后index是乱的,可以通过reset_index重新建立0-N的索引:
df=df.sort_values(['user','time'],ascending=[True,False]).reset_index(drop=True)
#默认的drop为False,在这种情况下它会新建一个0-N的index,并且把之前的index作为一列特征。
3:groupyby和sort联合使用 假设现在需要你输出每个用户最后观看的5条item?怎么可以快速的实现,在SQL中,需要用partition by分组排序的方法。在pandas中也是如此,但是代码更简单:
df=df.sort_values(['user','time'],ascending=[True,False]).reset_index(drop=True)
dfTop5=df.groupby(['user']).head(5)
#这种实现需要2步,第一步排序,第二部groupby直接取head()
4:shift
我们经常将这种方法叫做滑窗,当然他本来也是如此: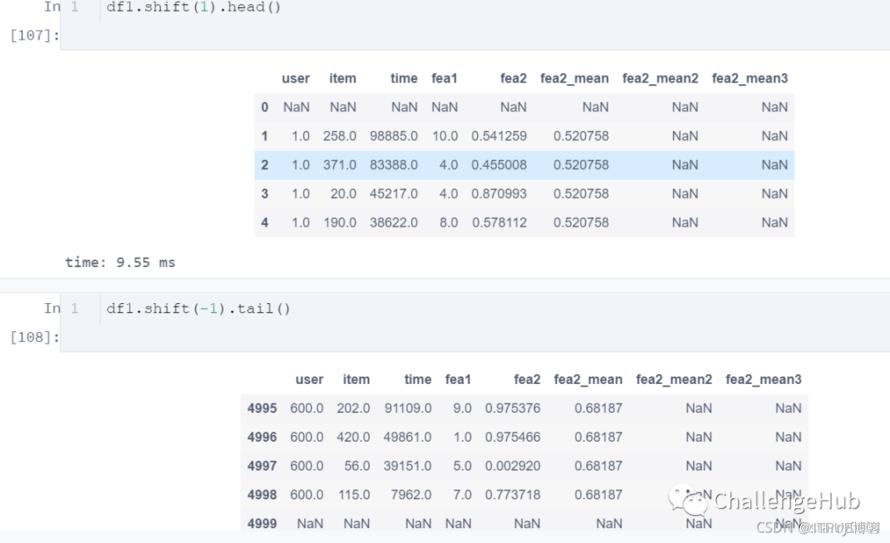 shift就是将数据向上向下滑动,上面的例子很直观。当然我们的操作并不止如此,我们可以用它来获取用户这次和上次观看item的时间隔间。
df1=df1.sort_values(['user','time'],ascending=True)
df1['gap']=df1['time']-df1.groupby(['user'])['time'].shift(1)
四:两个表之间的操作
1:concat
df2=df1[:2000]
df=pd.concat([df1,df2]) #纵向连接
dff=pd.concat([df1,df2],axis=1) #横向连接
2:merge
dataALl=pd.merge(df1,data,on='item',how='left')
#最常规的直接连接。输入的连个都是DataFrame

data2=data.set_index('item')[['tag']] #dataFrame
dataALl2=pd.merge(df1,data2,left_on='item',right_index=True,how='left')
#通过index连接

data3=data.set_index('item')['tag'] #serise
dataALl3=pd.merge(df1,data3,left_on='item',right_index=True,how='left')
# 不仅可以传入dataFrame,同样可以传入serise
以上就是数据挖掘中常用的pandas中常用的一些数据处理技巧了。学会这些技巧应该可以应付常见的数据处理了。如果想要获取以上的代码的话,可以进入链接:https://www.heywhale.com/org-portal/ChallengeHub/project/1G0-ZwMYqQ0ZtStkXhysAFauMjz_ixTGQVo70otmMvQ/share。
谢谢大家观看,如果有学习或者喜欢数据分析的朋友可以通过下面的方式加入群里一起交流学习。qq群号:763989358

原文作者:ChallengeHub;如有侵权,请联系管理员删除。

