字节跳动安全Ai挑战赛-小样本赛道方案总结
本次比赛是传统的数据挖掘机器学习比赛,数据量样本充足,赛题质量比较高,是一次比较好的比赛体验。我们队伍“废物3号”,队员有华仔、致Great,最终决赛取得第五名成绩,下面主要给大家分享下我们队伍的建模思路和主要特征工程,希望能够对大家有所帮助。
赛题描述
在真实的社交网络中,存在的作弊用户会影响社交网络平台。在真实场景中,会受到多方面的约束,我们仅能获取到少部分的作弊样本和一部分正常用户样本,现需利用已有的少量带标签的样本,去挖掘大量未知样本中的剩余作弊样本。给定一段时间内的样本,其中包含少量作弊样本,部分正常样本以及标签未知的样本。参赛者应该利用这段时间内已有的数据,提出自己的解决方案,以预测标签未知的样本是否为作弊样本。数据处理方法和算法不限,但是参赛者需要综合考虑算法的效果和复杂度,从而构建合理的解决方案。
题目思路
基于给定的少量样本,一个比较直接的思路是通过样本之间的关联性挖掘相关的黑样本,然后基于挖掘得到的相关黑样本训练一个二分类器,从而得到更多的黑样本。
题目数据
数据范围:
T~T+N 时刻内 点赞、关注事件下按比例抽样数据 特征类型: 
数据统计
总账号数 :4579520 带标签正常账号:102630 带标签作弊账号数:10667 总请求数量:8227327 提交评估数据:151117
特征相关性统计如下: 请求数据中存在的都是类别变量,可以统计类别变量下的转化率,分析哪些特征潜在挖掘价值比较大;对于用户基础数据可以通过相关性系数直观上推断哪些变量比较重要。
对于数值特征,可以着重统计下用户粉丝数量与用户关注数量的差值特征、用户发布作品数量与用户作品喜欢数量的差值特征,这些可以逆势特征可以侧面发映出用户是否存在真实社交行为,而不是“白白”的黑产账号。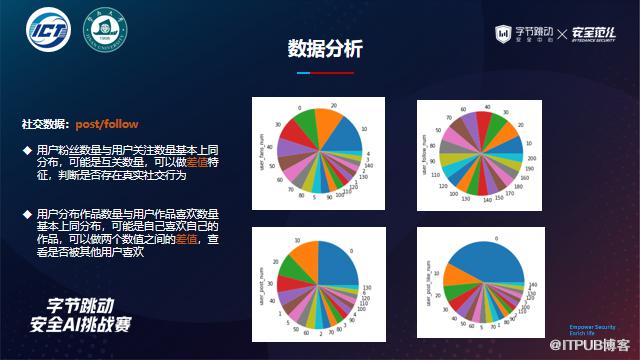
特征工程
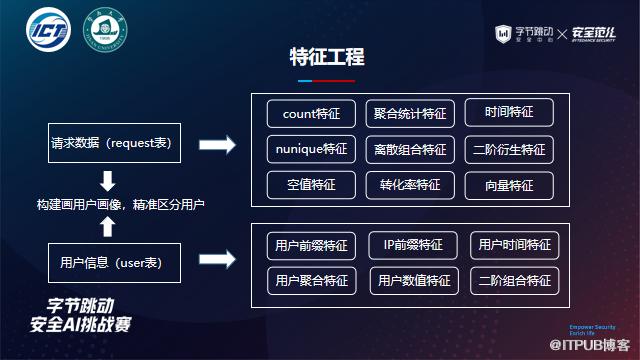
特征工程决定了模型最后的效果,特征工程在做完常规基础特征之后,需要根据模型反馈的效果,可以围绕强特去做进一步的细化特征,下面给出一些代码参考。我们在方案中主要构建了三个维度的特征,
用户画像特征:请求表征、基础特征
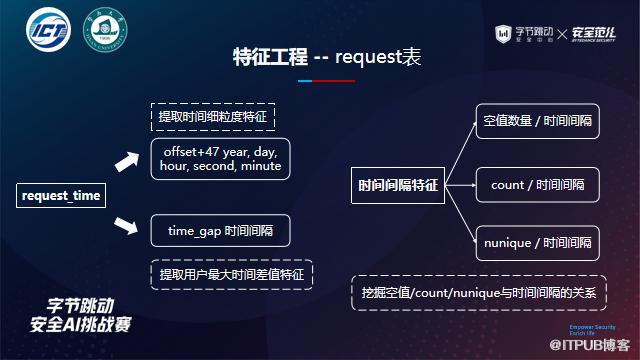
请求数据的统计特征
## 时间特征
request_feature['app_channel_nacnt_time_ratio']=request_feature['app_channel_nacnt']/(request_feature['time_gap']+1e-3)
request_feature['device_type_nacnt_ratio']=request_feature['device_type_nacnt']/(request_feature['time_gap']+1e-3)

request_feature['request_app_channel_count_ratio']=request_feature['group_request_user_request_app_channel_count']/(request_feature['time_gap']+1e-3)
request_feature['request_count_time_ratio']=request_feature['request_user_count']/(request_feature['time_gap']+1e-3)
request_feature['request_device_type_count_time_ratio']=request_feature['group_request_user_request_device_type_count']/(request_feature['time_gap']+1e-3)

request_feature['request_ip_nuinque_ratio']=request_feature['group_request_user_request_ip_nunique']/(request_feature['time_gap']+1e-3)
request_feature['request_model_nuinque_ratio']=request_feature['group_request_user_request_model_id_nunique']/(request_feature['time_gap']+1e-3)
request_feature['request_target_nuinque_time_ratio']=request_feature['group_request_user_request_target_nunique']/(request_feature['time_gap']+1e-3)
## 强特 二阶unique特征
base_cols = [
    ['request_user', 'request_model_id'],
    ['request_user', 'request_device_type'],
    ['request_user', 'request_app_channel'],
    ['request_user', 'request_app_version'],
]
target_col = ['request_model_id', 'request_ip', 'request_target', 'request_device_type', 'request_app_version',
              'request_app_channel']
for base_pair in base_cols:
    for col in tqdm(target_col):
        if col not in base_pair:
            request_feature[col] = request_feature[col].fillna('NAN')
            request_feature[f'group_{base_pair[0]}_{base_pair[1]}_{col}_unique'] = \
            request_feature[base_pair + [col]].groupby(base_pair)[col].transform('nunique')
用户基础信息的统计特征

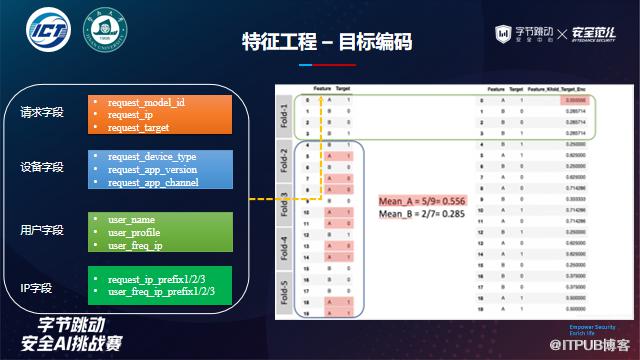
目标编码
用户关联特征:图嵌入式表示
行为特征:时间段内行为序列表示
模型构建
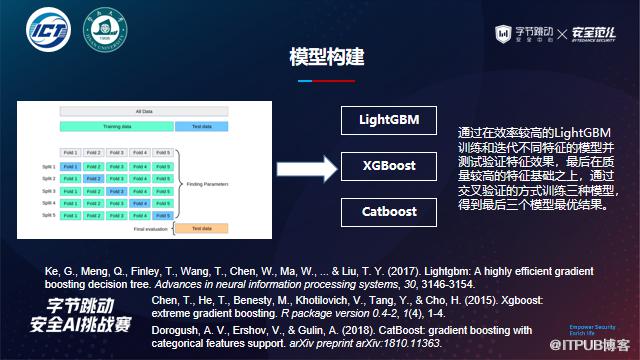
模型选取:LGB/XGB/CAT
通过在效率较高的LightGBM训练和迭代不同特征的模型并测试验证特征效果,最后在质量较高的特征基础之上,通过交叉验证的方式训练三种模型,得到最后三个模型最优结果。
模型融合:相加平均
在比赛过程中,我们针对三种模型尝试了不同的融合方案,包括投票融合,加权融合,还有stacking,但是融合收益比较小,最后我们选取的融合方式是直接将三种模型预测概率结果融合简单平均,能够达到融合收益最大。

特征重要性分析
总结与展望
在比赛过程中,我们尝试的树模型可解释性强且给出衍生特征构建方向,训练迭代速度快,另外用户行为特征,时间序列特征以及用户画像特征比较重要,同时用户与设备、用户与网络之间的网络特征有潜在挖掘价值。尝试不足的地方是没有有效通过有监督模型预测无标签数据集,之后进行伪标签学习,没有尝试神经网络模型或者图神经网络的实验效果

大家有什么问题可以添加微信,可以进群随时交流

原文作者:ChallengeHub;如有侵权,请联系管理员删除。

