YashanDB共享集群V23.3 新特性解读
孟凡彬 YashanDB 集群首席架构师
本文基于孟凡彬 2024 年 11 月在 2024 年国产数据库创新生态大会“根”技术专场的演讲整理形成,主要对 YashanDB 共享集群近一年发布的新特性进行原理探讨与技术解析。
2023 年 11月 , YashanDB推出采用单库多实例架构的多活共享集群形态 ( YashanDB for Cluster,YAC ) ,并在今年 3月 , 崖山共享集群 也发布了长期维护的商用集群版本。 这一年 , YashanDB 持续在可用性、性能 /扩展性、内核稳定性以及易用性等多个维度增强产品能力,为 用户 市场打造一款高性能、高扩展、高可用的集群数据库产品。
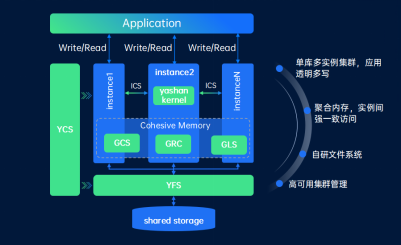
图 1 YashanDB 共享集群架构图
全新推出主备集群方案,更全面的容灾解决方案
共享集群本身提供了多维度的高可用能力,如计算节点的高可用能力、共享存储的存储高可用能力等。 更进一步 , YashanDB推出了主备集群方案,通过在共享集群上集成主备特性,为用户提供全面的高可用和容灾解决方案。
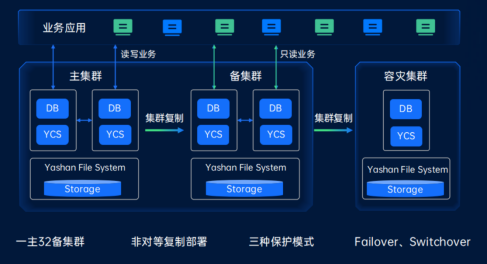
图 2 YashanDB 共享集群主备集群部署架构图
主备集群方案下,主、备集群是独立的两套集群,每个集群具备独立的集群管理软件、集群文件系统等组件,集群与集群之间通过集群日志复制方式进行同步。通常而言,主备集群部署在同城的两个数据中心,为了进一步增强容灾能力, 可以选择 在异地部署一套容灾集群。
为了进一步降低使用集群成本, YashanDB 支持主备集群非对等部署 方式 。 目前 YashanDB 最大支持一主 32备的部署方式 ,支持最大性能、最大可用、最大保护三种保护模式,支持备集群故障倒换和主备集群平滑切换。
YashanDB 主备集群 方案 在最新发布的 企业版 V23 LTS版本中就可以使用,并且会在接下来的版本中持续增强备集群的能力, 例如 备集群的只读、备份 、 多实例并行回放等 能力 。
统一集群存储架构,集群级存储高可用能力增强
新版本中对共享集群存储层面进行了增强 : 一是崖山集群文件系统( YFS ) 采用 全新的磁盘发现技术,可以对存储设备进行高效的管理以及使用 ; 二是 新版本对共享存储管理进行了重新定义,分为系统 DG和数据DG,将 崖山集群服务( YCS ) 使用的 vote文件、YCR文件统一纳入系统DG中管理,数据DG中管理集群数据库相关的数据文件、redo文件等。 如此能 通过统一的集群存储架构,提供集群级存储高可用能力,如校验、冗余、 IO均衡等。
此外, 通过存储多副本技术增强高可用能力: 一是 通过数据盘多副本冗余,可以为用户提供灵活的多重存储可靠性保障,任意存储数据损坏可以做到自动检测、自动修复 ; 二是 通过系统盘多副本冗余, YCS可以快速进行集群脑裂仲裁。

图 3 YashanDB 共享集群存储架构图
更快速的在线即时恢复技术, RTO 减少 30%
对于共享集群而言,节点故障在线恢复的时间至关重要。特别是 在业务繁忙期间,节点在线发生故障时,通常会累积大量的 redo日志,这导致在线恢复过程需要更长的时间。
在新版本中 , 我们 采用了 更快速的在线即时恢复技术 ,基于 YashanDB共享集群多节点多活的特点,当某个节点发生故障时,可以通过其他存活节点的在线实时日志分析,进行快速的恢复集构造, 在线故障恢复的 RTO时间减少30%。

图 4 在线故障即使恢复示意图
智能全局缓存刷盘技术,根据应用场景智能选择
全局缓存管理方面,基于应用透明以及应用划分两种典型的集群使用场景,全局缓存呈现不同的特征。
应用透明场景下 ,各实例缓存中的数据大部分呈现全局性的特点,当产生交叉修改时,会产生历史的脏数据版本,这里叫 PastCopy ( 简称 PC ) ,对应的 PC持有者叫做PC O wner。缓存中维护 PC 有两个作用 : 一个是用来做在线恢复的加速,节点在线故障不需要从磁盘中的老版本开始,只需要从内存中最新的 PC 版本恢复即可。另外一个作用是各实例下全局恢复点的推进 , 当各实例中存在大量全局脏页时,需要进行全局脏页刷盘的控制,避免出现页面版本错乱。
应用划分场景下 ,各实例缓存中的数据大部分呈现本地化的特点,多实例间的交叉修改、访问较少,此时修改产生脏页大部分是本地脏页。
在上一个版本中,统一采用 O wner刷盘机制进行全局缓存刷盘控制, 新版本中采用智能化全局缓存刷盘策略,根据应用场景自动采用不同的策略进行刷盘。

图 5 全局智能刷盘场景示意图
情形一: 如果大部分为本地脏页, O wner可以直接本地刷盘,不产生任何全局交互。
情形二: 全局脏页场景下, O wner节点进行刷盘,需要通过资源主节点进行刷盘控制,并在 O wner刷盘后丢弃历史的 PC 版本,这些历史版本已经不再需要。
情形三: 全局脏页场景下, PC O wner会优先请求Owner进行刷盘,保证每次刷盘收益最大化。
情形四: 当 O wner 所在 IO 实例 繁忙, PC O wner在缓冲区淘汰、本地 c heckpoint等一些特定的场景下需要进行快速刷盘时,采用就近PC Owner刷盘策略。
通过智能全局缓存刷盘技术,可以做到缓冲区的快速淘汰,大大提升 c heckpoint性能,同时提升全局脏页在各个实例间的传输效率,并且避免了特定场景集中到Owner节点刷盘,均衡多实例的IO负载。
发布 4 节点共享集群,性能高达 520 万 tpmC
YashanDB今年发布了4节点共享集群,并且4节点的性能达到了520W,线性扩展比0.7。
国内这几年做共享集群的很多,为什么 YashanDB可以做到性能的线性扩展 ?
( 一)崖山自研对等集群内核架构
最核心的是崖山采用了对等集群内核架构 。
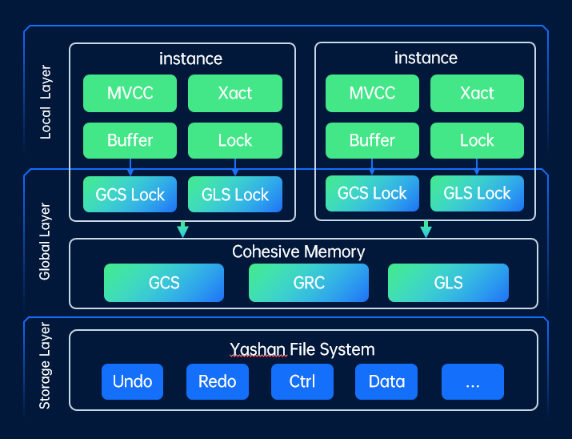
图 6 对等集群内核架构图
一是去中心化事务引擎,所有实例完全对等。 每个实例具备独立的事务引擎 、 缓冲区管理、锁管理等,所有实例完全对等,不存在中心化节点,而那些采用中心化设计的会存在一个显而易见的问题就是随着节点规模的增加,主控制节点的负载会越来越重。
二是 基于时间戳的轻量级 全局 快照技术 。 同样是实现高性能集群的基石,通过事务提交批量异步 broadcast SCN,消息交互lamport LSN,避免了大并发下的全局快照锁问题,同时保证各实例实时的事务一致性和正确性。
三是采用 页内锁技术 ,锁随着页面的转移而转移,不需要全局事务锁来做事务并发控制。
这几点是很多开源数据库以及基于开源数据库体系的生态所不具备的。
( 二)崖山自研聚合内存技术,支持多节点扩展
崖山的全局内存融合技术设计同样考虑了多节点下的扩展性 。
一是 采用 Request、Master、Owner的消息交互模型,每次消息交互最多三个节点参与,不受节点规模增加影响。
二是 采用自适应多节点一致性读策略转换 。 举个例子一个实例会低概率访问另外一个实例的数据,常规情况下是获取持有实例的一致性读页面副本而不会真正申请并持有资源,但当短时间出现大量访问时可以自动转换为请求页面资源,后续直接访问本地缓存,不需要进行跨节点访问,进而提升访问性能。
( 三)崖山针对国产平台优化集群性能
YashanDB 针对国产平台进行了优化 。 在 数据库层面, 针对热点变量、锁进行优化,减少跨 NUMA 下的冲突访问 ; 内核层面, 进行进程 /线程、网卡队列绑核,充分利用CPU资源。
内核能力持续增强,更可靠、更易用、易运维
除了性能外, YashanDB 在可靠性、易用性、易运维等多个方面进行了增强,提升用户使用体验,降低 运维 成本。
可靠性方面,各组件多维度优化。 全方位优化 ICS ,包括消息重试、保序、去重,提升在各类网络环境下的稳定性; YFS新支持快速恢复区 ,存储故障可以通过恢复区进行快速恢复; 新增 YCS守护进程YCS monitor ,增强集群管理软件自身的可靠性。
易用性方面,提升集群的使用体验。 新增自适应参数调优 , 对私网消息内存管理,集群后台服务线程调度等集群相关的参数做了优化,基于业务负载、系统可用资源自动调优相关参数,新版本中不需要用户手动配置,降低用户使用集群的成本; YFS新支持在线磁盘管理 ,可以在线添加、删除修改磁盘,方便进行存储管理。
易运维方面,提供精细化运维手段。 一是 GV视图增强 ,所有 V视图对应的GV视图已全部支持,同时GV视图支持各种复杂的关联查询; 二是提供了全局资源历史变化的追踪 ,以及全局资源信息的导出,方便进行集群的运维和分析。
总结与展望
总结来看 , 崖山共享集群全新的版本主要在高可用、高性能以及内核能力等维度做了全方位的增强,进一步提升了用户的使用体检。
崖山共享集群后续会重点考虑以下几个方向:
支持集群在线弹性伸缩。 基于应用负载,计算节点秒级弹性扩缩,降低用户的运营成本,并且支持共享存储在线升级、在线扩容、 IO负载均衡等。崖山预计在25年版本推出集群在线弹性伸缩。
支持集群多机执行。 面向服务亲和的场景,提供对象级亲和全局缓存服务,降低全局资源跨节点的访问代价。同时基于一定的集群数据分布特点,推出集群多机执行能力,让计算在数据亲和的节点节点进行,提升计算效率。
优化集群云化与多租场景的性能。 云化与多组场景下,主要解决高延迟、低带宽下的读写优化以及集群在线节点故障如何快速恢复,集群面向多租的资源管理以及负载均衡。
在一体机形态下进一步做软硬协同优化 。 主要有计算能力硬件下推,就近数据端借用硬件技术加速。基于存储的容灾、快照、压缩、加密等技术。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70043300/viewspace-3073721/ ,如需转载,请注明出处,否则将追究法律责任。

