
今天我们接着昨天的话题继续聊下去

第二个是通信方式
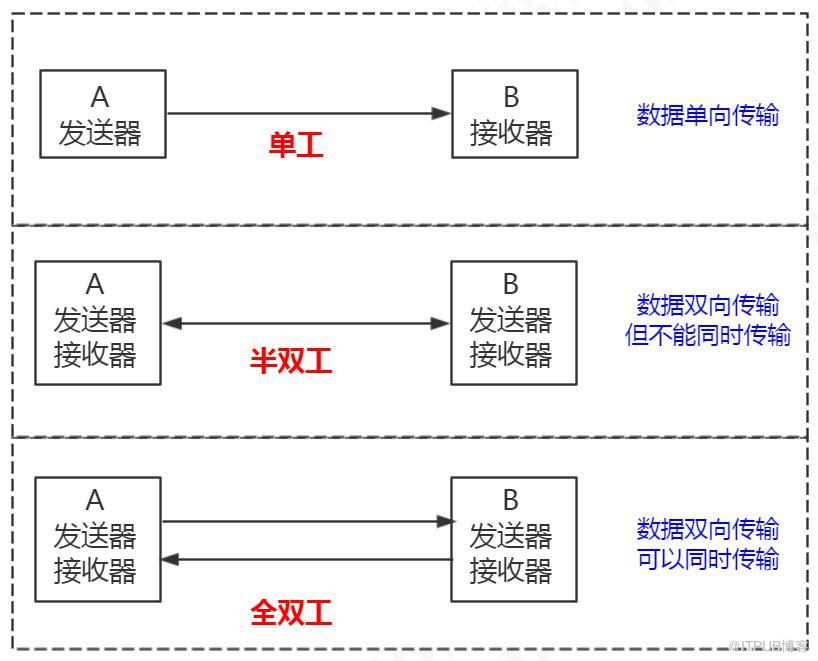
单工:
在两台计算机通信的时候,数据的传输是单向的。生活中的类比:遥控器。
半双工:
在两台计算机之间,数据传输是双向的,你可以给我发送,我也可以给你发送,但是在这个通讯连接里面,同一时间只能有一台服务器在发送数据,也就是你要给我发的话,也必须等我发给你完了之后才能给我发。生活中的类比:对讲机。
全双工:
数据的传输是双向的,并且可以同时传输。生活中的类比:打电话。
MySQL 使用了半双工的通信方式?
要么是客户端向服务端发送数据,要么是服务端向客户端发送数据,这两个动作不能同时发生。所以客户端发送 SQL 语句给服务端的时候,(在一次连接里面)数据是不能分成小块发送的,不管你的 SQL 语句有多大,都是一次性发送。
比如我们用MyBatis动态SQL生成了一个批量插入的语句,插入10万条数据,values后面跟了一长串的内容,或者 where 条件 in 里面的值太多,会出现问题。
这个时候我们必须要调整 MySQL 服务器配置 max_allowed_packet 参数的值(默认是 4M),把它调大,否则就会报错。

另一方面,对于服务端来说,也是一次性发送所有的数据,不能因为你已经取到了想要的数据就中断操作,这个时候会对网络和内存产生大量消耗。
所以,我们一定要在程序里面避免不带 limit 的这种操作,比如一次把所有满足条件的数据全部查出来,一定要先 count 一下。如果数据量的话,可以分批查询。
执行一条查询语句,客户端跟服务端建立连接之后呢?下一步要做什么?

MySQL 内部自带了一个缓存模块。
缓存的作用我们应该很清楚了,把数据以 KV 的形式放到内存里面,可以加快数据的读取速度,也可以减少服务器处理的时间。但是 MySQL 的缓存我们好像比较陌生,从来没有去配置过,也不知道它什么时候生效?
比如 user_innodb 有 500 万行数据,没有索引。我们在没有索引的字段上执行同样的查询,大家觉得第二次会快吗?
select * from user_innodb where name='青山';
缓存没有生效,为什么?MySQL 的缓存默认是关闭的。
show variables like 'query_cache%';
默认关闭的意思就是不推荐使用,为什么 MySQL 不推荐使用它自带的缓存呢?
主要是因为 MySQL 自带的缓存的应用场景有限,第一个是它要求 SQL 语句必须一模一样,中间多一个空格,字母大小写不同都被认为是不同的的 SQL。
第二个是表里面任何一条数据发生变化的时候,这张表所有缓存都会失效,所以对于有大量数据更新的应用,也不适合。
所以缓存这一块,我们还是交给 ORM 框架(比如 MyBatis 默认开启了一级缓存),或者独立的缓存服务,比如 Redis 来处理更合适。
在 MySQL 8.0 中,查询缓存已经被移除了。
原文作者:IT枫斗者;如有侵权,请联系管理员删除。

