大家好,我是雨飞。
就在今天,OpenAI 发布了自己旗下首个视频生成模型 Sora。它能够根据文本指令生成逼真和富有想象力的视频场景,具体来说,Sora是一个文本到视频的模型,能够生成长达一分钟的视频,同时保持视觉质量和对用户提示的忠实度。
下面是几个官方给出的演示视频,从实际效果来看,确实十分炸裂。

提示词:一位时尚女性走在充满温暖霓虹和动态城市招牌的东京街头。她穿着黑色皮夹克,一条长款红色连衣裙,黑色靴子,手里拿着黑色手提包。她戴着墨镜,涂着红色口红。她自信而随意地走着。街道潮湿而反光,形成了彩色灯光的镜面效果。许多行人在周围走动。
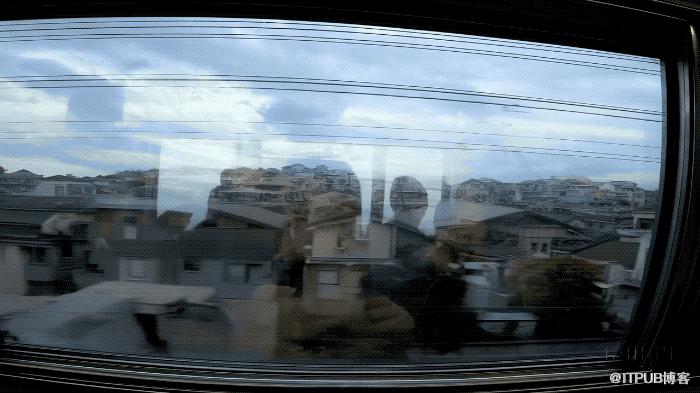
提示词:一列火车穿过东京郊区,车窗上反射出周围景象
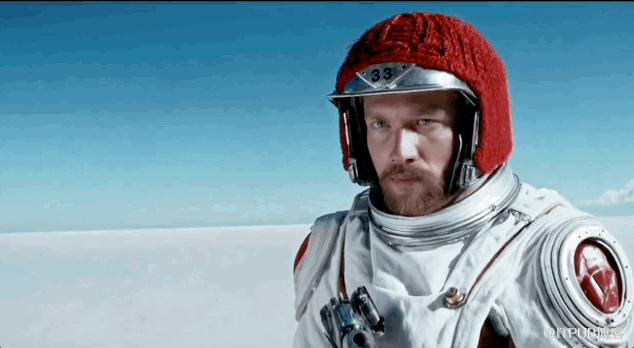
提示词:一部电影预告片,讲述了一位30岁的太空人戴着红色羊毛编织摩托车头盔的冒险故事,背景是蓝天和盐漠,采用电影风格拍摄,使用35毫米胶片,色彩鲜明
OpenAI在介绍文章以及后面的技术blog中提到了Sora模型的关键技术以及目前的局限性,简单总结如下。
文本理解:Sora能够深入理解语言,准确解释提示并生成具有丰富情感表达的角色。
视频生成:模型能够一次性生成整个视频,或者通过扩展现有视频来增加长度。它能够确保即使在主体暂时离开视野时,也能保持一致性。
变换器架构:Sora采用了类似于GPT模型的变换器架构,这使得它在扩展性能上表现出色。
数据表示:Sora将视频和图像表示为较小的数据单元(patches),类似于GPT中的标记。这种统一的数据表示方法使得模型能够训练在更广泛的视觉数据上,包括不同的时长、分辨率和宽高比。
研究技术:Sora是一个扩散模型,通过从静态噪声开始,逐步去除噪声来生成视频。它还能够从现有的静态图像生成视频,或者扩展现有视频。
安全措施:OpenAI正在采取重要的安全步骤,包括与领域专家合作进行对抗性测试,以及开发工具来检测误导性内容。他们还计划在未来的产品中包含C2PA元数据。
局限性:尽管Sora在模拟复杂场景的物理和特定因果关系方面存在局限性,例如可能无法准确模拟物体的物理交互(如饼干被咬后没有痕迹),或者在处理涉及多个实体的场景时可能出现问题。
正如OpenAI在技术博客上所说,我们相信,Sora 今天所拥有的能力证明,不断扩大视频模型的规模,是开发物理和数字世界以及其中的物体、动物和人的功能模拟器的一条大有可为的道路。
参考资料
https://openai.com/sora
https://openai.com/research/video-generation-models-as-world-simulators
好了,今天的分享就到这里啦,感谢阅读。
福利早知道
AI破局星球,年后开启拉新,V我50锁定名额,可以免费享有我的年度陪伴群+大模型基础学习手册+老徐提供的7项福利。星球原价699元,提前锁定名额,可以享受最低价加入,还有机会抽奖获取更多福利。
如果你想探索自己的副业,对AI感兴趣,或者想尝试结合AI去做副业,赚点小钱,可以考虑入:


交个朋友
欢迎加我微信 1060687688, 备注「围观群」可以免费加入我的AI和副业围观群。
回复571,免费领取 2G 的AI大礼包,大冲副业从0到60万的可复制路径。
永久免费星球『算法·成长·一人企业』,在这里我会高频输出和算法,个人成长,副业相关的知识以及资源分享。希望,对你有帮助。
END
你的每一个『点赞』,都是鼓励我进步的勇气,点个『在看』,加油吧,一起成长!
原文作者:雨飞AI笔记;如有侵权,请联系管理员删除。

