导读
在大型语言模型(LLM)推理中,KVCache 是提升效率的核心机制:通过缓存 Transformer 自注意力层的历史 Key-Value 对,避免重复计算,显著降低单次推理开销。然而,在“智能体式推理”(Agentic Inference)这一新兴范式下——模型需持续感知环境、进行多轮决策、自我反思,并协同其他智能体完成复杂任务——传统 KVCache 机制暴露出三大关键瓶颈:
- 状态膨胀:长上下文交互导致缓存显存占用指数级增长;
- 跨轮次持久化缺失:会话状态难以有效延续,影响推理连贯性;
- 多任务/多智能体间缓存孤立:缺乏共享机制,造成冗余计算与决策冲突。
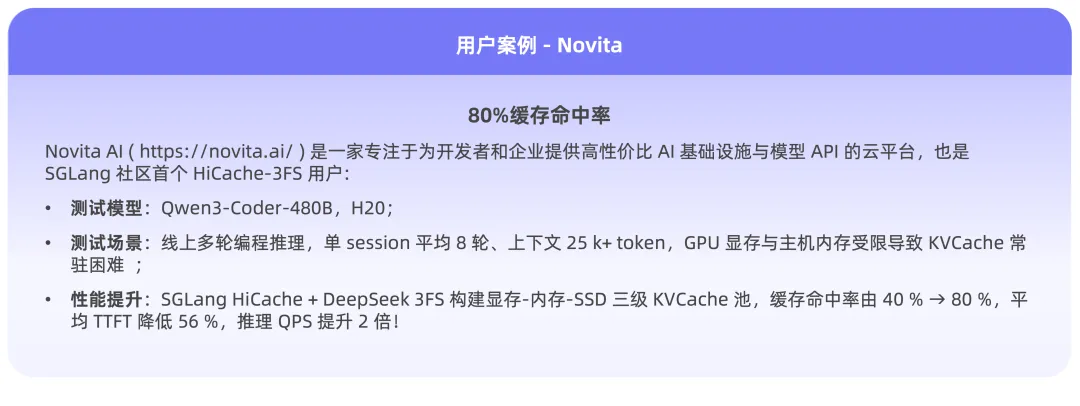
为应对上述挑战, 阿里云 Tair KVCache 团队与 SGLang 社区、Mooncake 团队展开深度合作,共同构建了面向智能体推理的下一代缓存基础设施: 显存 – 内存 – DeepSeek 3FS 的多级 KVCache Offloading 和全局共享(Global Sharing)。在 Novita AI 等真实生产场景中,该方案已实现显著性能跃升,缓存命中率由 40 % → 80 %, 平均 TTFT 降低 56 %,推理 QPS 提升 2 倍。
本系列技术文章将系统性拆解面向智能体推理的KVCache技术演进路径:
1. 本文|智能体式推理对 KVCache 的挑战与 SGLang HiCache 技术深度剖析;
2. 3FS-KVCache 产品化实践:企业级部署、运维与性能调优最佳实践;
3. Hybrid Model Support:SGLang 对 Mamba-Transformer 等混合架构模型的支持方案;
4. Tair KVCache Manager:企业级全局 KVCache 管理服务的架构设计与实现;
5. KVCache 仿真分析:高精度的计算和缓存模拟设计与实现;
6. Hierarchical Sparse Attention:分层稀疏注意力框架下的 KV 分层管理与按需加载;
7. 展望:KVCache驱动的软硬结合演进。
Tair KVCache作为阿里云数据库Tair产品能力的延伸,本质是缓存范式的三次跃迁:
🔹 从 Redis 的 “缓存数据 → 减少 I/O”
🔹 到 GPU KVCache 的 “缓存计算中间态 → 减少重复计算”
🔹 再到 Tair KVCache 的 “规模化、智能化的注意力状态管理 → 重构大模型推理成本模型”它标志着缓存正从辅助组件升级为 AI 基础设施层的核心能力——让“状态”可存储、可共享、可调度,支撑智能体时代的规模化推理底座。
1.引言
1.1 自回归的代价:KVCache 的诞生
大语言模型的推理本质上是一个自回归(Autoregressive)过程:模型逐个生成 token,每一步都需要"回顾"此前已生成的全部上下文。这一机制保证了语义的连贯性,却也带来了显著的计算冗余。
问题的核心在于 Attention 机制。在生成每个新 token 时,模型需要用当前 token 的 Query(Q)与所有历史 token 的 Key(K)进行点积运算,计算出注意力权重后,再对历史 token 的 Value(V)进行加权聚合。然而,历史 token 对应的 K 和 V 一旦生成便不再改变——如果每次解码都重新计算它们,将造成大量不必要的重复开销。

KVCache 正是为解决这一问题而生:在计算每个 token 的 K 和 V 后将其缓存,后续生成步骤直接复用,从而避免重复的前向传播计算。这一优化显著降低了推理延迟、提升了吞吐效率,已成为现代大语言模型实现高效推理的基础技术。
1.2 再遇瓶颈:"以存代算"破解KVCache的容量挑战
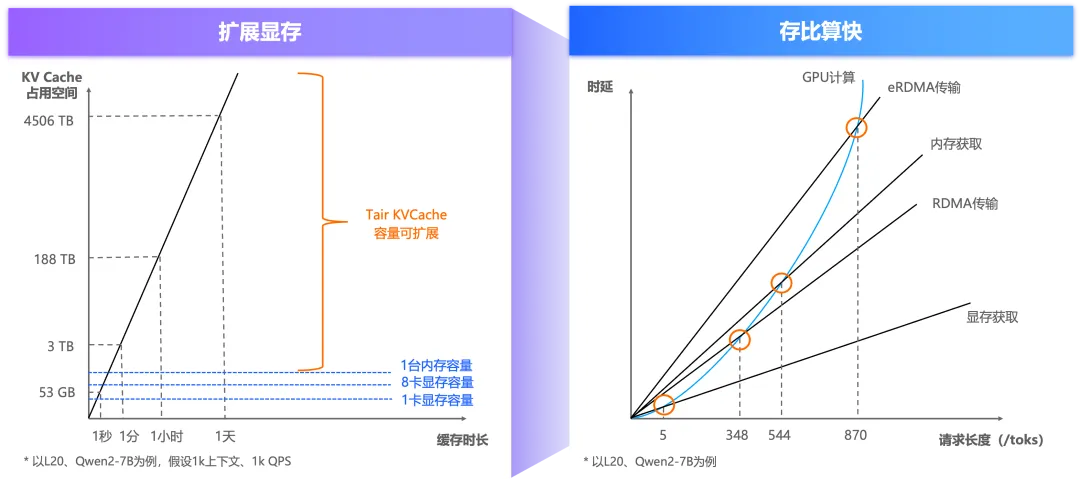
KVCache在带来性能收益的同时,也引入了新的瓶颈——存储容量。
如左图所示,以 Qwen2-7B 模型为例,在千级 QPS、平均 1K 输入的在线服务场景下,叠加多轮对话的状态保持、Prefix Caching(前缀复用)等需求,KVCache 总量随缓存时长呈线性增长—— 从秒级的 GB 量级迅速膨胀至天级的 PB 量级,远超本地显存乃至主机内存的承载上限。
右图则揭示了一个关键洞察: 以存代算。当序列长度超过一定阈值后,从存储介质中加载已缓存的 KV,其端到端延迟反而低于 GPU 重新执行 Prefill 计算。这为 KVCache Offloading 提供了坚实的理论依据——将低访问频次的 KV 状态从 GPU 显存逐级卸载至主机内存、甚至通过 RDMA 卸载至远端分布式存储池,既能突破单机容量瓶颈,又能保证加载延迟低于重算开销。
这一"用存储换计算"的策略,为长上下文、高并发的 LLM 推理服务提供了兼顾吞吐、延迟与成本的可扩展路径。
1.3 爆发的长文本:Agentic Inference 的兴起
从 OpenRouter 最近发布的 报告上指出,"当前,LLM 在实际生产中的应用正经历一场根本性转变:从单轮文本补全,转向多步骤、工具集成、强推理驱动的工作流。我们将这一转变称为“智能体式推理”(agentic inference)的兴起——即模型不再仅用于生成文本,而是被部署为能够主动规划、调用工具、并在延展上下文中持续交互的“行动者”。其中最关键的包含序列长度分布的变化,以及编程类应用场景如何推动整体复杂性提升"。
1.3.1 上下文窗口极大延长(Long Context Explosion)
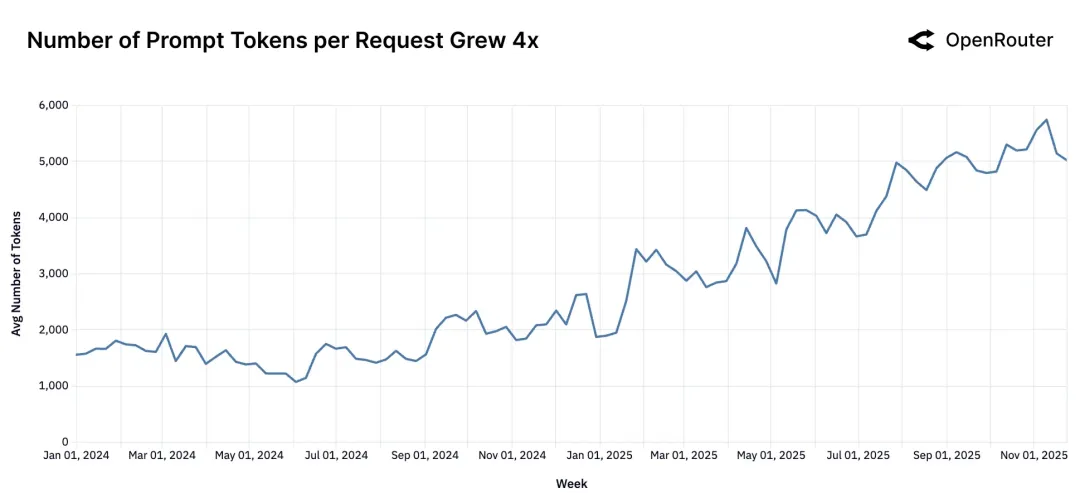
AI Agent 需要记忆长期、跨轮次、多任务的上下文,例如:多轮工具调用的完整 trace、用户历史偏好与行为日志、多文档协同分析(如合同+财报+邮件)多智能体协作中的 shared memory。 这使得上下文长度从传统 chat 的几百~几千 tokens,跃升至数万乃至百万 tokens。在这个场景下因为KVCache 大小与上下文长度呈线性增长,推理服务很容易碰到显存容量的扩展瓶颈。
1.3.2 编程类应用场景

编程类应用Agent 通常以 “ 思考-行动-观察”循环运行,每轮新增少量 token(如工具调用结果),但需 保留全部历史 KV 以维持状态一致性。传统一次性推理KVCache生命周期为单次请求,在Agent 推理场景KVCache生命周期为 整个会话甚至数小时。要求 KVCache 持久驻留、支持增量 append,而非每次重算。
编程的交互更接近“人–人”对话节奏,用户容忍延迟更低(目标:<500 ms 端到端)。无 KVCache 时,每生成一个 token 需重算全部历史O(n²) 复杂度;有 KVCache → O(n) → 对超长上下文至关重要。并且随着轮次的增长上下文长度的变化,避免重复计算节省成本也是当前应用最为关注的要点。
一个 Agent 实例常需 并发处理多个用户/子任务,而不同任务可能共享部分上下文(如同一用户的不同 query 共享 profile,多个子 Agent 共享环境状态,prompt template 或 system instruction 复用)需要通过 KVCache 共享/复用机制(如 prefix caching、cross-request reuse),可大幅降低重复计算与内存占用。
1.4 突破显存墙:Hierarchical KVCache(HiCache)的破解之道
针对智能体式推理碰到 上下文窗口极大延长,持续交互与流式推理,多任务并发与共享缓存,实时性要求提升的诸多挑战。SGLang HiCache 构建了一套分级(Hierarchical)的 KVCache 管理体系,将 GPU 显存、主机内存、本地磁盘乃至远端分布式存储(如 3FS)统一纳入缓存层次结构。通过智能的热度感知调度与异步预取机制,HiCache 能够在容量受限的显存中保留高频访问的"热"数据,同时将"冷"数据透明地卸载至更大容量的下层存储,在请求到来前及时加载回显存参与计算。这一设计使得 SGLang 推理系统得以突破单机硬件的物理边界,以近乎线性的方式扩展有效缓存容量,真正释放"以存代算"的潜力。
另一方面,实现高效的 KVCache Offloading,离不开一套高性能的底层存储系统。3FS(Fire-Flyer File System) 是 DeepSeek 开源的分布式文件系统,专为 AI 大模型训练与推理场景设计,具备以下核心特性:
- 存算分离架构:计算与存储解耦,便于独立扩展;
- 吞吐性能:结合 RDMA 网络与 NVMe SSD,在 180 节点集群中可达 6.6 TiB/s 读取带宽;
- 强一致性保障:基于 CRAQ 链式复制协议,兼顾一致性与高可用;
- 灵活的访问接口:提供 POSIX 兼容的 FUSE 客户端与高性能 USRBIO 接口,兼顾易用性与性能。
Tair KVCache团队将 3FS 集成至 SGLang HiCache 体系,为 KVCache 提供高带宽、低延迟的 Offloading 通道,同时实现跨节点的全局缓存复用能力。
2.从“复用”到“分层”的演进:SGLang PrefixCache介绍
Radix Tree & HIRadixTree 深度介绍:
2.1 Prefix RadixTree:前缀复用的艺术
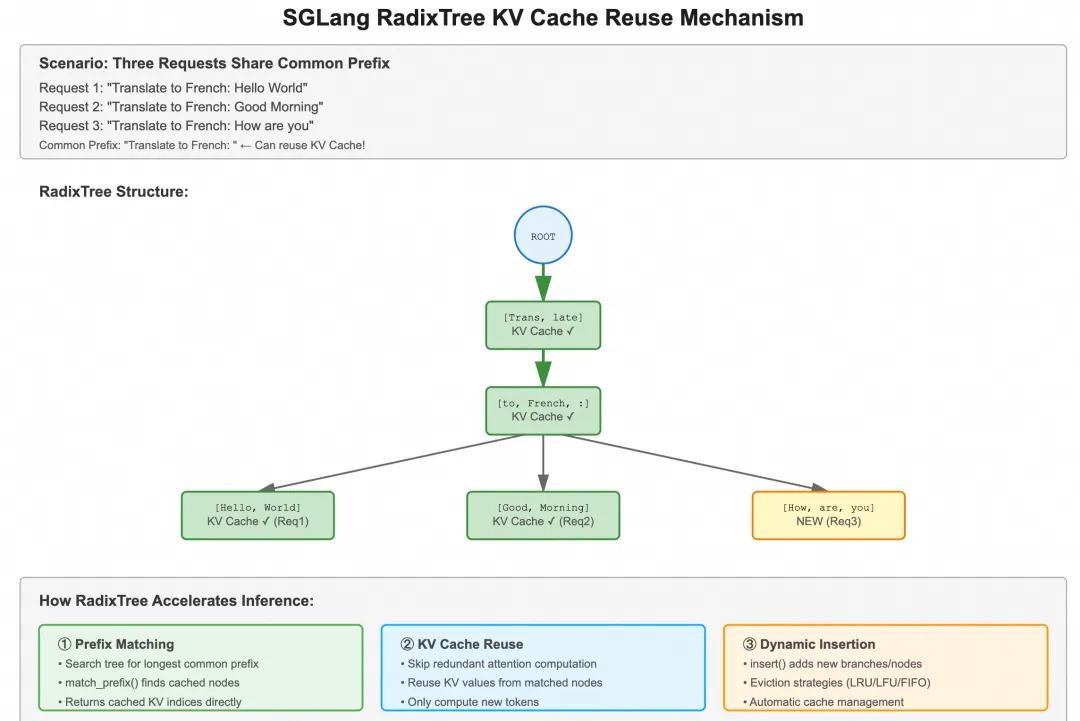
在 LLM 推理服务中,重复计算相同的文本前缀是一个巨大的性能浪费。
设想这样一个场景:在 阿里云的企业级 AI 助手服务中,所有用户请求都以相同的系统提示词(System Prompt)开头——可能是上千 token 的角色设定与规则说明。传统的 KVCache 机制以请求为单位独立管理,即便这些前缀完全相同,每个请求仍需重新执行一遍 Prefill 计算,造成大量冗余开销。
SGLang 的 RadixTree 正是为解决这一痛点而生。RadixTree(基数树)是一种高效的前缀检索数据结构,SGLang 利用它来管理和索引所有已缓存的 token 序列。当新请求到达时,系统在 RadixTree 中检索其 token 序列,找到与已缓存序列的最长公共前缀,直接复用对应的 KVCache,仅对剩余的新增 token 执行 Prefill 计算。
这一优化在以下场景中效果尤为显著:
- 共享系统提示词:大量请求复用相同的 System Prompt;
- 多轮对话:同一会话的后续轮次天然共享历史上下文;
- AI Coding:代码补全场景中,同一文件的多次请求共享大量代码上下文;
通过前缀复用,RadixTree 可将 SGLang Prefill 阶段的计算量降低数倍乃至数十倍,显著提升吞吐并降低首 Token 延迟(TTFT)。
2.2 HIRadixTree:突破显存边界的分层缓存
RadixTree 解决了"如何复用"的问题,但并 未解决"能缓存多少"的问题—— KVCache 仍受限于 GPU 显存容量。
随着 Agentic AI、长文档问答、代码仓库级理解等任务的兴起,请求上下文长度持续增长,缓存容量直接决定了命中率,进而影响系统吞吐与响应延迟。单张 GPU ~100GB 的显存,在面对海量并发长上下文请求时捉襟见肘。
为此,我们在 SGLang 中设计并实现了 HIRadixTree(Hierarchical RadixTree, 下文简称 HiCache)-- 一套分层级的 KVCache 管理机制,将原本局限于 GPU 显存的 RadixTree 扩展为三层存储架构:
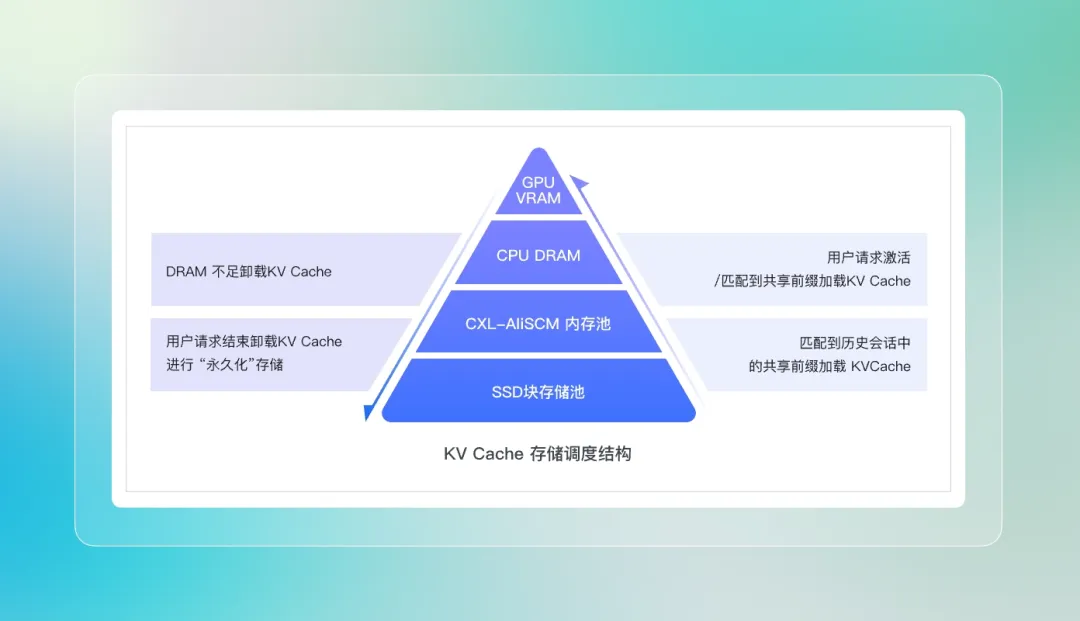
其核心工作机制如下:
-
自动卸载(Offload):系统根据访问热度将高频 KVCache 异步卸载至 CPU 内存;随后进一步持久化至本地磁盘或远程分布式存储(如 3FS);
-
智能预取(Prefetch):当请求命中远端缓存时,系统在实际计算前异步预取所需 KV 数据至 GPU 显存,最大程度隐藏 I/O 延迟;
-
热度感知驱逐(Eviction):结合 LRU 等策略,优先保留高频访问的"热"数据于显存,确保缓存命中率最大化;
通过这一分层设计,原本仅有 40GB 显存的 GPU 可借助 CPU 内存扩展至 200GB+ 的有效缓存容量,进一步结合存储层可支持 TB 级别的超长上下文缓存。HIRadixTree 在保持 RadixTree 高效前缀检索能力的同时,真正实现了近乎无限的 KVCache 容量扩展,为长上下文、高并发的 LLM 推理服务提供了坚实的基础设施支撑。
3.如何让远端存储像本地显存一样快:HiCache 架构详解
本节中将会详细介绍 HiCache 体系中的技术细节。
3.1 系统架构设计
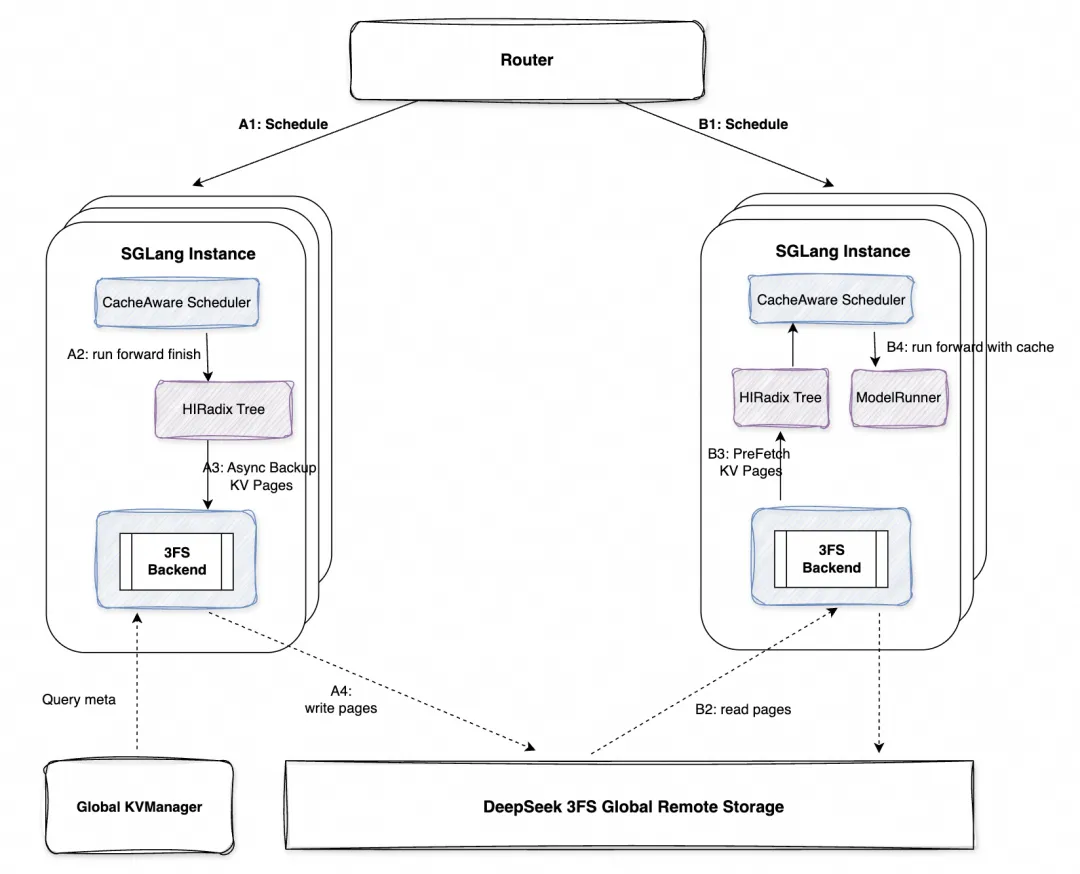
模块功能说明:
-
HiRadixTree:GPU/CPU 双层前缀缓存树结构,原生支持 KVCache 在 GPU 与 CPU 之间的自动同步
-
Storage Backend:可插拔的存储后端抽象层,当前已集成 3FS、Mooncake、NIXL 等后端实现。通过统一接口封装 batch_get / batch_set / batch_exists 等操作,支持零拷贝数据传输,兼顾高吞吐与低延迟
-
Global KVManager:提供分布式文件系统(FS)的元数据统一管理服务,具备高效的元数据组织、查询与协调能力,为全局 KVCache 提供一致性管理
-
3FS Global Storage: DeepSeek 开源的高性能分布式文件系统,采用存算分离架构,结合 RDMA 网络优化与 NVMe SSD,提供 TiB/s 级别的聚合读取带宽,作为 HiCache 的持久化存储底座。
3.2 KVCache 流水线预取与计算重叠
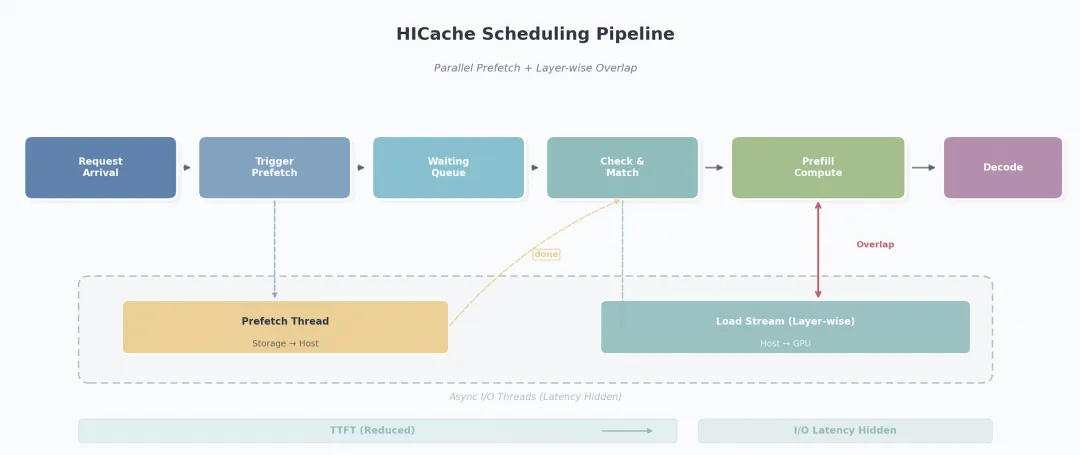
在原始调度模式下,请求从入队到首 Token 生成需要经历"等待 → 前缀匹配 → 显存分配 → Prefill 计算"全流程,其中 KVCache 仅存在于 GPU 显存。HiCache 模式通过引入三层存储架构与异步流水线,实现了两个关键优化:
1. 预取与等待并行:
- 请求入队时即触发 prefetch_from_storage,在等待调度期间,后台线程已将 Storage 中命中的 KV 数据异步加载至 Host 内存,有效利用排队等待的"空闲"时间;
- Scheduler 调度到请求时根据调度策略终止请求prefetch/跳过请求调度。支持的调度策略:
- Best_effort:尽力而为,当调度到请求r时,如果r仍在prefetch则终止r,调度进入推理;
- Timeout:基于预计耗时终止请求,当调度到请求r时,如果r仍在prefetch且耗时超过预定义阈值则终止r,否则跳过r的调度本轮不进行推理;
- Wait_complete:prefetch 完所有kvcache才进入推理调度,否则跳过。
2. 加载与计算 Overlap:当请求被调度执行时,Host → GPU 的 KV 加载通过独立 CUDA Stream 逐层进行(load_to_device_per_layer),模型前向计算可在第 i 层 KV 就绪后立即开始,无需等待全部层加载完成,实现计算与传输的流水线重叠。
这一设计将原本阻塞的 I/O 开销隐藏于调度等待与 GPU 计算之中,在显著扩展有效缓存容量的同时,最大程度降低了对首 Token 延迟(TTFT)的影响。
3.3 基于Page/Layer布局变换的零拷贝传输
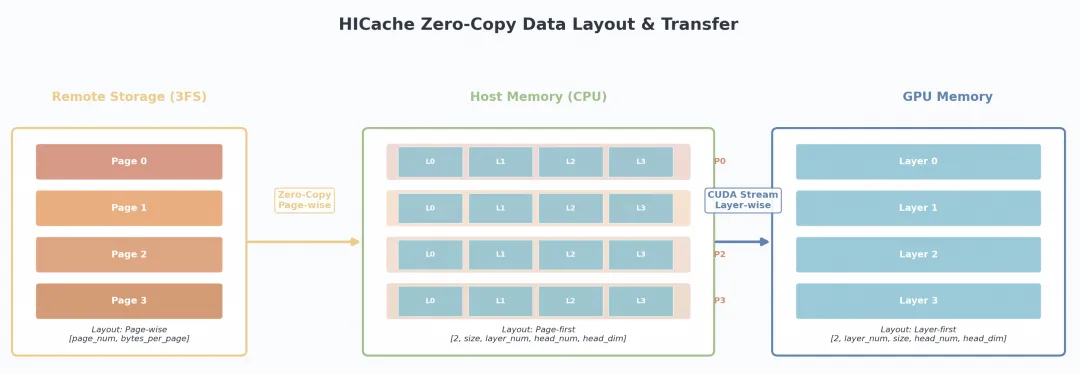
HiCache 采用零拷贝(Zero-Copy) 技术实现 KVCache 的高效跨层传输。
在数据布局上:
- 远端存储按 Page 组织,每个 Page 有一个独立的 Prefix Hash Key 用于检索
- Host 内存采用
Page-first 布局([2, size, layer_num, head_num, head_dim]),使得同一 Page 内所有 Layer 的数据物理连续;
- GPU 显存则采用 Layer-first 布局([2, layer_num, size, head_num, head_dim]),便于按层访问
- 在传统 Layer-first 布局([2, layer_num, size, ...])下,同一 Page 的 KV 数据分散在各 Layer 的不同内存区域,写入存储前必须先执行 .flatten().contiguous() 将数据拷贝重组为连续块。而 Page-first 布局([2, size, layer_num, ...])将 size 维度前置,
使得同一 Page 内所有 Layer 的数据在内存中物理连续,可直接写入存储或从存储读取,无需额外的数据重组拷贝
传输路径上:
- Storage → Host 采用 Page-wise 粒度,通过 3FS libusrbio 等用户态 I/O 库将数据直接写入 Host KV Pool,绕过内核缓冲区;
- Host → GPU 则采用 Layer-wise 粒度,通过独立 CUDA Stream 逐层传输,使得模型前向计算可以在第 i 层数据就绪后立即开始,实现计算与传输的流水线重叠。这一设计在最大化存储带宽利用的同时,将数据加载延迟有效隐藏于 GPU 计算之中。
-
Page-first 布局在 Host 层充当"桥梁",既满足存储层的 Page 连续性要求,又通过转置支持 GPU 层的 Layer 访问模式,以一次布局转换换取传输路径上的零拷贝收益。
3.4 Prefill与Decode分离架构的集成
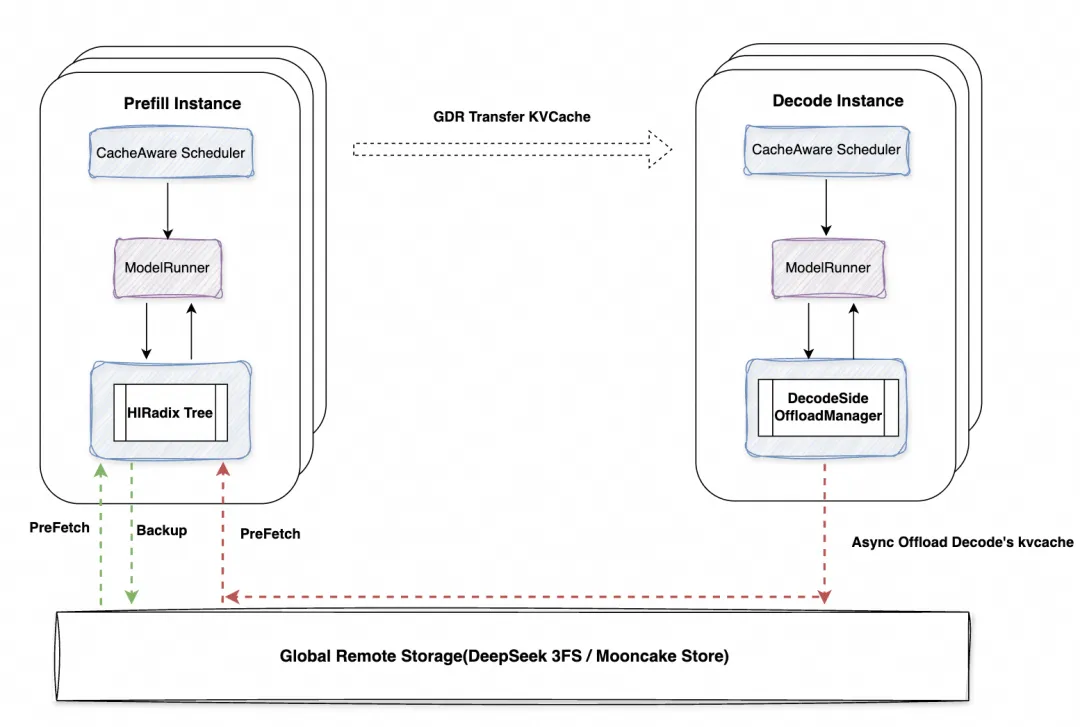
目前,SGLang 的 PD(Prefill/Decode)分离架构已与 HiCache 实现无缝集成,KVCache 的全生命周期管理流程如下:
1. 高速直传:Prefill 与 Decode 节点之间通过 GDR(GPU Direct RDMA)高速通道实现 KVCache 的零拷贝直接传输
2. Prefill 跨实例复用:支持 Prefill 启用 HiCache,实现 KVCache 的异步 Offload 与 Prefetching及跨实例的 KVCache 复用
3.
Decode 节点轻量缓存控制:出于历史兼容性考虑,Decode 节点默认关闭 HiCache;为此新增轻量级组件
DecodeOffloadManager,专门负责异步 Offloading 操作。在多轮对话场景中,Prefill 节点可直接复用 Decode 节点已生成的 KVCache,避免重复计算,从而在 PD 分离架构下达成与非分离部署同等的缓存效率与性能表现。
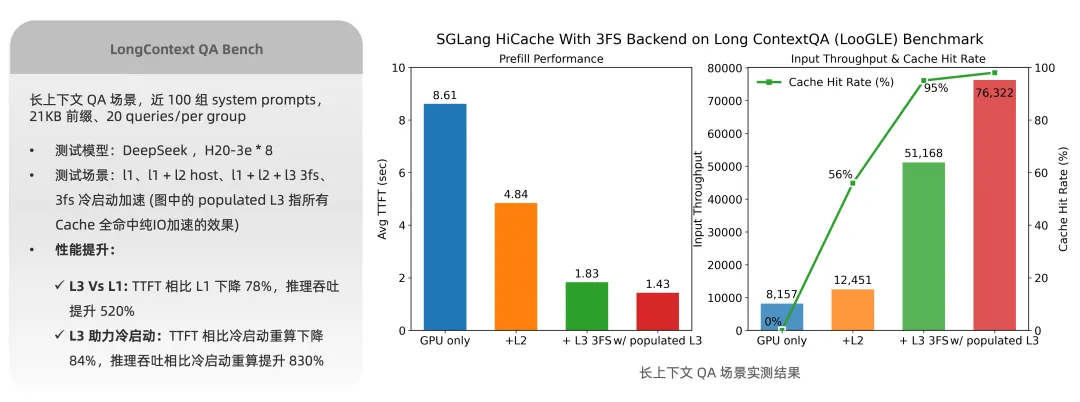
3.5性能实战 (3FS Backend)
4.后续工作预告
4.1 HiCache Roadmap
4.1.1 Roadmap
SGLang HiCache 项目仍在积极建设中,未来将围绕以下方向持续演进,欢迎社区共建:
🔹 深度集成 EPD 架构:支持 Embedding Node 与 Prefill Node 之间通过 HiCache 高效传输 Embedding Cache
🔹 支持 Sparse Attention:适配 DeepSeekV32 等模型
🔹 支持 Hybrid 模型:适配支持 Mamba、SWA 等 Hybrid Model
🔹 更智能的调度策略:基于 band usage、error_rate 等实时指标,动态调控 backup/prefetch 速率,提升缓存效率与资源利用率
🔹 完善可观测性体系:丰富监控指标,提供更全面、细粒度的性能洞察,助力问题诊断与调优
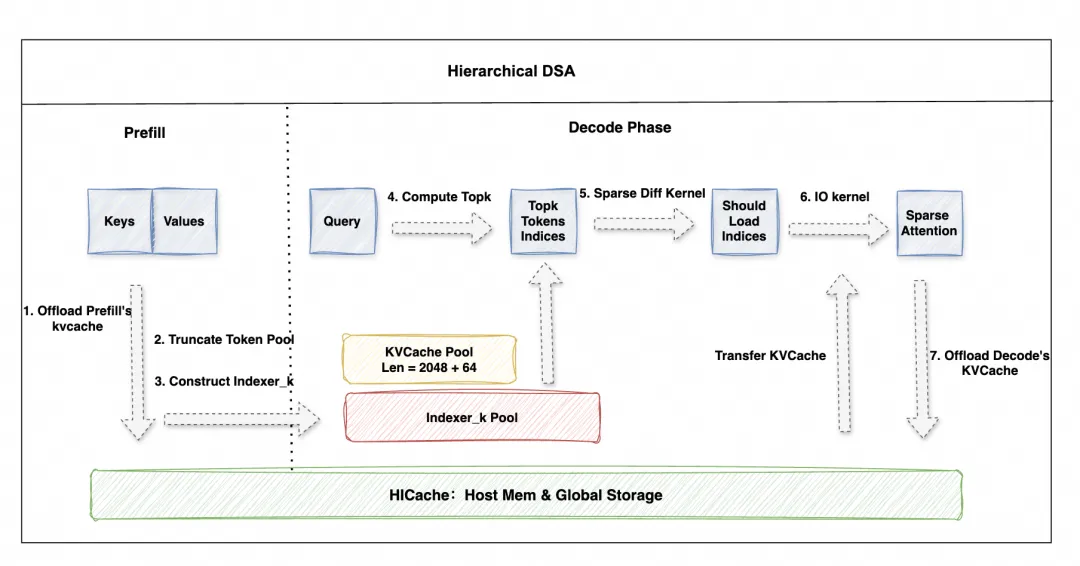
4.1.2 Hierarchical Sparse Attention
随着上下文长度持续增长,稀疏注意力(Sparse Attention) 成为提升长文本推理效率的重要技术路径——通过仅选取对当前预测关键的少量 token 参与注意力计算,在几乎不损失精度的前提下大幅降低计算开销。DeepSeek 提出的 NSA(Native Sparse Attention) 即为这一方向的代表性工作。
然而,现有稀疏化方案仍需 在 GPU 显存中保留全量 KVCache,长上下文场景下的显存瓶颈依然存在。为此,我们正在 SGLang 中构建分层稀疏注意力框架,结合 HiCache 实现 KVCache 的分层卸载与按需加载,仅在 GPU 中保留需要的 Topk KVCache,从而突破显存容量限制,显著提升可支持的 Batch Size 与系统吞吐。
4.2 3FS 产品化方案
3FS 作为专为 AI 场景设计的高性能分布式文件系统,其部署与运维需兼顾灵活易用、高可用与弹性扩展等能力。
在部署实践中,阿里云服务器研发存储团队开源的 3FS Operator,通过 Kubernetes 原生能力提供了完整的云原生化解决方案
- 声明式部署与容器化管理:基于 Kubernetes 的自定义资源+控制器能力,实现 3FS 集群的容器化部署,支持自建物理机集群、阿里云 ACK 等多种环境
- 无感知存储接入:基于Webhook机制动态注入Fuse Client容器,对用户业务容器完全透明
- 故障自愈与弹性扩缩容:Operator 持续监控组件状态,自动替换故障副本,实现滚动升级与弹性扩容;通过 Headless Service + DNS 解析解决 Mgmtd Pod IP 变化问题,保障主备节点无缝切换
- 租户资源隔离:支持在同一 Kubernetes 集群中部署多套 3FS 集群,结合阿里云 VPC 子网划分与安全组策略,实现跨业务场景的管控资源复用与网络安全隔离
4.3 Hybrid Models Support
随着混合架构模型(全注意力层+线性注意力层)在长上下文大语言模型服务场景的加速普及,SGLang通过创新内存管理与调度机制,在保持推理能力的同时显著降低显存占用与计算延迟。该设计有效解决了线性注意力状态不可回滚与传统优化机制的冲突,核心能力包括:
- 分层内存架构:隔离管理 KVCache(Token 粒度)与 SSM 状态(请求粒度),分别管理不同注意力层的缓存,支持根据实际负载预定义不同缓存池比例
- 弹性显存调度:基于 CUDA 虚拟内存技术实现KV/SSM双池动态伸缩,实现固定总显存下的资源利用率最大化
- 混合前缀缓存:扩展RadixTree支持KV/SSM双缓存生命周期管理,实现无算子修改的前缀复用与淘汰
- 推测解码适配:通过状态快照槽位机制兼容EAGLE-Tree等加速方案,支持Top-K >1场景
- PD 架构扩展:新增独立状态传输通道,简化新型混合模型集成
4.4 Tair KVCache Manager
面对多样的推理引擎和后端存储系统,Tair KVCache将其中有共同的KVCache全局管理需求抽取,提供了统一的全局KVCache管理系统 Tair KVCache Manager:
- 提供全局外部KVCache管理能力。实现KVCache跨机复用。
- 通过统一的接口和传输库支持 SGLang、vLLM、RTP-LLM、TensorRT-LLM 等主流推理引擎的接入。
- 支持使用包括 3FS 在内的多种存储系统。通过一致的存储元数据抽象对异构存储系统进行封装,显著降低了不同推理引擎以及不同存储系统接入的复杂度与开发成本。
- 提供多租Quota管理、高可靠、可观测等企业级能力。
- 针对如何确定特定业务和场景下全局KVCache池化收益的难题,KVCache Manager提供了算力和缓存仿真能力,可以基于真实业务Trace计算命中率和算力节约量。同时提供了配置寻优功能,帮助用户调整存储配置,实现最佳ROI。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70043023/viewspace-3105206/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 信创数据库PolarDB:通过数据库安全可靠测评,100%兼容PG和MySQL
- 轻量化部署+100%兼容MySQL,PolarDB MySQL版V2.0 国产化替代数据库技术揭秘
- PolarDB MySQL版V2.0:100% 兼容 MySQL的国产自研数据库介绍
- AnalyticDB PostgreSQL 版软件 V2.0:安全可靠的全场景一站式数据仓库
- 安全可靠的阿里云自研数据库 PolarDB MySQL 版V2.0,邀您免费体验!
- 安全可靠数据库选型之阿里云 PolarDB MySQL 版V2.0
- PolarDB 分布式版 AI 助手正式上线!现邀你立即解锁专属“数字 DBA”
- 阿里云瑶池数据库 Data Agent,让你轻松拥有企业级数据智能助手!
- 打破数据洞察瓶颈!阿里云瑶池数据库 Data Agent 企业版助你轻松驾驭数据
- 信创数据库阿里云PolarDB,安全、高效、可靠的数据库解决方案
