PS :在下一篇文章中分析排行榜的动态变化趋势,并绘制成动态条形图和折线图。
一、网站原始信息

我们先来看下原始的网站页面
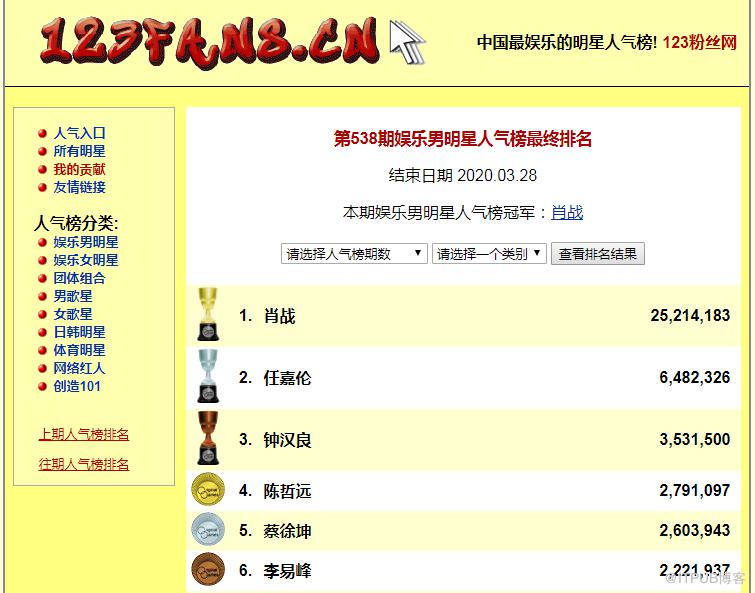
 ,还有可能会因为人为原因出错。

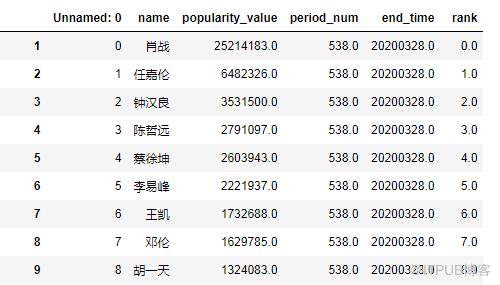
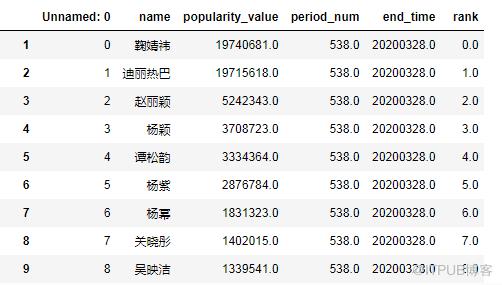
三、如何获取123粉丝网的爬虫信息

step1:浏览器(一般用火狐和Google我用的360
 )中打开123粉丝网
step2:按键盘F12 -> ctrl+r
-
step3: 点击results.php -> 到Headers中找到代码所需的参数 

1 用Python中的Requests库获取网页信息
#爬取当前页信息,并用BeautifulSoup解析成标准格式import requests #导入requests模块import bs4url = "https://123fans.cn/lastresults.php?c=1"headers = {'User-Agent':'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/78.0.3904.108 Safari/537.36','Request Method':'Get'}req = requests.get(url, timeout=30, headers=headers)soup = bs4.BeautifulSoup(req.text, "html.parser")
2 把爬取到的数据整合到一个数据框中
import reimport numpy as npimport pandas as pdperiod_data = pd.DataFrame(np.zeros((400,5)))period_data.columns = ['name', 'popularity_value', 'period_num', 'end_time','rank']i = 0name = soup.findAll("td", {"class":"name"})for each in name:period_data['name'][i]=each.a.texti += 1j = 0popularity = soup.findAll("td", {"class":"ballot"})for each in popularity:period_data['popularity_value'][j]=float(each.text.replace(",",''))j += 1period_num = int(re.findall('[0-9]+', str(soup.h2.text))[0])period_data['period_num'] = period_numend_time_0 = str(re.findall('结束日期.+[0-9]+', str(soup.findAll("div", {"class":"results"})))).split('.')end_time = ''for str_1 in end_time_0:end_time = end_time + re.findall('[0-9]+',str_1)[0]period_data['end_time'] = end_timeperiod_data_1 = period_data.sort_values(by='popularity_value',ascending=False)period_data_1['rank'] = range(period_data_1.shape[0])
popularity:用findAll函数取出所有的人气值信息。
period_data_1['rank']:在最后一列加入有序数,方便数据截取使用。
接下来展示批量爬虫代码
五、批量爬虫代码解析

1 定义爬虫函数
import requests #导入requests模块import bs4import re #正则表达式库import numpy as npimport pandas as pdimport warningsimport timeimport randomwarnings.filterwarnings('ignore') #忽视ignore#headers的内容在Headers里面都可以找到headers = {'User-Agent':'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/78.0.3904.108 Safari/537.36','Request Method':'Get'}def crawler(url):req = requests.get(url, timeout=30, headers=headers) # 获取网页信息soup = bs4.BeautifulSoup(req.text, "html.parser") #用soup库解析period_data = pd.DataFrame(np.zeros((400,5))) #构造400行5列的全0矩阵备用period_data.columns = ['name', 'popularity_value', 'period_num', 'end_time','rank'] #给0矩阵列命名#把当期的数据填入表格中#姓名信息i = 0name = soup.findAll("td", {"class":"name"})for each in name:period_data['name'][i]=each.a.text #依次加入姓名i += 1#人气信息j = 0popularity = soup.findAll("td", {"class":"ballot"})for each in popularity:period_data['popularity_value'][j]=float(each.text.replace(",",'')) #依次加入人气值j += 1#期数信息period_num = int(re.findall('[0-9]+', str(soup.h2.text))[0])period_data['period_num'] = period_num#截止日期end_time_0 = str(re.findall('结束日期.+[0-9]+', str(soup.findAll("div", {"class":"results"})))).split('.')end_time = ''for str_1 in end_time_0:end_time = end_time + re.findall('[0-9]+',str_1)[0]period_data['end_time'] = end_time#有序数,方便截取前多少位period_data_1 = period_data.sort_values(by='popularity_value',ascending=False)period_data_1['rank'] = range(period_data_1.shape[0])return period_data_1
本段代码是把分段爬虫代码整合到一个函数中,方便反复调用。
2 反复调用函数实现批量爬虫
period_data_final = pd.DataFrame(np.zeros((1,5))) #构造400行5列的全0矩阵备用period_data_final.columns = ['name', 'popularity_value', 'period_num', 'end_time','rank'] #给0矩阵列命名for qi in range(538,499,-1):print("目前爬到了第",qi,'期')if qi == 538:url="https://123fans.cn/lastresults.php?c=1"else:url="https://123fans.cn/results.php?qi={}&c=1".format(qi)time.sleep(random.uniform(1, 2))date = crawler(url)period_data_final = period_data_final.append(date)period_data_final_1 = period_data_fina.loc[1:,:] #去掉第一行无用数据
本段代码是反复调用爬虫函数获取页面数据,并用append整合到一个数据框中。
注3:time.sleep中用了随机数,是人为休眠一段不定长时间为了防止反爬虫。
你可能感兴趣:
长按识别上方二维码学习更多Python知识
喜欢这篇文章
就请点个 “ 在看”吧
原文作者:阿黎逸阳的代码;如有侵权,请联系管理员删除。
上一篇:
3D星空图

请登录后发表评论
登录
全部评论
