对于分类模型,在建立好模型后,我们想对模型进行评价,常见的指标有混淆矩阵、KS曲线、ROC曲线、AUC面积等。也可以自己定义函数,把模型结果分割成n(100)份,计算top1的准确率、覆盖率。
本文详细阐述混淆矩阵的原理和Python实现实例,其它指标会在后续文章中详尽阐述,敬请期待 。
什么是混淆矩阵
混淆矩阵有关的三级指标
2.1 一级指标
2.2 二级指标
2.3 三级指标
计算混淆矩阵的实例
用Python计算混淆矩阵并图形展示
4.1 加载包
4.2 加载数据
4.3 定义绘制混淆矩阵的函数
4.4 绘制单个混淆矩阵
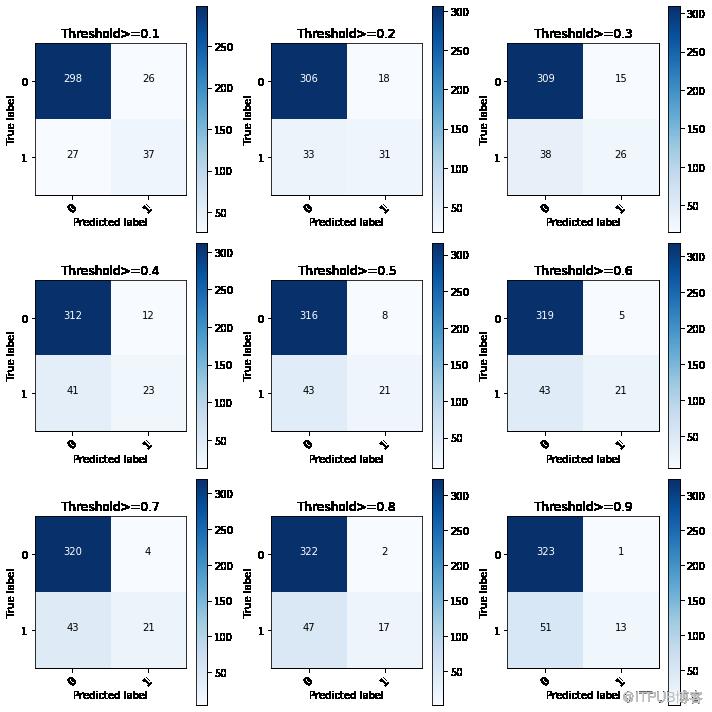
4.5 设定不同的阈值一次绘制多个混淆矩阵

比如样本的实际类别是狗,若模型预测类别也是狗,则说明对于该样本模型预测对了。若模型预测类别为猫,则说明对于该样本模型预测错了。

以分类模型中最简单的二分类为例。假如我们有一批顾客是否买某种产品的样本数据,顾客买了产品我们标记为positive,没买标记为negative。
现在通过分类模型训练这批样本,根据模型结果可以知道模型认为哪些顾客会买(预测的positive),哪些顾客不会买(预测的negative)。
因此我们可以得到以下四个一级指标:
1. TP(True Positive):真实值是positive,模型认为是positive的数量,即模型预测正确的正例数量。 2. FN(False Negative):真实值是positive,模型认为是negative的数量,即模型预测错误的正例数量,这是统计学上的第二类错误(Type II Error)。 3. FP(False Positive):真实值是negative,模型认为是positive的数量,即模型预测错误的负例数量,这是统计学上的第一类错误(Type I Error)。
4.TN(True Negative):真实值是negative,模型认为是negative的数量,即模型预测正确的负例数量。
将这四个指标统计到一个矩阵表格中,就得到了混淆矩阵(Confusion Matrix)。
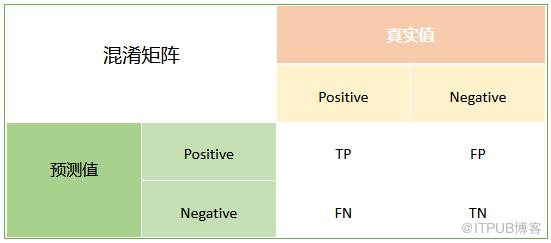
比如TP表示模型预测为positive,且模型预测正确的样本数量,即样本实际类别为positive,模型预测类别为positive的样本数量。
FP表示模型预测为positive,且模型预测错误的样本数量,即样本实际类别为negative,模型错误地预测成了positive的样本数量。
2 二级指标
对于预测性分类模型,我们希望模型的预测结果越准越好,即混淆矩阵中TP、TN的值越大越好,相应FP、FN的值越小越好。
但是,混淆矩阵里统计的是数量,在数据量很大的情况下很难一眼判断出模型的优劣。因此,在混淆矩阵的基本统计结果上又衍生了如下4个指标(可以理解为二级指标,类似于特征工程里的衍生变量):
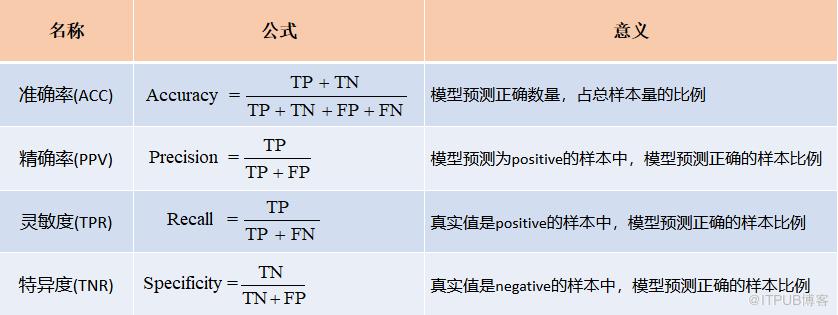
通过上面的四个二级指标,可以将混淆矩阵中的数量结果转化为0-1之间的比率,便于我们直观地对模型进行评价。
3 三级指标
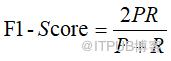
 当分类问题是多分类时,只要把其中一类当成一组,另外的所有类当成另一组,就可以转化成二分类问题,接下来讲一个二分类计算混淆矩阵三级指标的具体实例。
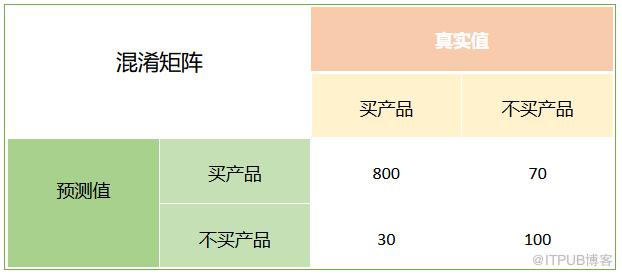
假设我们模型的目的是预测一批顾客是否会购买某种产品,我们的结果如下:
1 一级指标
1. TP(True Positive):真实值是买产品,模型认为是买产品的顾客数量,即模型预测正确的正例数量,在该例中值为800。 2. FN(False Negative):真实值是买产品,模型认为是不买产品的顾客数量,即模型预测错误的正例数量,在该例中值为30。 3. FP(False Positive):真实值是不买产品,模型认为是买产品的顾客数量,即模型预测错误的负例数量,在该例中值为70。
4.TN(True Negative):真实值是不买产品,模型认为是不买产品的数量,即模型预测正确的负例数量,在该例中值为100。
1. 准确率(Accuracy):总共1000个顾客,我们一共预测对了800+100=900个样本,所以准确率为90%。 2. 精确率(Precision):模型结果告诉我们,1000个顾客里有870个顾客会买产品,但其实这870个顾客里只有800个顾客实际买了产品,70个顾客没有买产品。所以,精确率为800/870=91.95%。 3.灵敏度/召回率(Recall):在830个实际购买了产品的顾客中,模型认为有800个顾客会购买产品,30个顾客不会购买产品,所以召回率为800/830=96.38%。
4.特异度(Specificity):在170个实际不买产品的顾客中,模型认为有100个不会购买产品,70个会购买产品,所以特异度为100/170=58.82%。

flag列是真实标签,1代表商户存在赌博行为,0代表商户不存在赌博行为。
pred列是模型预测标签,1代表模型预测商户存在赌博行为,0代表模型预测商户不存在赌博行为。
1 加载包
import pandas as pdimport matplotlib.pyplot as pltimport numpy as npfrom sklearn.linear_model import LogisticRegressionfrom sklearn.model_selection import KFold, cross_val_scorefrom sklearn.metrics import confusion_matrix, recall_score, classification_report
2 加载数据
#加载数据%matplotlib inlinedate = pd.read_csv("data.csv", encoding="gbk")
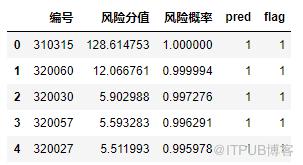
我们可以根据模型的风险概率(prob)和想要的准确率、覆盖率,人为确定当风险概率大于某个值时模型认为该商户存在赌博风险,当风险概率小于该值时模型认为该商户不存在赌博风险。
一般要根据行业和风险类别确定这个阈值,本文pred划定的阈值为0.7,即当风险概率值大于0.7时模型认为该商户存在赌博风险并标记为1,小于0.7时模型认为该商户不存在赌博风险并标记为0。
def plot_confusion_matrix(cm, classes,normalize=False,title='Confusion matrix',cmap=plt.cm.Blues):"""This function prints and plots the confusion matrix.Normalization can be applied by setting `normalize=True`."""if normalize:cm = cm.astype('float') / cm.sum(axis=1)[:, np.newaxis]print("Normalized confusion matrix")else:print('Confusion matrix, without normalization')print(cm)plt.imshow(cm, interpolation='nearest', cmap=cmap)plt.title(title)plt.colorbar()tick_marks = np.arange(len(classes))plt.xticks(tick_marks, classes, rotation=45)plt.yticks(tick_marks, classes)fmt = '.2f' if normalize else 'd'thresh = cm.max() / 2.for i, j in itertools.product(range(cm.shape[0]), range(cm.shape[1])):plt.text(j, i, format(cm[i, j], fmt),horizontalalignment="center",color="white" if cm[i, j] > thresh else "black")plt.tight_layout()plt.ylabel('True label')plt.xlabel('Predicted label')
import itertoolscnf_matrix = confusion_matrix(date.flag, date.pred) #计算混淆矩阵class_names = [0,1]plt.figure()plot_confusion_matrix(cnf_matrix, classes = class_names, title = 'Confusion matrix') #绘制混淆矩阵np.set_printoptions(precision=2)print('Accary:', (cnf_matrix[1,1]+cnf_matrix[0,0])/(cnf_matrix[1,1]+cnf_matrix[0,1]+cnf_matrix[0,0]+cnf_matrix[1,0]))print('Recall:', cnf_matrix[1,1]/(cnf_matrix[1,1]+cnf_matrix[1,0]))print('Precision:', cnf_matrix[1,1]/(cnf_matrix[1,1]+cnf_matrix[0,1]))print('Specificity:', cnf_matrix[0,0]/(cnf_matrix[0,1]+cnf_matrix[0,0]))plt.show()

5 设定不同的阈值一次绘制多个混淆矩阵
import itertoolsthresholds =[0.1,0.2,0.3,0.4,0.5,0.6,0.7,0.8,0.9] #设定不同的阈值plt.figure(figsize = (10,10))j = 1for i in thresholds:y_pred = date['风险概率']>i #把风险概率prob和阈值进行比较plt.subplot(3,3,j)#Compute confusion matrixj += 1cnf_matrix = confusion_matrix(date.flag, y_pred) #计算混淆矩阵np.set_printoptions(precision = 2)#Print degree2 indexprint('Accary:', (cnf_matrix[1,1]+cnf_matrix[0,0])/(cnf_matrix[1,1]+cnf_matrix[0,1]+cnf_matrix[0,0]+cnf_matrix[1,0]))print('Recall:', cnf_matrix[1,1]/(cnf_matrix[1,1]+cnf_matrix[1,0]))print('Precision:', cnf_matrix[1,1]/(cnf_matrix[1,1]+cnf_matrix[0,1]))print('Specificity:', cnf_matrix[0,0]/(cnf_matrix[0,1]+cnf_matrix[0,0]))#Plot non-normalized confusion matrixclass_names = [0, 1]plot_confusion_matrix(cnf_matrix, classes = class_names, title = 'Threshold>=%s' %i)
 。
https://zhuanlan.zhihu.com/p/46204175https://www.cnblogs.com/missidiot/p/9450662.htmlhttps://blog.csdn.net/Orange_Spotty_Cat/article/details/80520839
往期回顾:

扫一扫关注我
19967879837
投稿微信号、手机号
原文作者:阿黎逸阳的代码;如有侵权,请联系管理员删除。

