这时需要在Python中把训练好的模型保存为PMML文件,到Java中直接调用预测。
什么是PMML?
Python中把模型保存为PMML的标准格式
实例一:把GBDT模型保存为PMML文件
3.1 导入数据
3.2 取出建模所需的变量
3.3 训练模型并保存为PMML文件
实例二:把随机森林模型保存为PMML文件
4.1 导入包
4.2 按标准流程建模并导出PMML文件
PMML的优缺点
5.1 优点
5.2 缺点

PMML(Predictive Model Markup Language):预测模型标记语言,它用XML格式来描述生成的机器学习模型,是目前表示机器学习模型的实际标准。
若要将在Python中训练好的模型部署到生产上时,可以使用目标环境解析PMML文件的库来加载模型,并做预测。

Python中把模型导出为PMML文件的一般流程如下:
step1:特征处理(DataFrameMapper函数)。
step2:训练模型(pipeline函数)。
step3:导出模型(sklearn2pmml函数)。
其中step1不是必须步骤。
接下来看两个具体实例。
三、实例一:把GBDT模型保存为PMML文件

1 导入数据
首先导入建模所需数据。
# coding: utf-8import osimport pandas as pd #导入数据处理的库import numpy as np #导入数据处理的os.chdir(r'F:\微信公众号\Python\40_机器学习模型导出为PMML文件')data = pd.read_csv('testtdmodel.csv',sep=',',encoding='gb18030')
注:如需本文数据实现所有代码,可到公众号中回复“PMML”,即可免费获取。
本文选取了8个自变量,1个因变量进行建模。
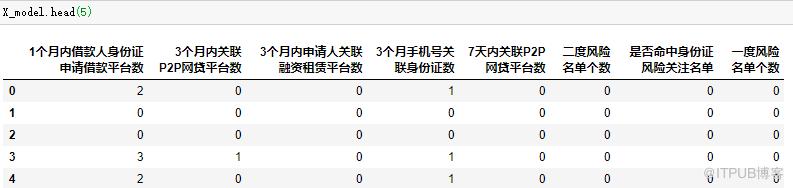
columns_model = ['1个月内借款人身份证申请借款平台数','3个月内关联P2P网贷平台数','3个月内申请人关联融资租赁平台数','3个月手机号关联身份证数','7天内关联P2P网贷平台数','二度风险名单个数','是否命中身份证风险关注名单','一度风险名单个数']X_model = data[columns_model]y = data['y']
X_model具体格式如下:
在实例一中没有进行特征处理(step1),直接训练模型并导出PMML文件。
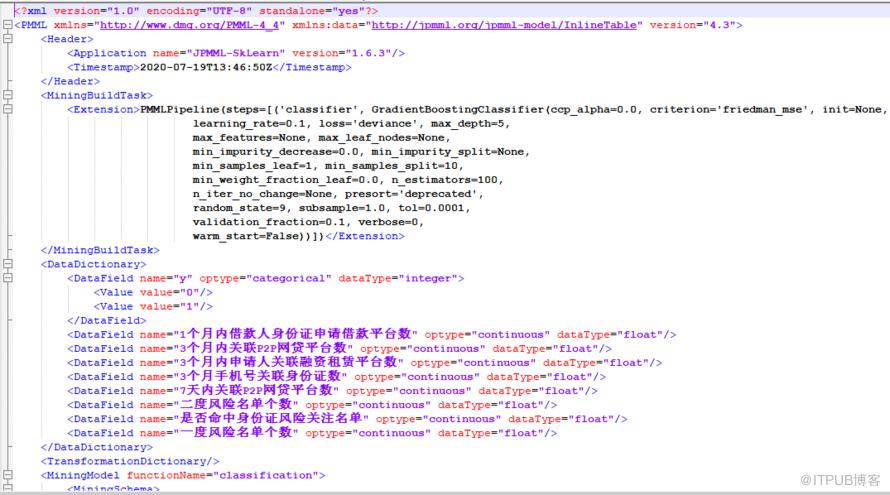
from sklearn import treefrom sklearn.model_selection import train_test_splitfrom sklearn2pmml import PMMLPipeline, sklearn2pmmlfrom sklearn.ensemble import GradientBoostingClassifiertrain, test, train_labels, test_labels = train_test_split(X_model, y, test_size=0.2, random_state=0)GBDT = GradientBoostingClassifier(random_state=9,max_depth=5,min_samples_split=10)pipeline = PMMLPipeline([("classifier", GBDT)])pipeline.fit(train, train_labels)sklearn2pmml(pipeline, 'GBDT1.pmml', with_repr=True, debug=True)
参数详解:
得到部分结果如下:

本例数据和实例一相同,就不赘述了。
本例按Python中把模型导出为PMML文件的一般流程进行。
首先导入数据预处理和建模所需的包。
import numpy as npimport pandas as pdfrom sklearn.ensemble import RandomForestClassifierfrom sklearn.datasets import load_irisfrom sklearn.ensemble import GradientBoostingClassifierfrom sklearn2pmml import sklearn2pmml, PMMLPipelinefrom sklearn2pmml.decoration import ContinuousDomainfrom sklearn.feature_selection import SelectKBest# frameworks for MLfrom sklearn_pandas import DataFrameMapperfrom sklearn.pipeline import make_pipeline# transformers for category variablesfrom sklearn.preprocessing import LabelBinarizerfrom sklearn.preprocessing import MultiLabelBinarizerfrom sklearn.preprocessing import LabelEncoderfrom sklearn.preprocessing import OneHotEncoder#from sklearn.preprocessing import Imputerfrom sklearn.impute import SimpleImputer# transformers for numerical variablesfrom sklearn.preprocessing import MinMaxScalerfrom sklearn.preprocessing import StandardScalerfrom sklearn.preprocessing import Normalizer# transformers for combined variablesfrom sklearn.decomposition import PCAfrom sklearn.preprocessing import PolynomialFeatures# user-defined transformersfrom sklearn.preprocessing import FunctionTransformer
本文选取了8个自变量和一个因变量进行建模,并对其中4个变量进行数据处理。
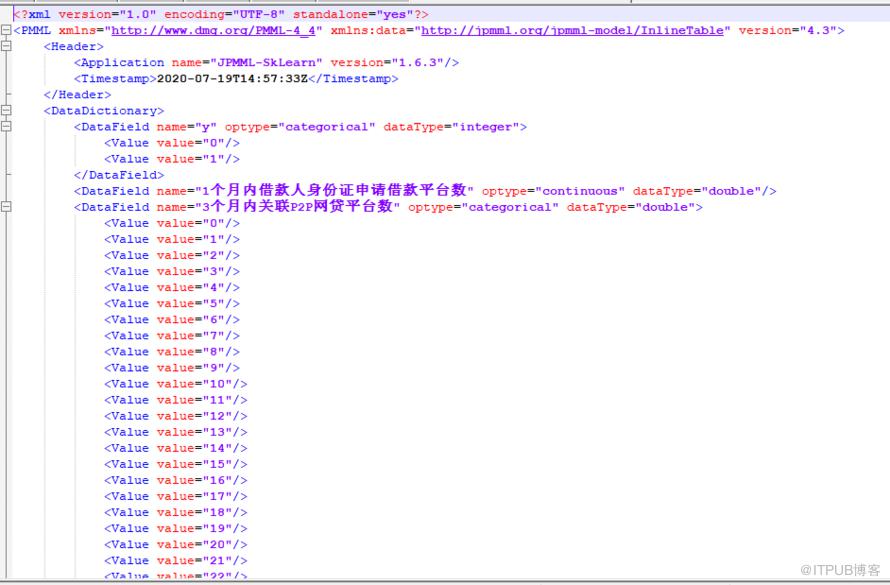
#step1:特征工程mapper = DataFrameMapper([(['1个月内借款人身份证申请借款平台数'],FunctionTransformer(np.abs)),(['3个月内关联P2P网贷平台数'],OneHotEncoder()),(['7天内关联P2P网贷平台数', '二度风险名单个数'], [MinMaxScaler(),StandardScaler()])])iris_pipeline = PMMLPipeline([("mapper", mapper),("pca", PCA(n_components=3)),("selector", SelectKBest(k=2)), #返回k个最佳特征("classifier", RandomForestClassifier())])#step2:训练模型iris_pipeline.fit(X_model,y)#step3:导出模型到 RandomForestClassifier_Iris.pmml 文件sklearn2pmml(iris_pipeline, "RandomForestClassifier_Iris.pmml")
参数详解:
DataFrameMapper:进行数据预处理。
np.abs:对该列进行绝对值处理。
OneHotEncoder:对该列进行one-hot编码。
MinMaxScaler:对该列进行标准化处理(min max 归一化)。
PCA:主成分分析。
RandomForestClassifier:随机森林建模。
iris_pipeline.fit:用通道中设定的方法训练模型。
生成的PMML文件内容如下:
比如在Python中训练了GBDT模型,模型还没有上线,需每天手工打样验证。可以用pickle函数把模型打包,之后要使用直接加载就可以了。

如果训练环境和预测环境不一样,在生产上安装(R、Python、Spark等)不方便,可以使用PMML文件的方式,在生成环境直接读取PMML获得训练后的模型。

1. 平台无关性。PMML采用标准的XML格式保存模型,可以实现跨平台部署。 2. 广泛的支持性。很多常用的开源模型都可以转换成PMML文件。 3. 易读性。PMML模型文件是一个基于XML的文本文件,任意文本编辑器都可以打开查阅。
1.对数据预处理的支持有限。虽然已经支持了几乎所有的标准数据处理方式,但是对于自拓展的方法,还缺乏有效支持。
2. 模型类型支持有限。缺乏对深度学习模型的支持。
-
3. 预测会有一点偏差。因为PMML格式的通用性,会损失特殊模型的特殊优化。
比如一个样本,用sklearn的决策树模型预测为类别2,但是我们把这个决策树保存为PMML文件,并用JAVA加载后,继续预测刚才这个样本,有较小的概率出现预测的结果不为类别2。
参考文献:
https://https://blog.csdn.net/wshzd/article/details/96165636https://blog.csdn.net/hshuihui/article/details/53260922https://blog.csdn.net/yueguanghaidao/article/details/91892549https://www.cnblogs.com/pinard/p/9220199.html
原文作者:阿黎逸阳的代码;如有侵权,请联系管理员删除。

