 。
安装pandas_profiling库
1.1 pip install 安装
1.2 whl文件安装
1.3 方法三
使用pandas_profiling
2.1 加载数据
2.2 一行代码生成报告
2.3 一行代码保存报告

1 方法一:pip install 安装
有些小伙伴直接在cmd中运行 pip install pandas_profiling 就可以成功安装这个库。
那真的该恭喜你了。
我的运行会报如下错误:

所以我准备直接下载whl文件进行安装。
2 方法二:whl文件安装
首先到如下网站下载whl文件:https://pypi.org/project/pandas-profiling/#files,可能会出现没有反应的情况,多进几次就好了。
进去后点击Dowload Files,下载右边红框中的whl文件到本地。
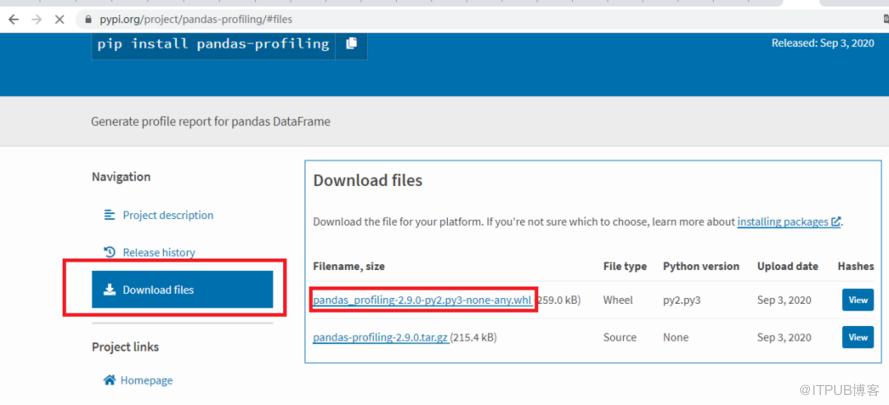
在whl文件所在文件夹打开cmd,运行pip install XXX.whl,有些小伙伴可以成功安装该库。
我的一直安装不了,会报如下错误 。
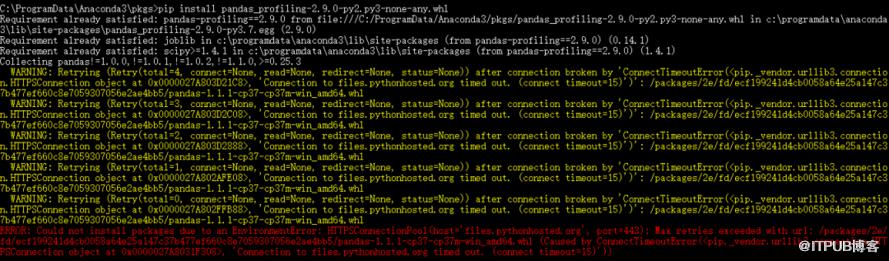
找了很久的资料,结合报错的提示,终于运行完如下语句后成功安装了pandas_profiling库 。
pip install --user pandas_profiling-2.9.0-py2.py3-none-any.whl -i https://pypi.tuna.tsinghua.edu.cn/simple some-package可是在jupyter中使用Pandas_Profiling.ProfilingReport时会报如下错误:concat() got an unexpected keyword argument ‘join_axes’,经查是pandas和Pandas_Profiling版本过低导致。
在cmd中运行 pip install --upgrade pandas和pip install --upgrade pandas_Profiling 即可。
3 方法三
如果还有小伙伴安装不好,可以试下如下方法:
pip install https://github.com/pandas-profiling/pandas-profiling/archive/master.zip
1 加载数据
import pandas as pdimport pandas_profilingdf = pd.read_csv('testtdmodel.csv',sep=',',encoding='gb18030')data = df[['3个月内申请人在多个平台申请借款', '7天内借款人手机申请借款平台数', '1个月内借款人手机申请借款平台数']]data = data.astype(float)
2 一行代码生成报告
运行如下语句可以生成数据分析基本报告。
pandas_profiling.ProfileReport(data)1. Overview(数据基本情况):包括数据集中变量个数(3)、样本行数(7252)、缺失行数(0)、缺失率(0%)、重复行数(6674)、重复率(92%)、内存占用情况等。

2. Variables(单变量情况):包括单变量值个数(54)、均值(3.88499)、最小值(0)、最大值(82)、缺失值(0)、缺失率(0%)等。

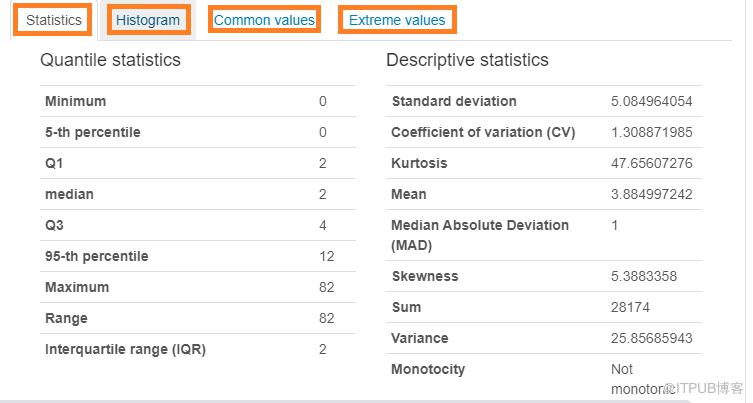
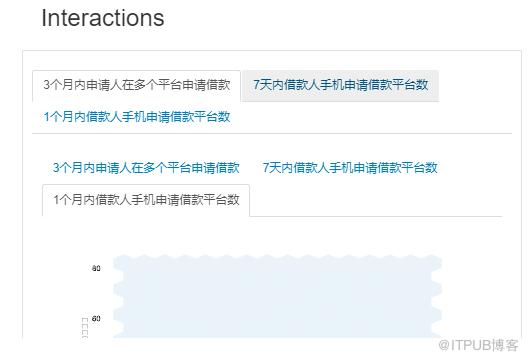

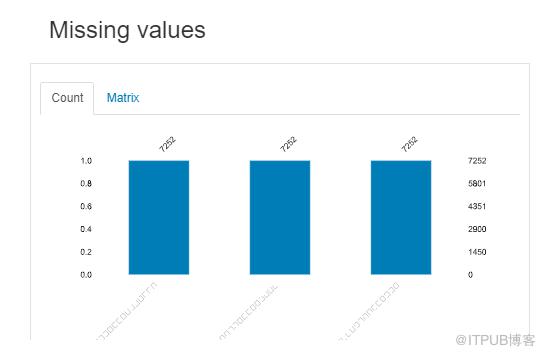
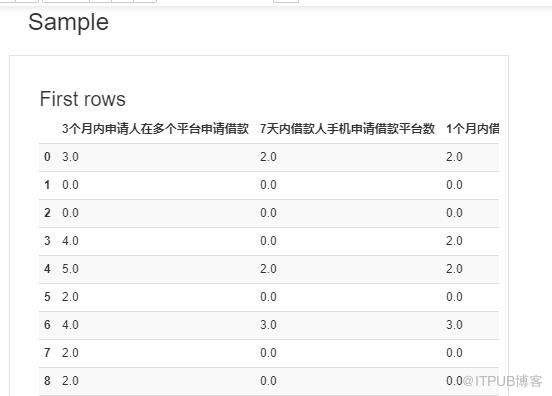
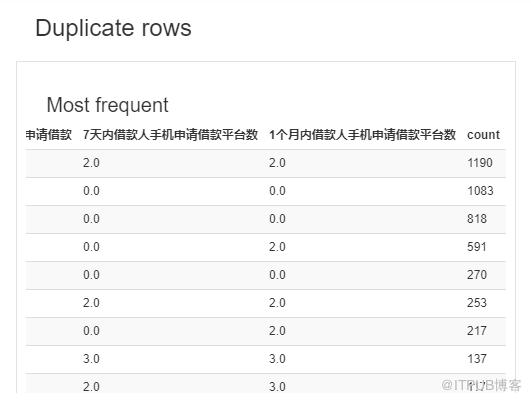
7. Duplicate rows(重复行展示):展示重复行统计前十的行。
如果我们想把这个报告保存下来,应该怎么办呢?
3 一行代码保存报告
运行如下语句可以保存成html报告。
data.profile_report(title='Data').to_file('Data.html')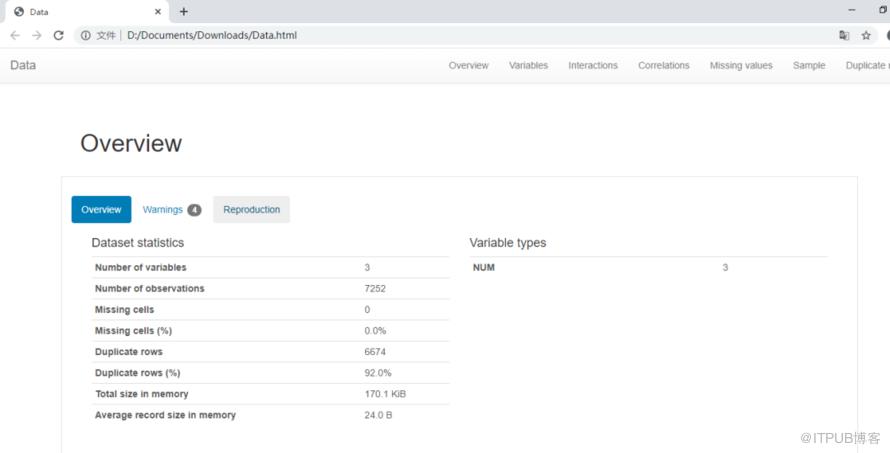
https:///a1f39f57dd91https://www.cnblogs.com/hankleo/p/11728325.html

扫一扫关注我
19967879837
投稿微信号
原文作者:阿黎逸阳的代码;如有侵权,请联系管理员删除。

