机器学习越来越多地在企业应用,本文跟大家分享一个采用python,应用决策树算法对跨国食品超市顾客等级进行预测的具体案例。
加载数据
1.1 加载库
1.2 加载数据
数据预处理
2.1 分析标签列数据分布
2.2 特征列数据分析
2.3 年收入列正则化处理
2.4 受教育程度列One-hot编码
模型训练与效果评估
完整代码

1 加载库
首先加载pandas库,并设置数据读取文件夹。
import osimport numpy as npimport pandas as pdos.chdir(r'F:\公众号\4.决策树和随机森林')
2 加载数据
接着用read_csv函数读取数据。
ori_date = pd.read_csv("customer.csv") #读取数据得到结果如下:

本文数据10281行、28列,其中每一行代表一个顾客。每一列代表一个特征,其中member_card列表示标签列。
注:如需本文数据,请到公众号中回复“决策树预测客户等级”即可免费获取。

首先用value_counts函数看下标签列的分布情况,并查看该列是否存在缺失值和有问题的值。
ori_date['member_card'].value_counts()
2 特征列数据分析
首先来看下数据框中有哪些列,具体语句如下:
ori_date.columns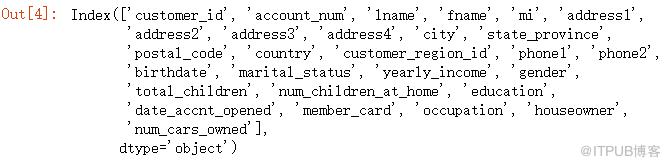
ori_date['yearly_income'].value_counts()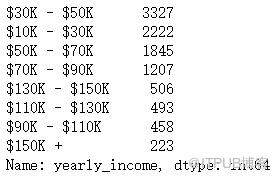
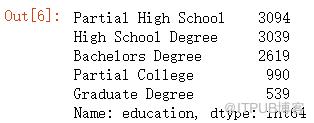
ori_date['education'].value_counts()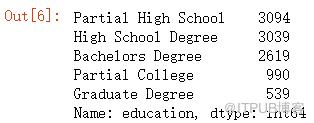
ori_date['total_children'].value_counts()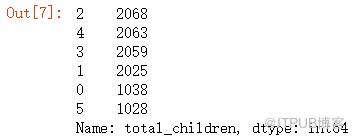
ori_date['num_cars_owned'].value_counts()
3 年收入列正则化处理
一种办法是只保留年收入列中的数值作为入模变量,具体语句如下:
ori_date['yearly_income'] = ori_date['yearly_income'].str.replace('[^0-9]', '')ori_date['yearly_income'].value_counts()
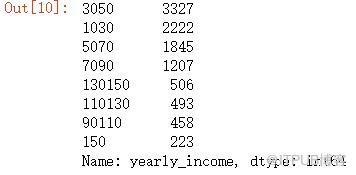
另一种办法是只保留年收入下限作为入模变量,具体语句如下:
ori_date['yearly_income'] = ori_date['yearly_income'].str.split(" ").str[0].str.replace('[^0-9]', '')ori_date['yearly_income'].value_counts()

可以发现第二种方法只保留了收入下限。
本文采用的是第一种方法,感兴趣的同学可以试试第二种办法,看看两种方法得到的变量入模后有多少区别。
4 受教育程度列One-hot编码
从上文的分析中可以发现,受教育程度列是文本列,需要转换成数值才可以入模。
有些同学可能会说,直接该列的文本转换成相应的数值即可,具体语句如下:
from sklearn.preprocessing import LabelEncoderencoding = LabelEncoder()encoding.fit(ori_date['education'])education_new = encoding.transform(ori_date["education"])education_new = pd.DataFrame(education_new)education_new.iloc[:,0].value_counts()

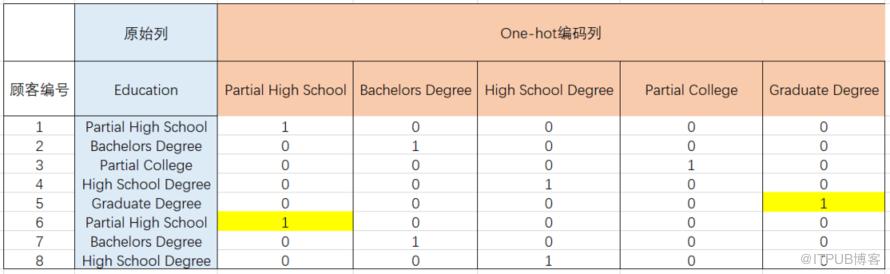
from sklearn.preprocessing import OneHotEncoderencoding = OneHotEncoder()newData = encoding.fit_transform(np.vstack(ori_date["education"].values)).todense()frame_new = pd.DataFrame(newData)
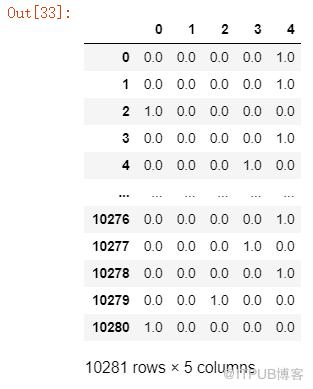

区分特征变量和标签变量的语句如下:
X = pd.merge(ori_date[["yearly_income", "total_children", "num_cars_owned"]],frame_new, left_index = True, right_index = True) #特征变量y = ori_date['member_card'] #标签变量
2 模型训练与效果评估
本文采用决策树算法进行建模,并用交叉验证的方法给出模型评分,具体代码如下:
from sklearn.tree import DecisionTreeClassifierfrom sklearn.model_selection import cross_val_scoreclf = DecisionTreeClassifier()scores = cross_val_score(clf, X, y, scoring = 'accuracy')print(np.mean(scores))
其中,clf=DecisionTreeClassifier表示分类器采用的决策树算法。
cross_val_score表示对自变量X和因变量y采用clf对应的算法,进行交叉验证。每一次都有一列真实值和预测值,两者进行对比算出这次训练的得分,依次保存到scores中。
最终的分数采用多次结果的加权平均来表示。
得到结果如下:
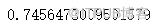
可以发现采用决策树算法进行分类,最终得分0.74左右,感兴趣的同学可以自己尝试调整入模变量和算法,看看能不能优化这个结果。

本文全量代码如下:
import osimport numpy as npimport pandas as pdfrom sklearn.preprocessing import OneHotEncoderfrom sklearn.tree import DecisionTreeClassifierfrom sklearn.model_selection import cross_val_score#数据读取os.chdir(r'F:\公众号\4.决策树和随机森林')ori_date = pd.read_csv("customer.csv")#年收入正则化处理ori_date['yearly_income'] = ori_date['yearly_income'].str.replace('[^0-9]', '')#ori_date['yearly_income'] = ori_date['yearly_income'].str.split(" ").str[0].str.replace('[^0-9]', '')#受教育程度列One-hot编码encoding = OneHotEncoder()newData = encoding.fit_transform(np.vstack(ori_date["education"].values)).todense()frame_new = pd.DataFrame(newData)#确定特征变量和标签变量X = pd.merge(ori_date[["yearly_income", "total_children", "num_cars_owned"]],frame_new, left_index = True, right_index = True) #特征变量y = ori_date['member_card'] #标签变量#模型训练和效果评估clf = DecisionTreeClassifier()scores = cross_val_score(clf, X, y, scoring = 'accuracy')print(np.mean(scores))
往期回顾:

扫一扫关注我
19967879837
投稿微信号、手机号
原文作者:阿黎逸阳的代码;如有侵权,请联系管理员删除。

