从字符串中识别出省市区的信息分别存储,是我们经常会碰到的问题。
如果用分词的方法去匹配获取比较麻烦,cpca包提供了便捷的调用函数transform。
只要把含省市区的信息放进去,即可返回标准的含省市区的数据框。
本文详细阐述如何安装cpca包、transform函数参数定义,以及如何调用transform函数实现省市区信息获取。
安装cpca包
transform参数详解
transform调用案例详解
3.1 transform函数默认参数识别字符串中地址
3.2 改变transform函数参数识别字符串中地址
3.3 批量识别字符串中的省市区并导出最终数据

要想使用transform函数,首先需要安装cpca包。具体代码如下:
pip install cpca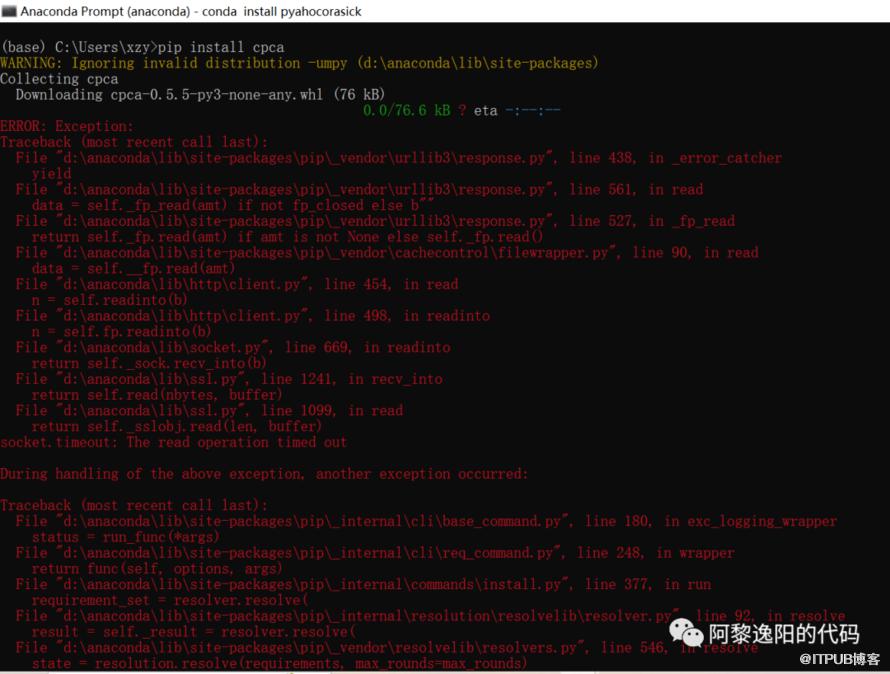
step1:在cmd中先运行 conda config --add channels conda-forgestep2:再运行 conda install pyahocorasickstep3:最后运行pip install cpca


接着写循环统计每个文件中指定词出现的次数,具体代码如下:
transform(location_strs, index=None, pos_sensitive=False, umap={})
参数详解:
locations_strs:地址描述字符集合,可以是list, Series等任意可以进行for in循环的集合。比如:["徐汇区虹漕路461号58号楼5楼", "泉州市洛江区万安塘西工业区"]。 index:可以通过这个参数指定输出的DataFrame的index,默认情况下是range(len(data))。 pos_sensitive:默认值False,如果为True则会多返回三列,分别提取出的省市区在字符串中的位置,如果字符串中不存在的话则显示-1。 umap:当只有区的信息时, 且该区存在同名时, 指定该区具体是哪一个,字典的 key为区名,value为 adcode, 比如 {"朝阳区": "110105"}。
三、transform调用案例 1 用transform函数默认参数识别字符串中地址
首先调用transform函数,用默认参数识别字符串中的地址,具体代码如下:
import cpcacpca.transform(["徐汇区虹漕路461号58号楼5楼", "泉州市洛江区万安塘西工业区", '天津市国土资源局'])得到结果:
可以发现如果地址中只有区,会自动补全前面的省和市。
其中adcode表示地址对应的行政编码。
2 改变transform函数参数识别字符串中的地址
接着调整pos_sensitive参数的值识别地址,展示对应的省市区在字符串中的位置,具体代码如下:
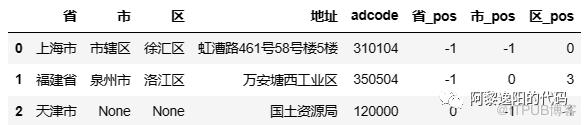
cpca.transform(["徐汇区虹漕路461号58号楼5楼", "泉州市洛江区万安塘西工业区", '天津市国土资源局'], pos_sensitive=True)得到结果:
可以发现省_pos、市_pos、区_pos的值对应了省市区在字符串中的位置,如果字符串中不存在的话则显示-1。
3 批量识别字符串中的省市区并导出最终数据
最后,读取本地数据,识别供应商名称中的省市区,具体代码如下:
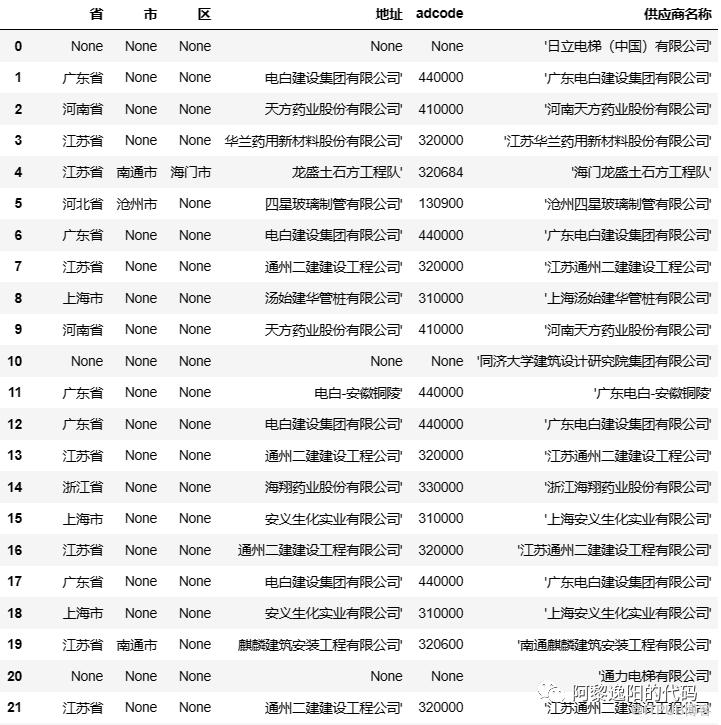
import osimport cpcaimport pandas as pd #导入数据处理的库import numpy as np #导入数据处理的库os.chdir(r'F:\公众号\85_公司名称中提取省市区')#存储数据的路径,需替换成你电脑存储路径data = pd.read_excel('date.xlsx', sheet_name='Sheet1')#读取数据place_list=[]for i in data['供应商名称']:#构造公司地址listplace_list.append(i)all_integrity_place = cpca.transform(place_list)#识别出公司名称中的省市区all_integrity_place['供应商名称'] = data['供应商名称']#添加供应商名称列all_integrity_place其中data数据形式如下:
运行代码得到结果:
导出数据: all_integrity_place.to_csv('result.csv')#导出数据至此,Python中调用transform函数识别省市区已讲解完毕,对学习python感兴趣的同学可以翻看公众号中“学习Python”模块相关文章。



【部分群限时免费进】分群讨论学习Python、玩转Python、风控建模【29.9元进】、人工智能、数据分析相关问题,还提供招聘内推信息、优秀文章、学习视频、公众号文章答疑,也可交流工作中遇到的难题。如需添加微信号19967879837,加时备注想进的群,比如学习Python。
一文囊括风控模型搭建(原理+Python实现),持续更新。。。

限时免费进群
19967879837
添加微信号、手机号
原文作者:阿黎逸阳的代码;如有侵权,请联系管理员删除。

