随机森林是一种集成学习算法,属于Bagging类型,通过组合多个决策树的预测结果得出最终的预测结果。
随机森林算法的原理和实现比较简单,本文接下来将进行详细阐述。
名词解释
随机森林算法原理详解
随机森林算法参数详解
随机森林算法在车贷领域中应用
4.1 导入基本库并设置文件存放路径
4.2 导入待建模的数据
4.3 看下数据基本情况
4.4 创建和训练分类随机森林模型
4.5 创建和训练回归随机森林模型

集成学习:通过构建并结合多个机器学习模型来改善模型的性能。通过训练多个模型,并将它们的预测结果进行某种方式的结合,通常可以得到比单一模型更好的预测结果。
Bagging:是Bootstrap Aggregating的缩写,是一种通过结合多个模型的预测结果来减少模型方差的方法。在Bagging中,每个模型都是在原始数据集的随机子集上进行训练的,这些随机子集是通过有放回的抽样得到的。然后,所有模型的预测结果通过投票(对于分类问题)或平均(对于回归问题)的方式进行结合。
随机森林:一种特殊的Bagging方法,其中每个模型都是一个决策树。除了数据集的随机子集外,每个决策树还在每个节点处从随机子集中选择最佳分裂。这种额外的随机性有助于减少模型之间的相关性,进一步提高模型的性能。

大自然中的森林是由很多的树组成的,机器学习算法中的随机森林,也是由很多决策树组成的。
对决策树原理和使用不太了解,可以看下本公众号之前的文章:决策树-ID3算法和C4.5算法、CART决策树原理(分类树与回归树)、Python中调用sklearn决策树、Python中应用决策树算法预测客户等级。
随机森林的训练过程如下:
从原始数据集中进行有放回的随机抽样,构建出多个子集。
在每个子集上训练一个决策树。
在预测阶段,让每个决策树都对输入进行预测,然后以投票的方式或求平均的方式得出最终的预测结果。

随机森林算法分为分类随机森林和回归随机森林,在
sklearn中可以直接调用。是一个功能强大的分类器,它有很多参数可以调整。
其基本调用语法如下:
from sklearn.ensemble import RandomForestClassifierfrom sklearn.ensemble import RandomForestRegressorRandomForestClassifier(n_estimators=100, *, criterion='gini', max_depth=None, min_samples_split=2, min_samples_leaf=1,min_weight_fraction_leaf=0.0, max_features='auto', max_leaf_nodes=None, min_impurity_decrease=0.0,min_impurity_split=None, bootstrap=True, oob_score=False, n_jobs=None, random_state=None, verbose=0,warm_start=False, class_weight=None, ccp_alpha=0.0, max_samples=None)RandomForestRegressor(n_estimators=100, *, criterion='mse', max_depth=None, min_samples_split=2, min_samples_leaf=1,min_weight_fraction_leaf=0.0, max_features='auto', max_leaf_nodes=None, min_impurity_decrease=0.0,min_impurity_split=None, bootstrap=True, oob_score=False, n_jobs=None, random_state=None,verbose=0, warm_start=False, ccp_alpha=0.0, max_samples=None)
主要参数详解:
n_estimators:森林中树的数量,也就是基学习器的数量。一般来说,树越多,模型的性能就越好,但同时计算时间和内存消耗也会增加。通常可以选择一个相对较大的值,然后通过交叉验证来找到最优值。
criterion:节点分裂采用的算法,这个参数决定了每个节点分裂的质量。对于分类问题,可以选择‘gini’(基尼不纯度)或‘entropy’(信息增益)。对于回归问题,可以选择‘mse’(均方误差)或‘mae’(平均绝对误差)。选择哪一个取决于你对预测误差的敏感程度。
max_depth:树的最大深度,如果设置为None,则节点会一直分裂到所有叶子都是纯的,或者直到所有的叶子都包含少于min_samples_split个样本。如果树太深,可能会导致过拟合,因此通常需要通过交叉验证来选择一个合适的值。
min_samples_split:一个节点在被考虑分裂之前必须具有的最小样本数。这个参数可以防止树过度适应训练数据。
min_samples_leaf:在每个叶子节点上必须有的最小样本数。这个参数和min_samples_split一样,也是用来防止过拟合的。
max_features:在寻找最佳分裂时考虑的特征数量。如果设置为‘auto’,则max_features=sqrt(n_features)。如果设置为‘log2’,则max_features=log2(n_features)。更大的max_features值将会使模型考虑更多的特征,从而可能提高模型的性能,但同时也会增加计算复杂度和过拟合的风险。
bootstrap:是否使用自助采样法(bootstrap sample)来构建树。如果设置为True,则每次构建树时都会从原始数据中随机抽取样本(有放回)。如果设置为False,则会使用整个数据集来构建每棵树。
oob_score:是否使用袋外样本来评估模型的性能。只有当bootstrap=True时,这个参数才有效。
random_state:随机数生成器的种子,用于控制模型的随机性。如果设置为一个整数,则每次运行模型时都会得到相同的结果。如果设置为None,则每次运行模型时都会得到不同的结果。
verbose:控制模型训练时的输出信息,如果设置为0,则不输出任何信息。如果设置为1,则会输出进度条和其他信息。
warm_start:如果设置为True,则使用上一次调用的解决方案来初始化添加更多的树,否则完全重新开始。
class_weight:指定样本各类别的权重。对于不平衡的数据集,这个参数可能会有所帮助。
n_jobs:并行运行的作业数。如果设置为-1,则使用所有可能的处理器来训练模型。
ccp_alpha:复杂度参数(特定用于回归问题),用于最小成本复杂度剪枝。增加alpha会增加剪枝的程度,从而可能导致更小、更简单的树。
四、随机森林算法在车贷领域的应用 项目背景:由于公司发展车贷业务,需要判断新进来的申请人有多大的概率会逾期,根据逾期的概率和资金的松紧程度决定是否放贷。
现在有一批历史上是否违约的客户样本数据(由于数据涉及安全问题,也是职业操守要求,故此数据不是原始数据,是经过处理的)。
想根据这批历史数据训练随机森林模型,得到模型结果,预测未来新申请的客户逾期概率。从而决定新申请人是通过、转人工核验还是拒绝。
1 导入基本库并设置文件存放路径
首先导入基本库,并设置数据的存放的地址,代码如下:
import osimport numpy as npimport pandas as pdfrom sklearn.ensemble import RandomForestClassifierfrom sklearn.ensemble import RandomForestRegressoros.chdir(r'F:\公众号\88_随机森林')
2 导入待建模的数据
用pandas库导入待建模的csv格式数据。
data = pd.read_csv('testtdmodel.csv', sep=',', encoding='gb18030')注:由于数据中存在中文,如果不使用encoding对编码进行申明会报如下错误:
UnicodeDecodeError: 'utf-8' codec can't decode byte 0xb6 in position 2: invalid start byte把endcoding的值设置为gb18030或gbk可以解决此类问题,成功导入数据。
3 看下数据基本情况
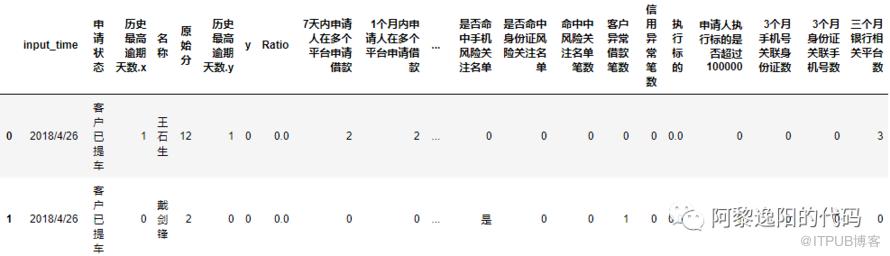
3.1 用head函数看下数据表头和前几行数据
我选择看前两行的数据,如果括号里为空默认展示前五行的数据,可以根据需要把2改为你想展示的行数。也可以用tail函数展示后几行数据。
data.head(2)结果:
3.2 用value_counts函数观测因变量y的数据分布
在信贷中,有些客户因为忘记了还款日期、或者资金在短期内存在缺口(不是恶意不还),可能会导致几天的逾期,在催收后会及时还款。
故一般不把历史逾期不超过x天(根据公司的实际业务情况和数据分析结果得出)的客户定义为坏客户(这里的坏不是坏人的意思,纯粹指逾期超过x天的客户)。
在本文把逾期超过20天的客户标签y定义为1(坏客户),没有逾期和逾期不超过20天的客户标签y定义为0(好客户)。
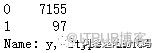
data.y.value_counts()得到结果:
本文总计样本数量为7252,其中7155个样本是好客户,97个样本是坏客户。说明0和1的分布很不均匀,我们统计一下占比:
发现0的占比达到了98.6%,1的占比不到2%,这是典型的样本不均衡问题。
如果我们把所有的客户都预测成好客户,模型可以达到98.6%的准确率。但是这个结果是毫无意义的,因为模型没起到区分逾期和非逾期客户的作用,没有达到建模的目的。
可以用前文提到的class_weight对权重进行调整,让标签是1的样本占更多的权重。
实际中很多问题可能都是数据分布不均匀的,比如患病的人数和不患病的人数、欺诈商户和正常商户、逾期的客户和不逾期的客户等等。
不过这些都是正常现象,想一想如果逾期客户数超过了不逾期的人数,公司早就倒闭了
。
那么建模的目的就是想把钱尽可能多地贷给能按期还钱的客户,尽可能多地拒绝可能会逾期的客户。这样公司的钱才能挣得更多的利息,产生更少的坏账,总收益才能最大化。
4 创建和训练分类随机森林模型
由于y的数量比较少本文就不区分训练集和测试集了,直接用全量数据训练随机森林模型,代码如下:
columns_model = ['1个月内借款人身份证申请借款平台数','7天内关联P2P网贷平台数','3个月内关联P2P网贷平台数','3个月手机号关联身份证数','3个月内申请人关联融资租赁平台数','二度风险名单个数','是否命中身份证风险关注名单','原始分','一度风险名单个数']X_train = data[columns_model] #生成入模自变量y_train = data['y'] #生成入模因变量# 创建随机森林分类器实例rf = RandomForestClassifier(n_estimators=100, max_depth=None, random_state=42)# 使用训练数据进行训练rf.fit(X_train, y_train)# 使用测试数据进行预测y_pred = rf.predict_proba(X_train)模型参数说明:
n_estimators为100,即随机森林中用到100棵决策树做为基模型。
max_depth为None,即不限制树的深度。
random_state设置为整数,则每次运行模型时都会得到相同的结果。
由于篇幅原因,本文不对调参进行详细说明,后续文章分专题进行讲解。
用训练结果绘制KS曲线,看下模型效果,代码如下:
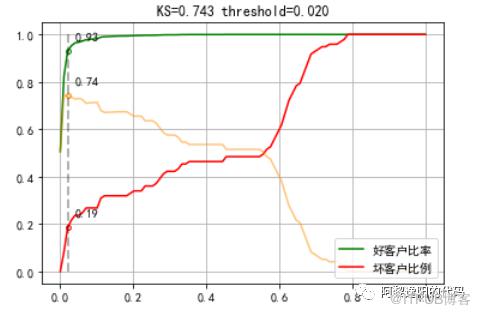
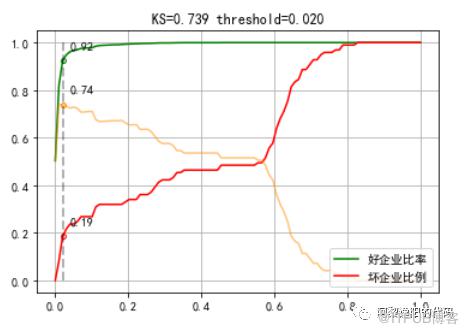
import numpy as npimport matplotlib.pyplot as pltimport matplotlibmatplotlib.rcParams["font.sans-serif"] = ["SimHei"]def ks_plot(predictions, labels, cut_point=100):good_len = len([x for x in labels if x == 0]) # 所有好客户数量bad_len = len([x for x in labels if x == 1]) # 所有坏客户数量predictions_labels = list(zip(predictions, labels))good_point = []bad_point = []diff_point = [] # 记录每个阈值点下的KS值x_axis_range = np.linspace(0, 1, cut_point)for i in x_axis_range:hit_data = [x[1] for x in predictions_labels if x[0] <= i] # 选取当前阈值下的数据good_hit = len([x for x in hit_data if x == 0]) # 预测好客户数bad_hit = len([x for x in hit_data if x == 1]) # 预测坏客户数量good_rate = good_hit / good_len # 预测好客户占比总好客户数bad_rate = bad_hit / bad_len # 预测坏客户占比总坏客户数diff = good_rate - bad_rate # KS值good_point.append(good_rate)bad_point.append(bad_rate)diff_point.append(diff)ks_value = max(diff_point) # 获得最大KS值为KS值ks_x_axis = diff_point.index(ks_value) # KS值下的阈值点索引ks_good_point, ks_bad_point = good_point[ks_x_axis], bad_point[ks_x_axis] # 阈值下好坏客户在组内的占比threshold = x_axis_range[ks_x_axis] # 阈值plt.plot(x_axis_range, good_point, color="green", label="好企业比率")plt.plot(x_axis_range, bad_point, color="red", label="坏企业比例")plt.plot(x_axis_range, diff_point, color="darkorange", alpha=0.5)plt.plot([threshold, threshold], [0, 1], linestyle="--", color="black", alpha=0.3, linewidth=2)plt.scatter([threshold], [ks_good_point], color="white", edgecolors="green", s=15)plt.scatter([threshold], [ks_bad_point], color="white", edgecolors="red", s=15)plt.scatter([threshold], [ks_value], color="white", edgecolors="darkorange", s=15)plt.title("KS={:.3f} threshold={:.3f}".format(ks_value, threshold))plt.text(threshold + 0.02, ks_good_point + 0.05, round(ks_good_point, 2))plt.text(threshold + 0.02, ks_bad_point + 0.05, round(ks_bad_point, 2))plt.text(threshold + 0.02, ks_value + 0.05, round(ks_value, 2))plt.legend(loc=4)plt.grid()plt.show()ks_plot(y_pred[:,1], y_train)得到结果:
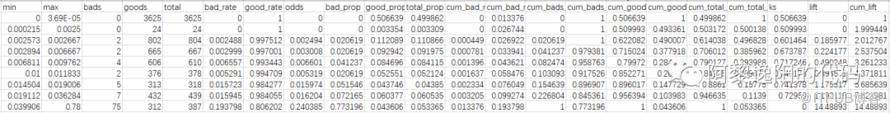
可以发现分类随机森林模型的KS值为0.743。为了看得更清楚,用toad包打印一下KS表,代码如下: import toadd1 = toad.metrics.KS_bucket(y_pred[:, 1], y_train,bucket=20,method='quantile')d1得到结果:
从上表知KS值为0.743,且当预测概率大于0.039时,能抓到75个坏客户,这一箱的lift为14。 5 创建和训练回归随机森林模型
上一节用分类随机森林模型训练了数据,为了对比,这一节用回归随机森林模型训练数据。
代码如下:
rf2 = RandomForestRegressor(n_estimators=100, max_depth=None, random_state=42)# 使用训练数据进行训练rf2.fit(X_train, y_train)# 使用测试数据进行预测y_pred2 = rf2.predict(X_train)ks_plot(y_pred2, y_train)得到结果:
可以发现,应用分类随机森林和回归随机森林训练数据得到的结果差不多,KS 都是0.74左右。
用toad包看下ks表,代码如下:
d2 = toad.metrics.KS_bucket(y_pred2, y_train,bucket=20,method='quantile')d2得到结果:
从上表可以发现分20箱时KS值变成了0.746,和KS图中的0.739不一样。
这是由于分箱数量不一致导致的,感兴趣的可以测试调整下分箱数,当设置为10时,结果就一致了。
机灵的小伙伴应该发现了,如果单看KS去评价模型好坏的话。在模型算法和参数没有做任何调整的前提下,计算KS时多分些箱也能提升该指标。
至此,随机森林原理和实现已讲解完毕,如想了解更多建模内容,可以翻看公众号中“风控建模”模块相关文章。
【部分群限时免费进】分群讨论学习Python、玩转Python、风控建模【29.9元进】、人工智能、数据分析相关问题,还提供招聘内推信息、优秀文章、学习视频、公众号文章答疑,也可交流工作中遇到的难题。如需添加微信号19967879837,加时备注想进的群,比如风控建模。



一文囊括风控模型搭建(原理+Python实现),持续更新。。。

限时免费加群
19967879837
添加微信号、手机号
原文作者:阿黎逸阳的代码;如有侵权,请联系管理员删除。

