撰文|李佳
1
背景
学习率调整策略(learning rate scheduler),其实单独拎出每一个来看都不难,但是由于方法较多,上来就看文档容易一头雾水, 以OneFlow v0.7.0为例,oneflow.optim.lr_scheduler模块中就包含了14种策略。
有没有一种更好的方法来学习呢?比如可视化出学习率的变化过程,此时,我脑海中突然浮现出Convolution Arithmetic这个经典项目,作者将各种CNN卷积操作以gif形式展示,一目了然。
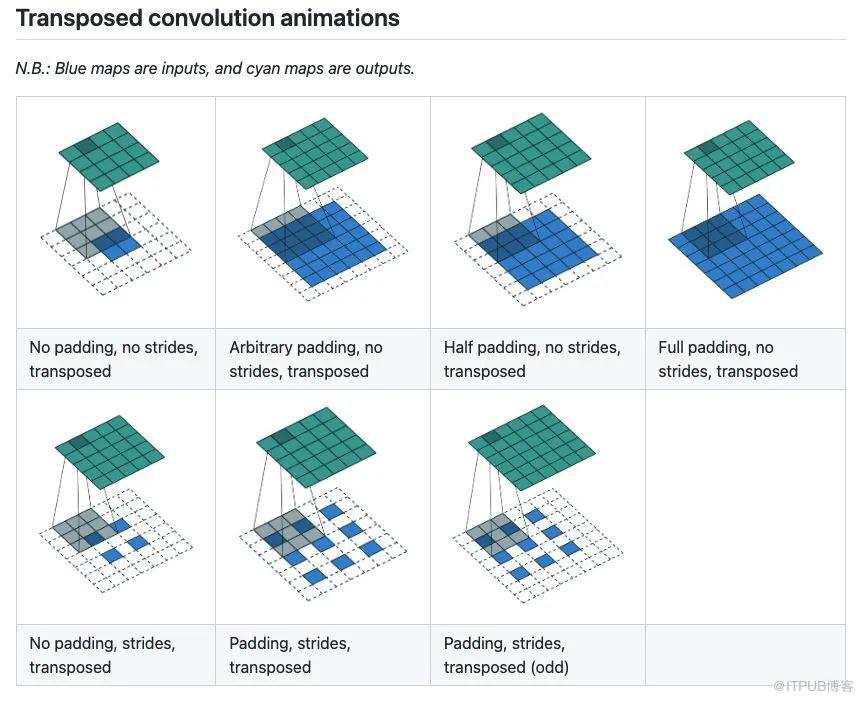
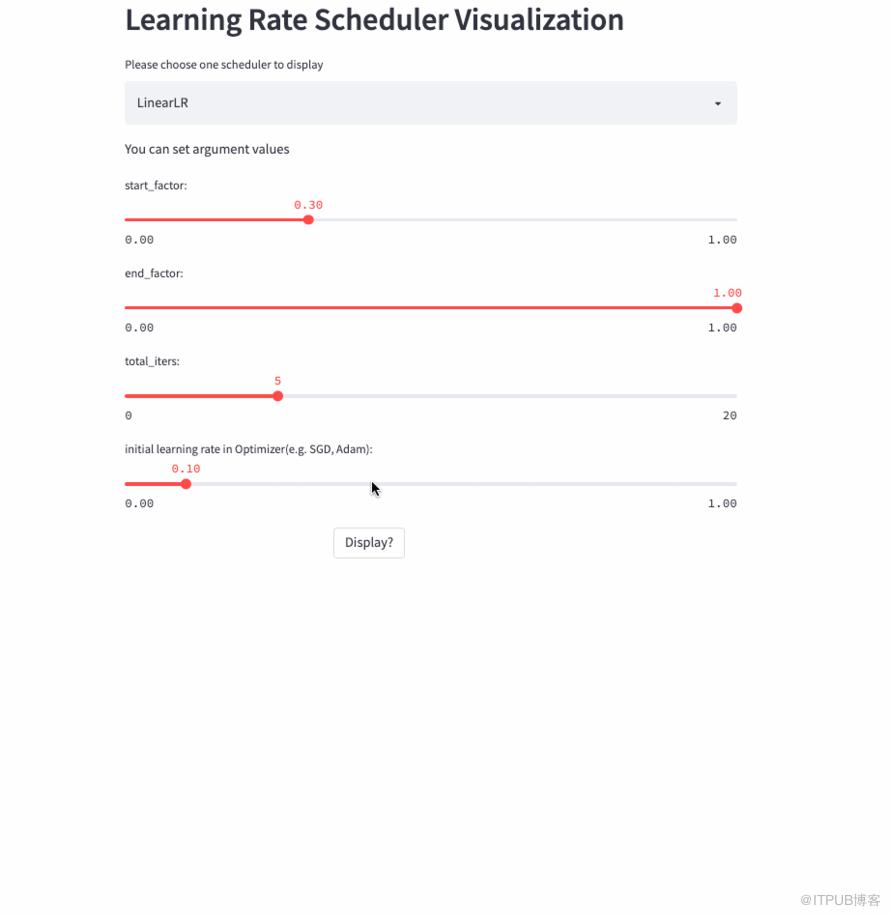
所以,就有了这篇文章,将学习率调整策略可视化出来,下面是两个例子(ConstantLR和LinearLR):
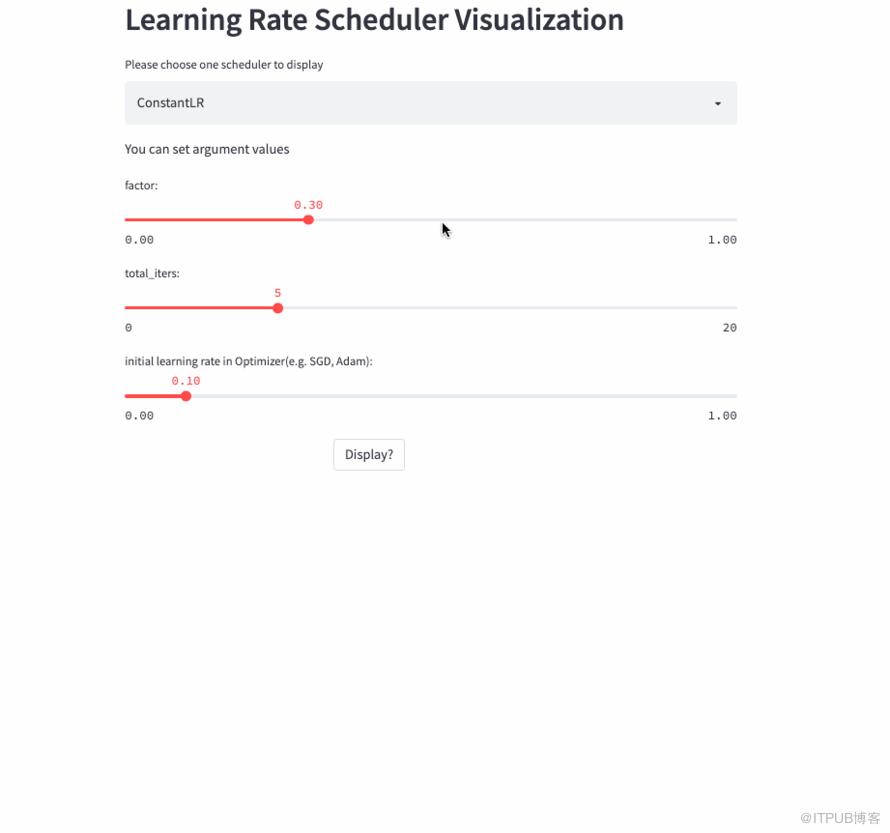
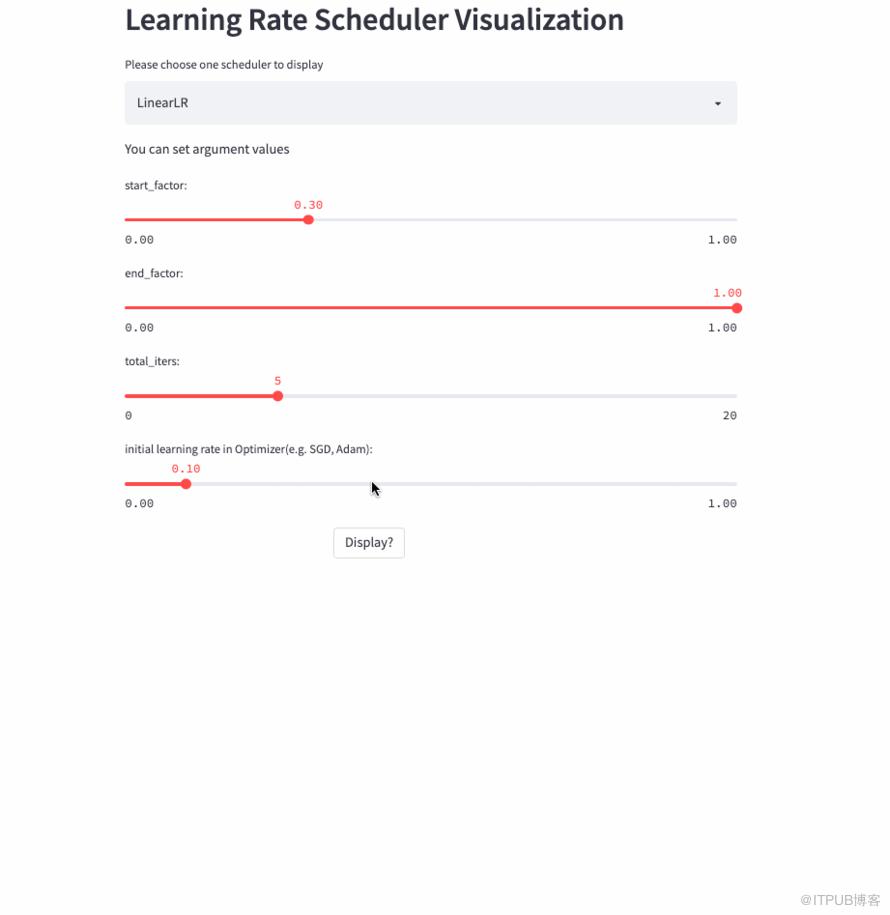
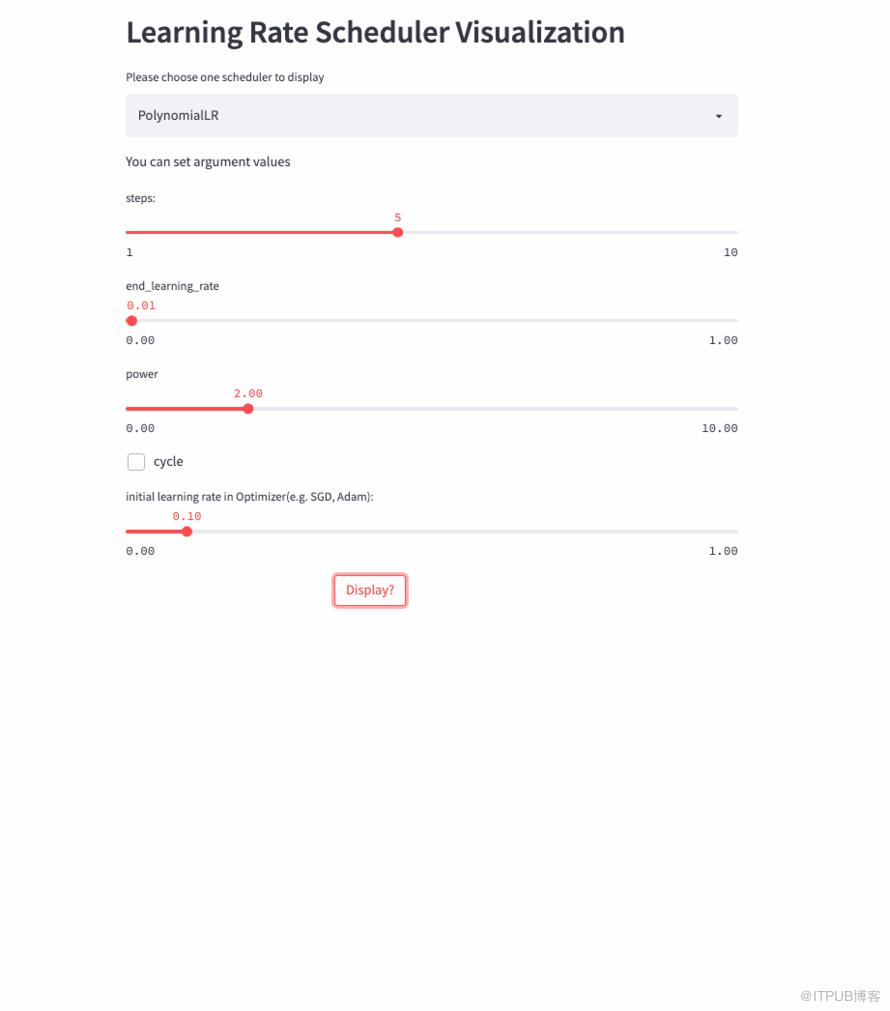
我将可视化代码分别托管在Hugging Face Spaces和Streamlit Cloud,大家可以任选一个链接访问,然后自由调节参数,感受学习率的变化过程。
https://huggingface.co/spaces/basicv8vc/learning-rate-scheduler-online https://share.streamlit.io/basicv8vc/scheduler-online
2
学习率调整策略
基类LRScheduler
LRScheduler(optimizer: Optimizer, last_step: int = -1, verbose: bool = False)是所有学习率调度器的基类,初始化参数中last_step和verbose一般不需要设置,前者主要和checkpoint相关,后者则是在每次step() 调用时打印学习率,可以用于 debug。LRScheduler中最重要的方法是step(),这个方法的作用就是修改用户设置的初始学习率,然后应用到下一次的Optimizer.step()。
有些资料会讲LRScheduler根据epoch或iteration/step来调整学习率,两种说法都没问题,实际上,LRScheduler并不知道当前训练到第几个epoch或第几个iteration/step,只记录了调用step()的次数(last_step),如果每个epoch调用一次,那就是根据epoch来调整学习率,如果每个mini-batch调用一次,那就是根据iteration来调整学习率。以训练Transformer模型为例,需要在每个iteration调用step()。
简单来说,LRScheduler根据调整策略本身、当前调用step()的次数(last_step)和用户设置的初始学习率来得到下一次梯度更新时的学习率。
ConstantLR
oneflow.optim.lr_scheduler.ConstantLR(optimizer: Optimizer,factor: float = 1.0 / 3,total_iters: int = 5,last_step: int = -1,verbose: bool = False,)
注意:由于factor取值[0, 1],所以这是一个学习率递增的策略。
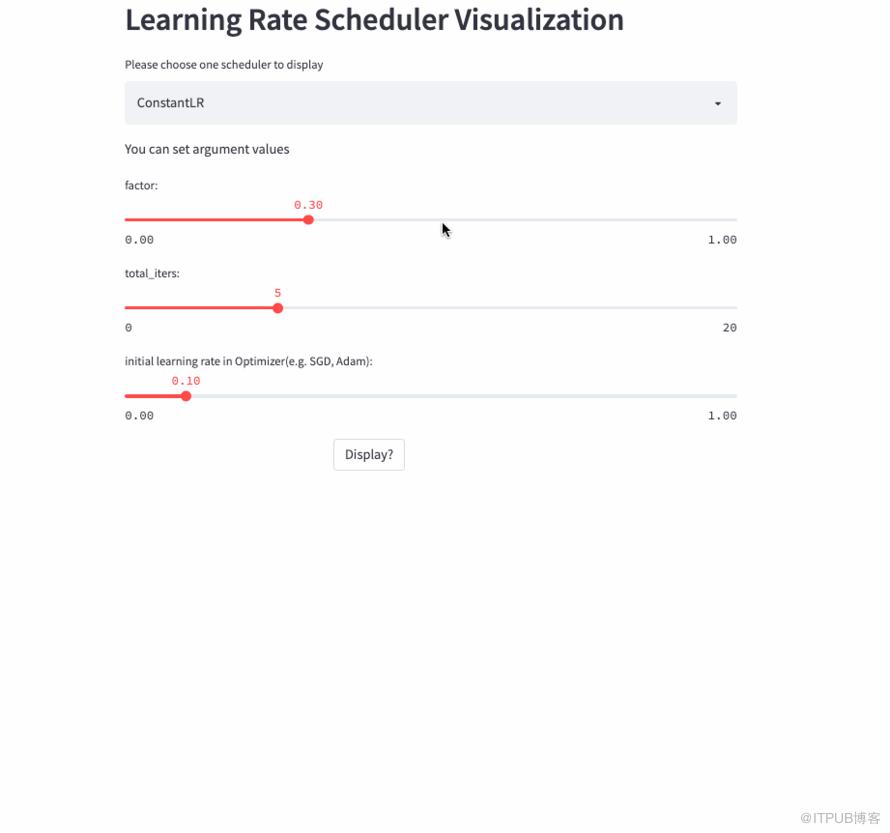
ConstantLR
LinearLR
oneflow.optim.lr_scheduler.LinearLR(optimizer: Optimizer,start_factor: float = 1.0 / 3,end_factor: float = 1.0,total_iters: int = 5,last_step: int = -1,verbose: bool = False,)
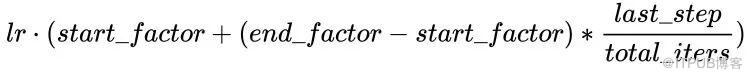
注意:学习率在前total_iters是递增or递减由start_factor和end_factor大小决定。
ExponentialLR
oneflow.optim.lr_scheduler.ExponentialLR(optimizer: Optimizer,gamma: float,last_step: int = -1,verbose: bool = False,)
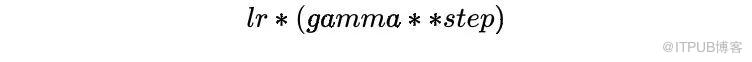
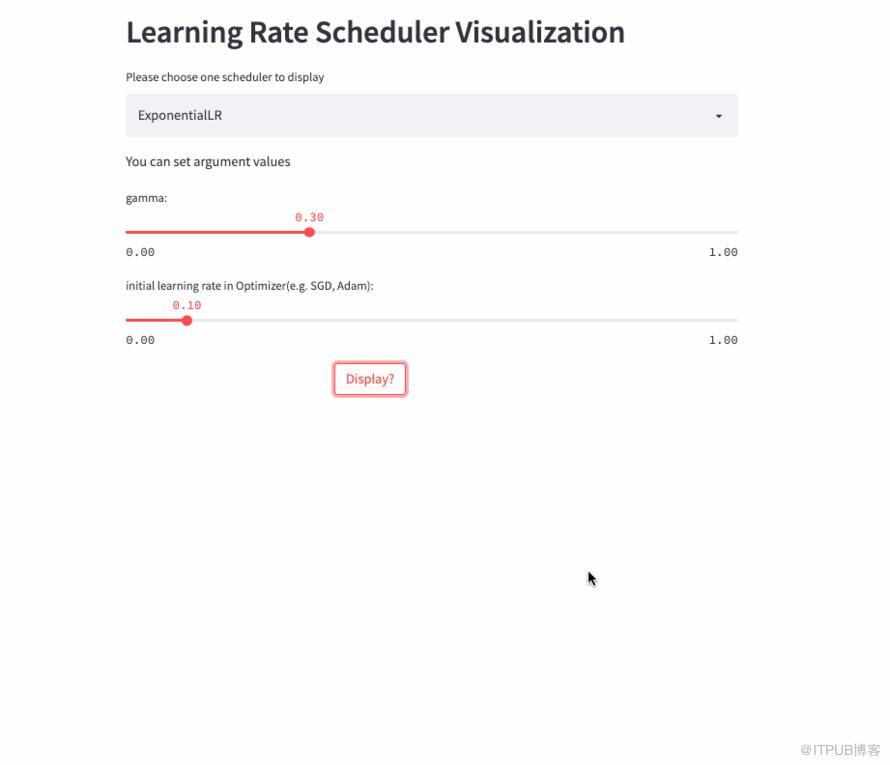
StepLR
oneflow.optim.lr_scheduler.StepLR(optimizer: Optimizer,step_size: int,gamma: float = 0.1,last_step: int = -1,verbose: bool = False,)
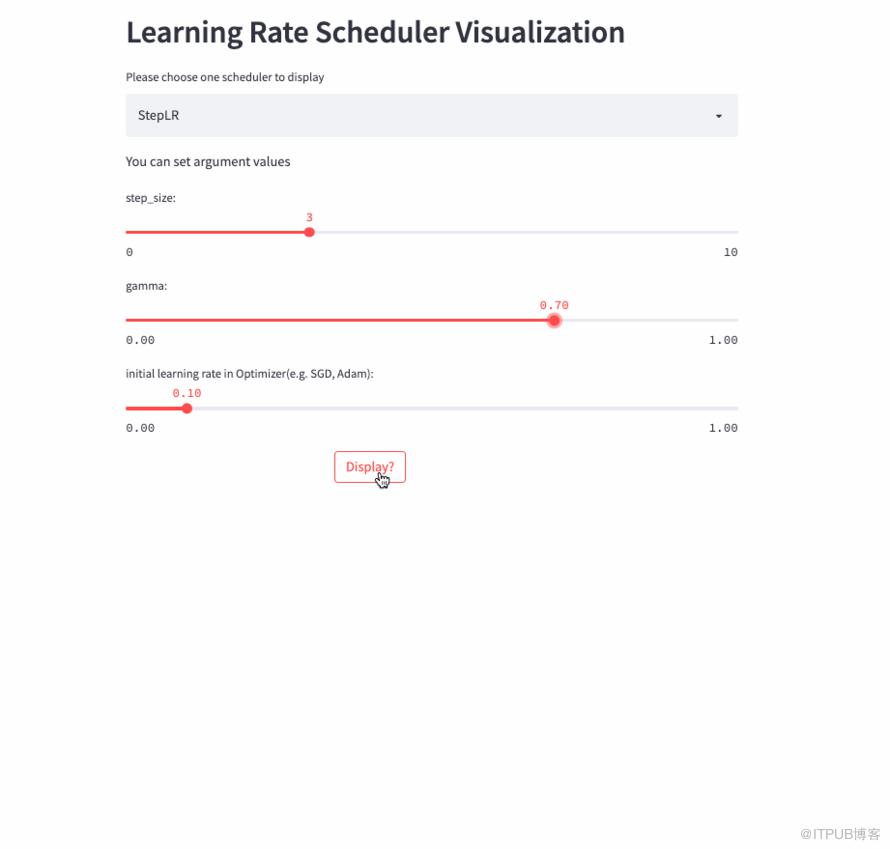
MultiStepLR
oneflow.optim.lr_scheduler.MultiStepLR(optimizer: Optimizer,milestones: list,gamma: float = 0.1,last_step: int = -1,verbose: bool = False,)
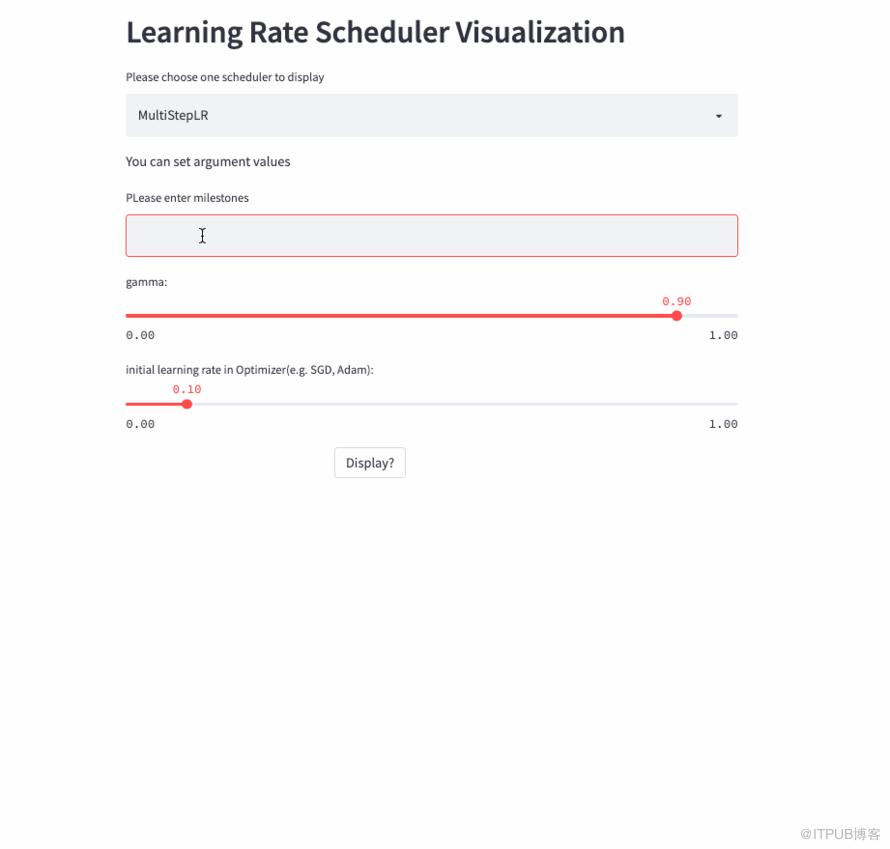
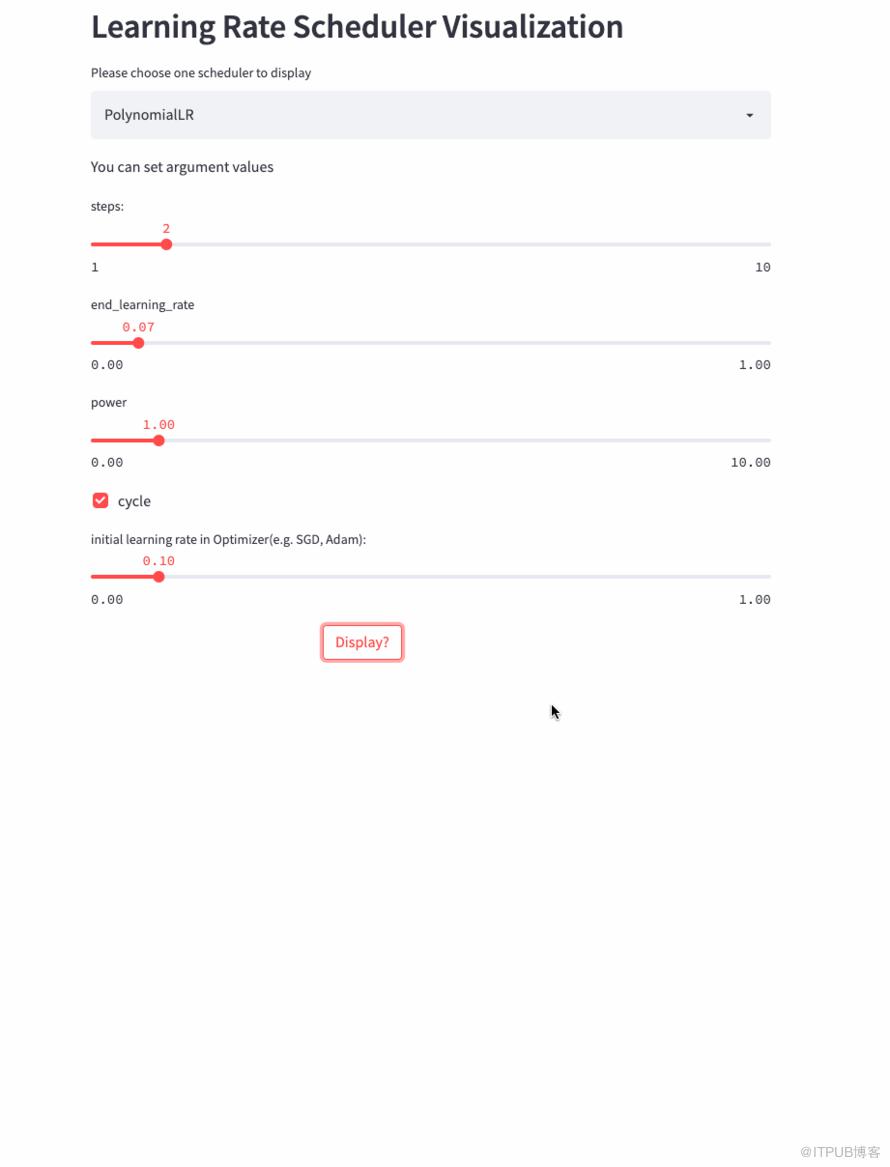
PolynomialLR
oneflow.optim.lr_scheduler.PolynomialLR(optimizer,steps: int,end_learning_rate: float = 0.0001,power: float = 1.0,cycle: bool = False,last_step: int = -1,verbose: bool = False,)
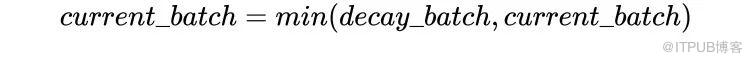
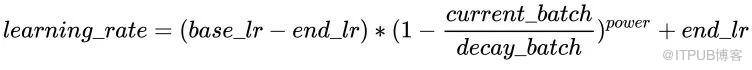
注:公式中的decay_batch就是steps,current_batch就是最新的last_step。
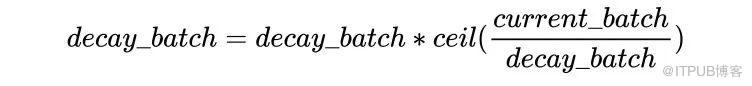
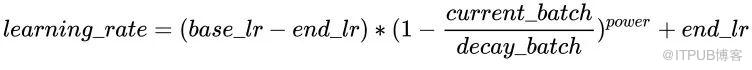
CosineDecayLR
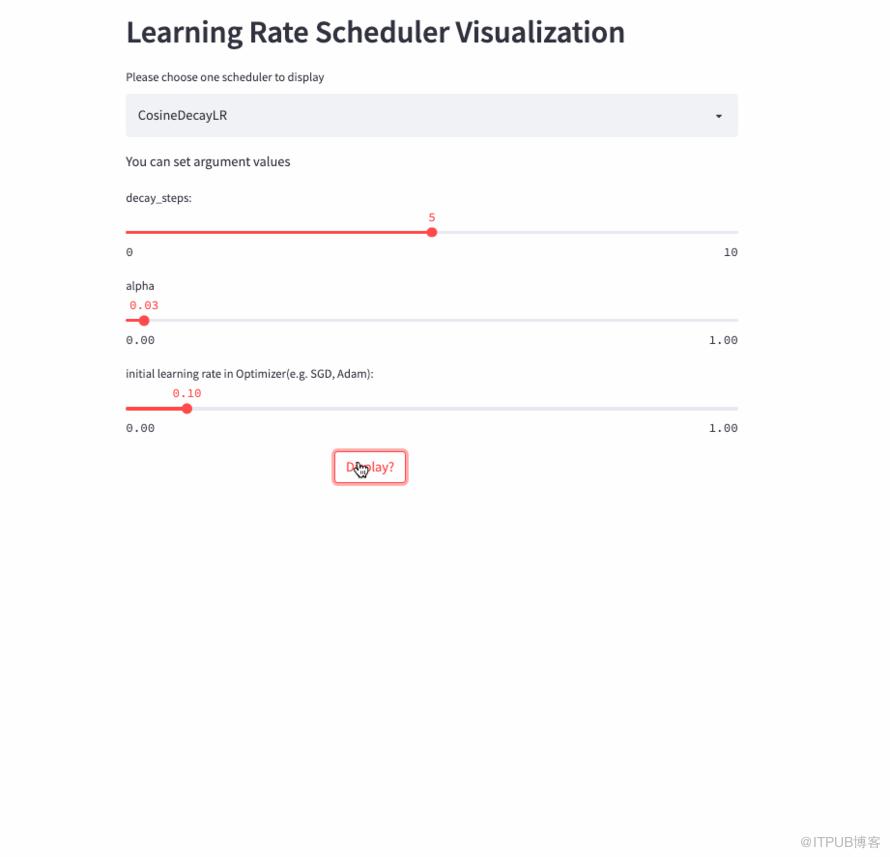
oneflow.optim.lr_scheduler.CosineDecayLR(optimizer: Optimizer,decay_steps: int,alpha: float = 0.0,last_step: int = -1,verbose: bool = False,)
注:CosineDecayLR是为了对齐TensorFlow中的CosineDecay。
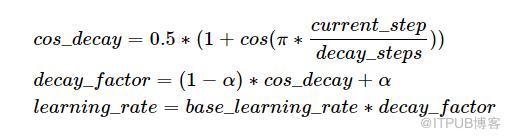
CosineAnnealingLR
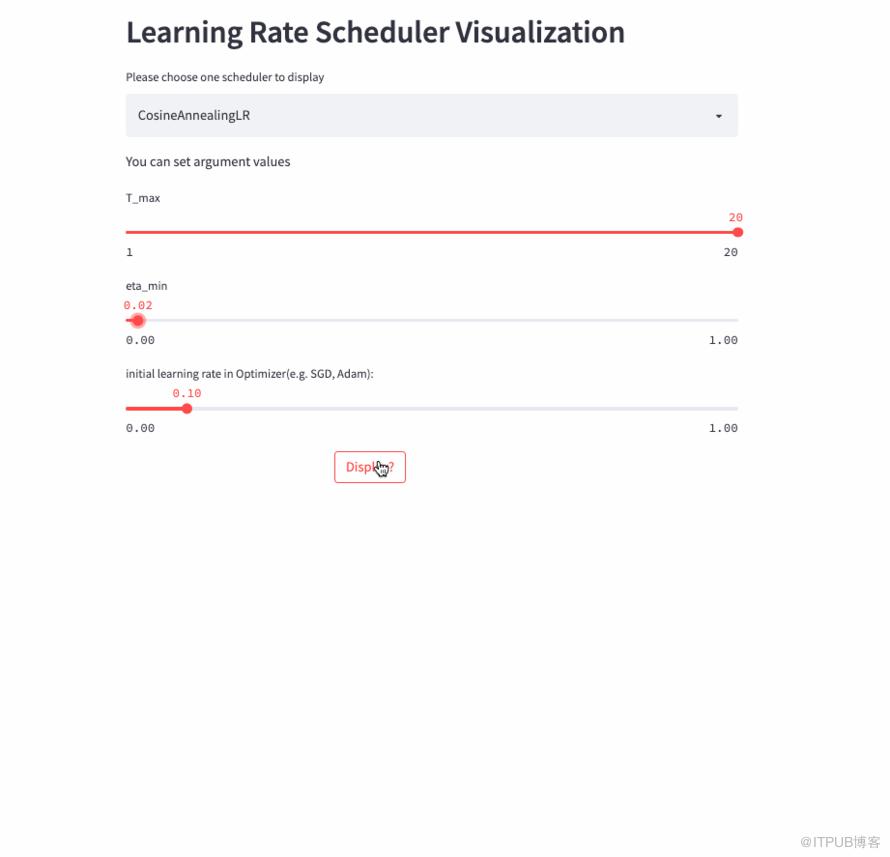
oneflow.optim.lr_scheduler.CosineAnnealingLR(optimizer: Optimizer,T_max: int,eta_min: float = 0.0,last_step: int = -1,verbose: bool = False,)
CosineAnnealingWarmRestarts
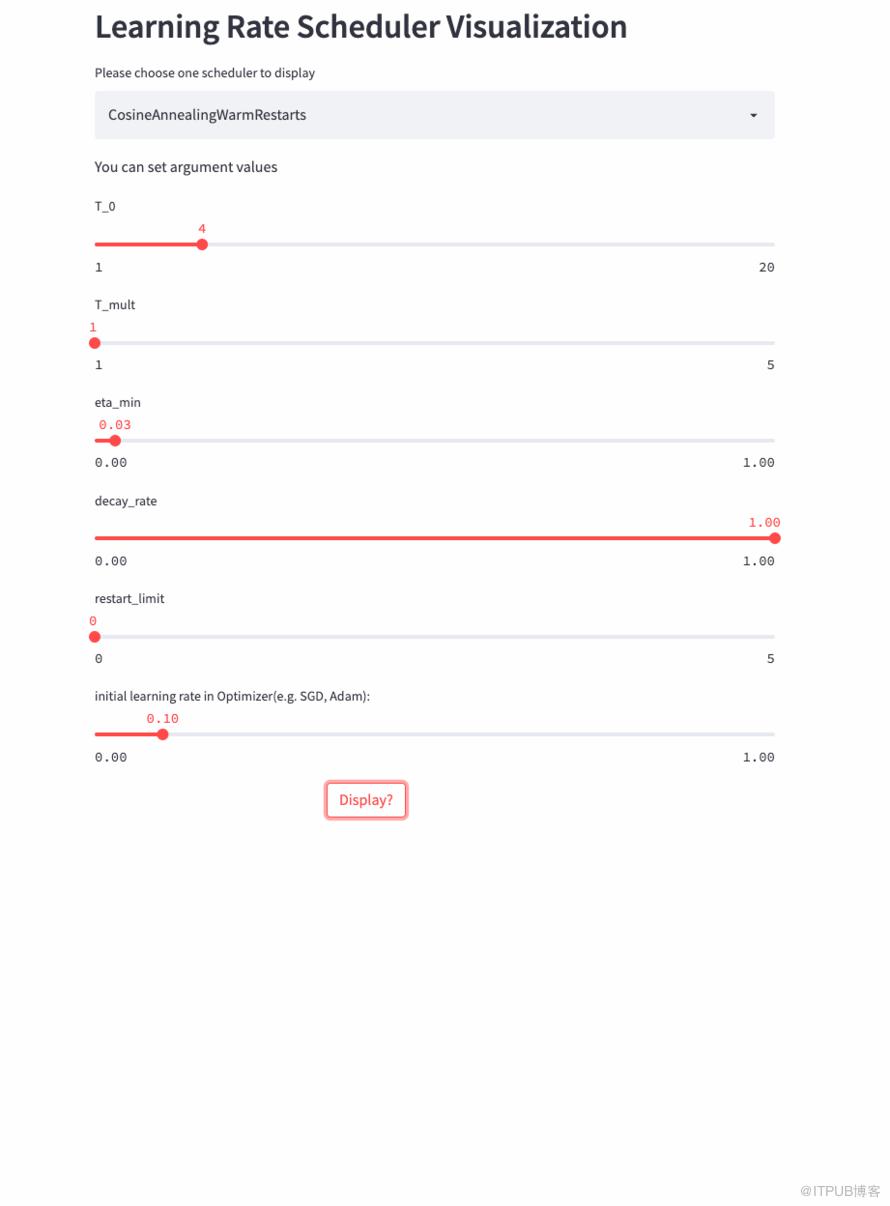
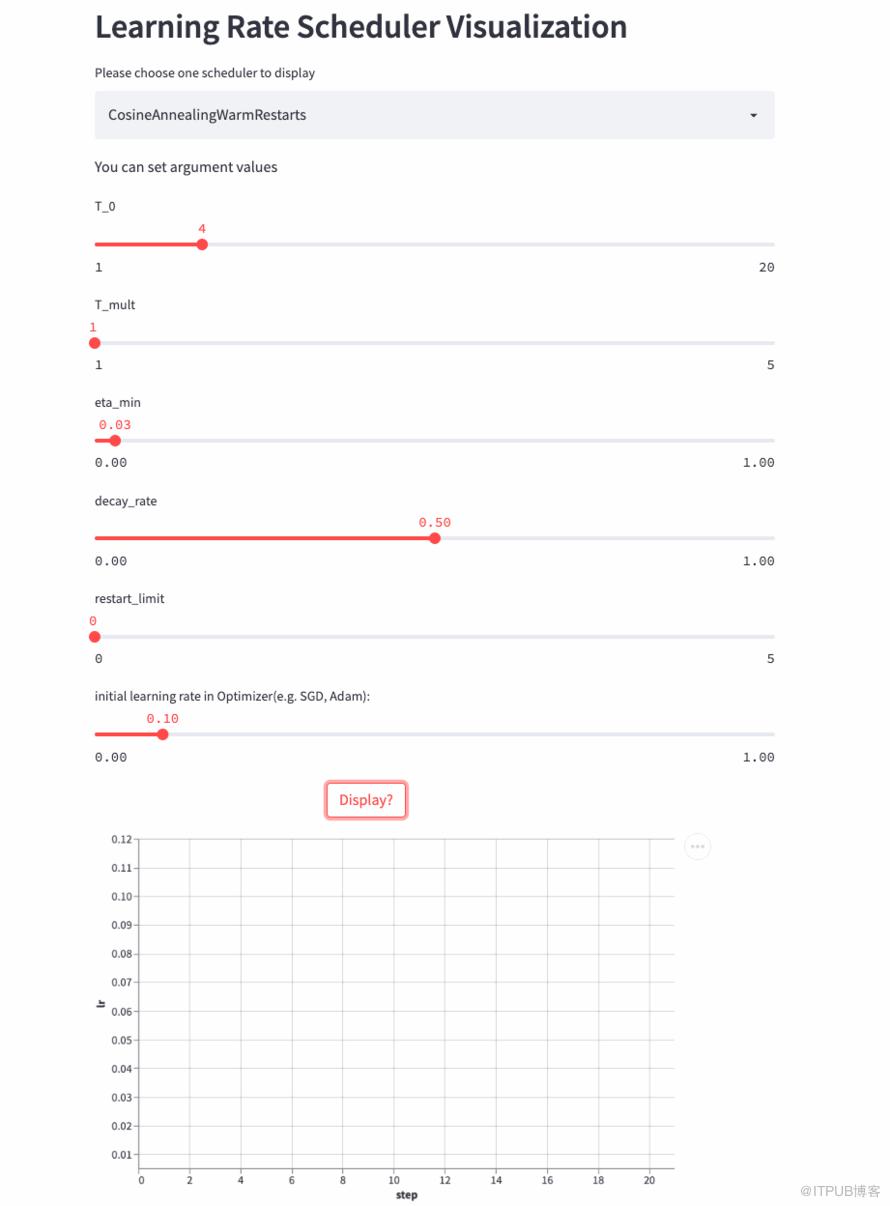
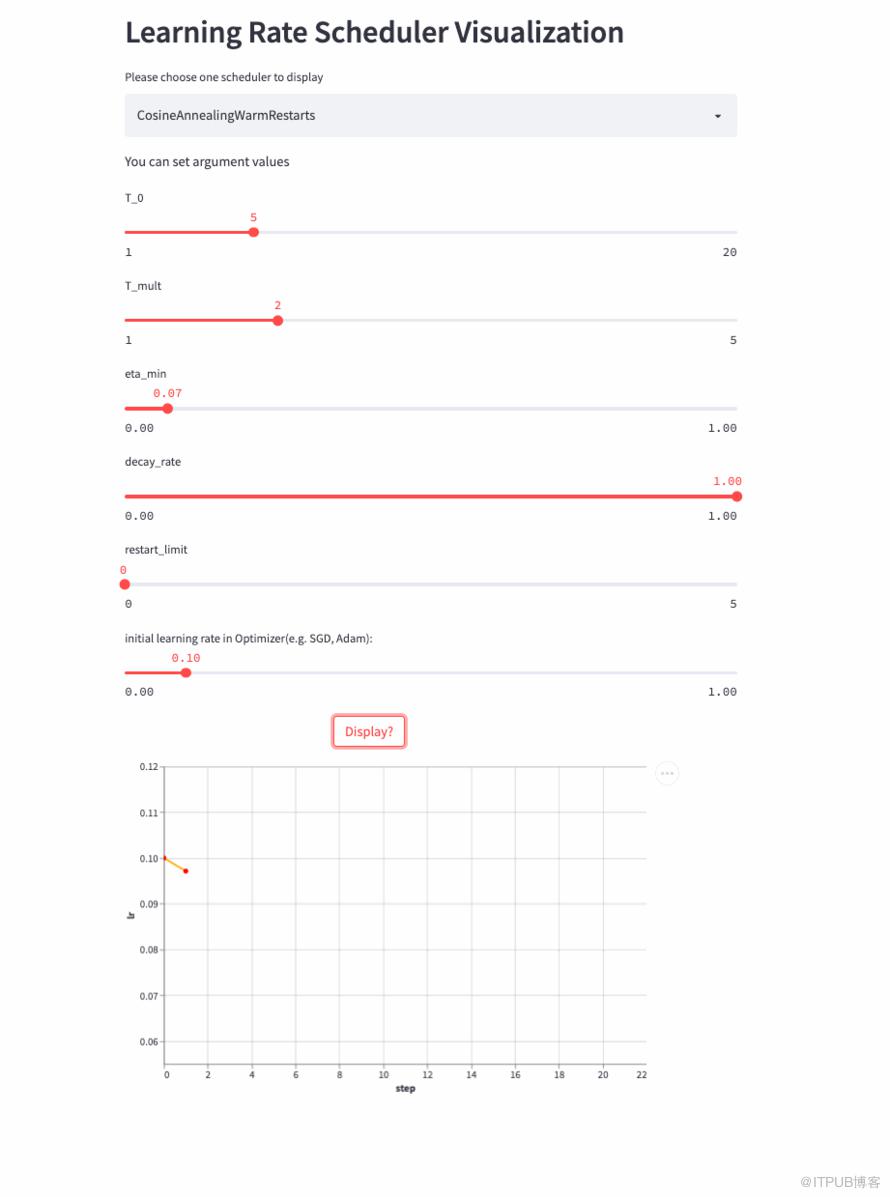
oneflow.optim.lr_scheduler.CosineAnnealingWarmRestarts(optimizer: Optimizer,T_0: int,T_mult: int = 1,eta_min: float = 0.0,decay_rate: float = 1.0,restart_limit: int = 0,last_step: int = -1,verbose: bool = False,)
上面三个Cosine相关的LRScheduler来自同一篇论文(SGDR: Stochastic Gradient Descent with Warm Restarts),这个参数比较多,首先看T_mul,如果T_mul=1,则学习率等周期变化,周期大小就是T_0,也就是由最大学习率衰减到最小学习率的步数(steps),注意如果decay_rate<1,则每个周期的最大学习率和最小学习率都在衰减,第一个周期由lr开始衰减,第二个周期由lr * decay_rate开始衰减,第三个周期由lr * (decay_rate ** 2)开始衰减。
如果T_mult>1,则学习率不是等周期变化,每个周期的大小是上一个周期大小T_mult,第一个周期是T_0,第二个周期是T_0 * T_mult,第三个周期是 T_0 * T_mult * T_mult。
再来看restart_limit,默认值是0,就是上面的过程,如果>0,物理含义是周期数量,假设为3,则只有三次从最大衰减到最小,然后学习率一直是eta_min,不再周期变化了。
先看个T_mult=1的例子,此时decay_rate=1,

3
组合调度策略
LambdaLR
oneflow.optim.lr_scheduler.LambdaLR(optimizer, lr_lambda, last_step=-1, verbose=False)LambdaLR可以说是最灵活的策略了,因为具体的方法是根据函数lr_lambda来指定的。比如实现Transformer中的Noam Scheduler:
def rate(step, model_size, factor, warmup):"""we have to default the step to 1 for LambdaLR functionto avoid zero raising to negative power."""if step == 0:step = 1return factor * (model_size ** (-0.5) * min(step ** (-0.5), step * warmup ** (-1.5)))model = CustomTransformer(...)optimizer = flow.optim.Adam(model.parameters(), lr=1.0, betas=(0.9, 0.98), eps=1e-9)lr_scheduler = LambdaLR(optimizer=optimizer,lr_lambda=lambda step: rate(step, d_model, factor=1, warmup=3000),)
注意:OneFlow的Graph模式并不支持LambdaLR。
SequentialLR
oneflow.optim.lr_scheduler.SequentialLR(optimizer: Optimizer,schedulers: Sequence[LRScheduler],milestones: Sequence[int],interval_rescaling: Union[Sequence[bool], bool] = False,last_step: int = -1,verbose: bool = False,)
WarmupLR
oneflow.optim.lr_scheduler.WarmupLR(scheduler_or_optimizer: Union[LRScheduler, Optimizer],warmup_factor: float = 1.0 / 3,warmup_iters: int = 5,warmup_method: str = "linear",warmup_prefix: bool = False,last_step=-1,verbose=False,)
ChainedScheduler
oneflow.optim.lr_scheduler.ChainedScheduler(schedulers)lr ==> LRScheduler_1 ==> LRScheduler_2 ==> ... ==> LRScheduler_NReduceLROnPlateau
oneflow.optim.lr_scheduler.ReduceLROnPlateau(optimizer,mode="min",factor=0.1,patience=10,threshold=1e-4,threshold_mode="rel",cooldown=0,min_lr=0,eps=1e-8,verbose=False,)
前面提到的所有LRScheduler都是根据当前的step来计算学习率,而在模型训练过程中,我们最关心的是训练集和验证集上面的指标,能不能利用这些指标来指导学习率变化呢?这时候可以用ReduceLROnPlateau,如果某项指标多个step都未发生显著变化,则学习率进行线性衰减。
optimizer = flow.optim.SGD(model.parameters(), lr=0.1, momentum=0.9)scheduler = flow.optim.lr_scheduler.ReduceLROnPlateau(optimizer, 'min')for epoch in range(10):train(...)val_loss = validate(...)scheduler.step(val_loss)
4
实践
如果看到这里有点意犹未尽的感觉,不如动手实践一下,下面是我根据官方的图片分类实例改写的CIFAR-100例子,可以设置不同的学习率调度策略来感受下差异
https://github.com/basicv8vc/oneflow-cifar100-lr-scheduler

原文作者:OneFlow;如有侵权,请联系管理员删除。

