ITPub博客

首页 > 数据库 > 数据库开发技术 > OneFlow源码解析:Op、Kernel与解释器

OneFlow源码解析:Op、Kernel与解释器

原创 数据库开发技术 作者:OneFlow 时间:2022-07-29 08:03:00 0 删除 编辑

撰文|郑建华
更新|赵露阳


1 
Op与Kernel的注册

继续追踪执行流程会发现,ReluFunctor在构造UserOpExpr时会用到UserOpRegistryMgr管理的Op与Kernel。Op表示算子的描述信息,Kernel在不同设备上实现计算。

注册信息保存在私有的map变量中。UserOpRegistryMgr的头文件
(hhttps://github.com/Oneflow-Inc/oneflow/blob/v0.8.1/oneflow/core/framework/user_op_registry_manager.h)中定义了3个宏,REGISTER_USER_OP、REGISTER_USER_OP_GRAD、REGISTER_USER_KERNEL分别用于注册op、grad_op、kernel。
 

1.1 ReluOp的注册

REGISTER_USER_OP负责UserOp的注册。通过检索代码可以找到这个宏的使用场景。ReluOp相关的源代码在这3个文件中:

  • class定义:
    build/oneflow/core/framework/op_generated.h
  • 注册op、op的部分实现:
    build/oneflow/core/framework/op_generated.cpp
  • 主要实现:
    oneflow/oneflow/user/ops/relu_op.cpp

REGISTER_USER_OP宏在op_generated.cpp中展开后代码如下:

static UserOpRegisterTrigger<OpRegistry> g_register_trigger715 = ::oneflow::user_op::UserOpRegistryMgr::Get() .CheckAndGetOpRegistry("relu") .Input("x") .Output("y") .SetGetSbpFn(&ReluOp::GetSbp) .SetLogicalTensorDescInferFn(&ReluOp::InferLogicalTensorDesc) .SetPhysicalTensorDescInferFn(&ReluOp::InferPhysicalTensorDesc) .SetDataTypeInferFn(&ReluOp::InferDataType);
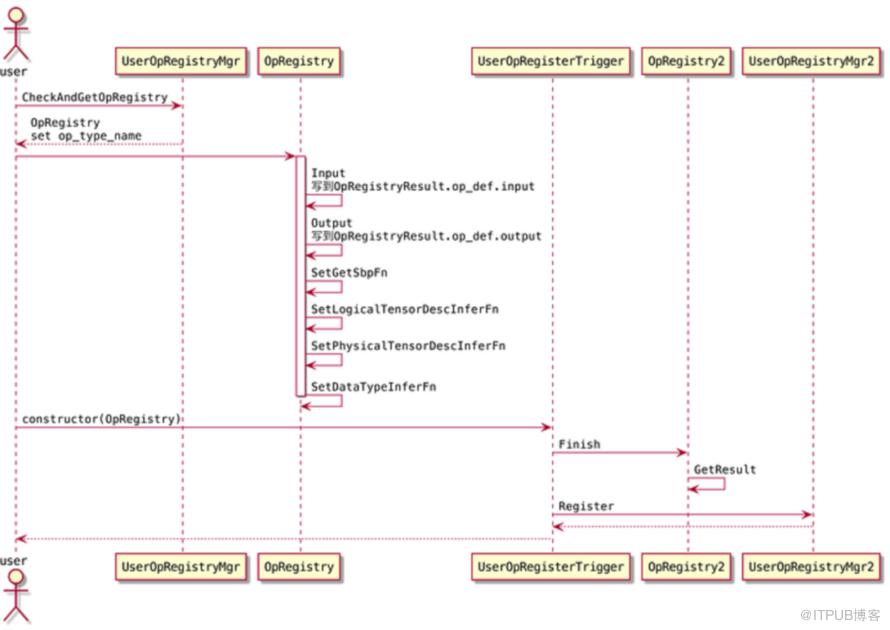
调用流程如下:

 
CheckAndGetOpRegistry
(https://github.com/Oneflow-Inc/oneflow/blob/v0.8.1/oneflow/core/framework/user_op_registry_manager.cpp#L33)会创建一个OpRegistry(https://github.com/Oneflow-Inc/oneflow/blob/v0.8.1/oneflow/core/framework/user_op_registry.h#L91)对象,这个类和UserOpRegisterTrigger(https://github.com/Oneflow-Inc/oneflow/blob/v0.8.1/oneflow/core/framework/user_op_registry_manager.h#L63)类一样,只是为构造OpRegistryResult(https://github.com/Oneflow-Inc/oneflow/blob/v0.8.1/oneflow/core/framework/user_op_registry.h#L62)用的中间类型。

OpRegistry会暂存中间结果并在Finish中设置一些默认推导逻辑。UserOpRegisterTrigger的构造函数会调用注册逻辑。静态变量就是为了触发构造函数从而调用注册逻辑,将构造好的OpRegistryResult保存到UserOpRegistryMgr(https://github.com/Oneflow-Inc/oneflow/blob/v0.8.1/oneflow/core/framework/user_op_registry_manager.h#L29)(key是op_type,如relu)。

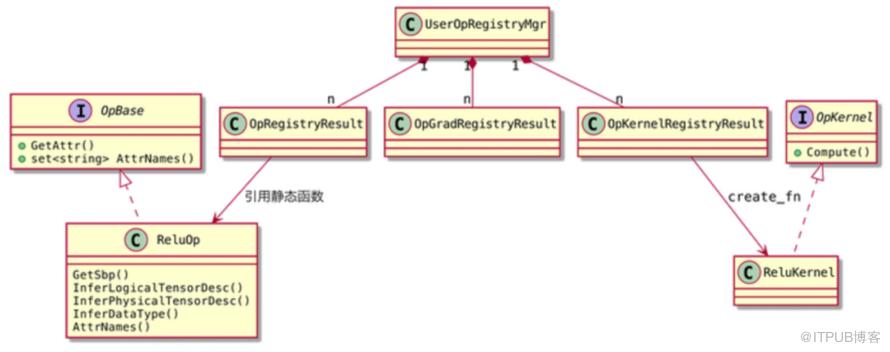
ReluOp表示一个具体的op_type,负责为OpRegistryResult提供Op特有的方法。

OpRegistryResult把不同的Op抽象为一个通用的结构(便于统一注册管理),主要包含描述信息,保存了op的输入输出描述,以及数据类型、sbp等的推导逻辑函数。对于relu来说,主要是记录了几个推导函数要调用ReluOp的静态方法;op_def主要包含input/output的名字。
 

1.2 ReluKernel的注册

ReluKernel在relu_kernel.cpp中注册,过程和Op的注册类似。REGISTER_USER_KERNEL宏产开后如下所示:

static UserOpRegisterTrigger<OpKernelRegistry> g_register_trigger0 = UserOpRegistryMgr::Get(). CheckAndGetOpKernelRegistry("relu"). .SetCreateFn(...) .SetIsMatchedHob(UnaryPrimitiveExists(ep::primitive::UnaryOp::kRelu, "y", "x")) .SetInplaceProposalFn([](const user_op::InferContext&, const user_op::AddInplaceArgPair& AddInplaceArgPairFn) -> Maybe<void> { OF_RETURN_IF_ERROR(AddInplaceArgPairFn("y", 0, "x", 0, true)); return Maybe<void>::Ok(); });

注意SetCreateFn只是把一个如下的lambda表达式赋值给result_.create_fn,这个字段很重要,后续执行就是通过它获取kernel。

[]() { return user_op::NewOpKernel<UnaryPrimitiveKernel>( "y", "x", [](user_op::KernelComputeContext* ctx) { const user_op::TensorDesc* src = ctx->TensorDesc4ArgNameAndIndex("x", 0); const user_op::TensorDesc* dst = ctx->TensorDesc4ArgNameAndIndex("y", 0); return ep::primitive::NewPrimitive<ep::primitive::ElementwiseUnaryFactory>( ctx->device_type(), ep::primitive::UnaryOp::kRelu, src->data_type(), dst->data_type()); });}

对于relu来说,NewOpKernel就是new一个UnaryPrimitiveKernel对象并返回函数指针。


最终注册的结果,会把OpKernelRegistryResult保存到UserOpRegistryMgr(key是op_type_name,如"relu")。
 

1.3 Op和Kernel注册相关的类关系图

 
2
UserOpExpr的构造

上一篇提到,functional_api.yaml.cpp中的functional::Relu函数通过find("Relu")获取预先注册的PackedFunctor<impl::ReluFunctor>,调用其call方法会执行impl::ReluFunctor。

ReluFunctor
(https://github.com/Oneflow-Inc/oneflow/blob/v0.8.1/oneflow/core/functional/impl/activation_functor.cpp#L38)的核心代码如下:

class ReluFunctor { public:  ReluFunctor() { op_ = CHECK_JUST(one::OpBuilder("relu").Input("x", 1).Output("y", 1).Build()); }  Maybe<Tensor> operator()(const std::shared_ptr<Tensor>& x, bool inplace) const {    // 忽略inplace相关逻辑    return OpInterpUtil::Dispatch<Tensor>(*op_, {x});  } private:  std::shared_ptr<OpExpr> op_;};

ReluFunctor
(https://github.com/Oneflow-Inc/oneflow/blob/v0.8.1/oneflow/core/functional/impl/activation_functor.cpp#L40)的构造函数中,主要是构造UserOpExpr(https://github.com/Oneflow-Inc/oneflow/blob/v0.8.1/oneflow/core/framework/op_expr.h#L131)。

每一个user op 通过OpBuilder的Build()后,都会生成相应的UserOpExpr,用于存储属性、类型/shape/设备等推导方法,用于接下来op/kernel的实际计算。UserOpExpr包含以下成员:

  • base_attrs_
  • tensor_desc_infer_fn_
  • dtype_infer_fn_
  • device_and_stream_infer_fn_

它们分别用于存储该user op相关attrs属性、input/output tensor shape推导方法、数据类型data type推导方法、设备及计算流推导方法等。除了常用的UserOpExpr、还有一些用于系统op的BuiltinOpExpr。
 
OpBuilder的Input/Output调用主要是操作UserOpConf的proto对象,Build函数内会修改UserOpConf对象,比如根据OpRegistryResult::op_def补充默认值到attr。

之后构造UserOpExpr对象,UserOpConf对象被保存到UserOpExpr的父类BuiltinOpExprImpl<UserOpConf>的op_proto_字段,对于relu来说,op_proto_主要保存input, output等信息。UserOpExpr初始化时会从OpRegistryResult拷贝函数变量。
 

3 
Functor的执行


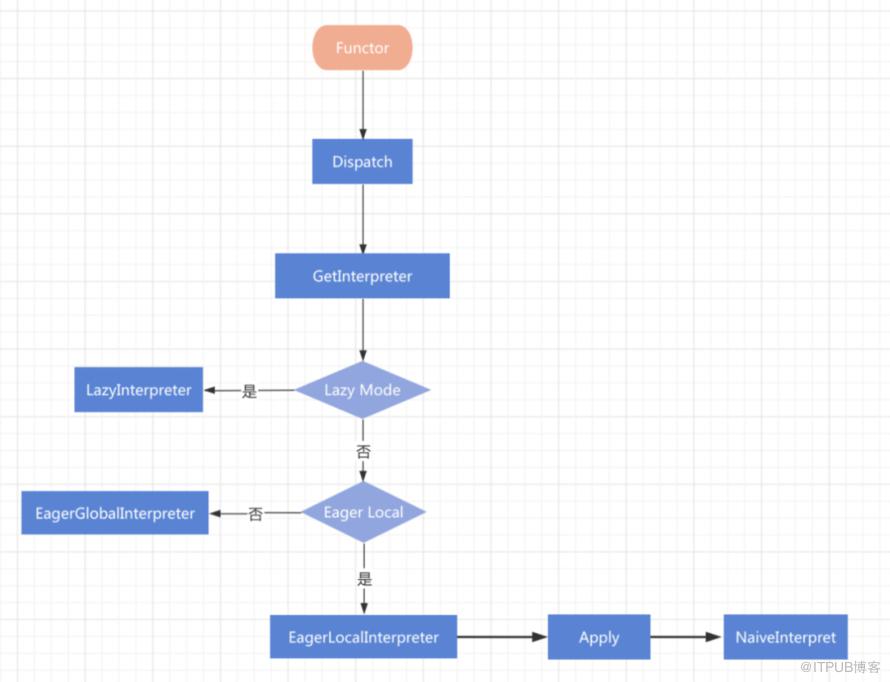
ReluFunctor执行的核心逻辑是调用OpInterpUtil::Dispatch。调运顺序如下:

 
整个链路很长,本篇笔记只以Eager Local Mode下,对主要执行流程做一些说明。

3.1 根据环境和输入选择解释器

Dispatch调用的GetInterpreter(https://github.com/Oneflow-Inc/oneflow/blob/v0.8.1/oneflow/core/framework/op_interpreter/op_interpreter_util.cpp#L147)返回的是一个AutogradInterpreter(https://github.com/Oneflow-Inc/oneflow/blob/v0.8.1/oneflow/core/framework/op_interpreter.h#L168)对象,这个类是在其内含的OpExprInterpreter成员变量基础之上增加了autograd的功能。GetInterpreter内实际构造的是以下3种Interpreter,在Build函数返回时转为AutogradInterpreter。

  • LazyInterpreter: 用于lazy mode下的分布式静态图执行模式
  • EagerLocalInterpreter: 用于eager local mode本地单卡执行模式(和pytorch单卡或DDP对齐)
  • EagerGlobalInterpreter: 用于eager global mode,的分布式动态图执行模式

各个Interpreter的关系如下:

 
GetInterpreter的作用是根据输入和环境等信息,选择一个合适的解释器。

接着在Dispatch中调用解释器的AutogradInterpreter::Apply方法,在这个方法内调用internal_->Apply(...)(https://github.com/Oneflow-Inc/oneflow/blob/v0.8.1/oneflow/core/framework/op_interpreter/op_interpreter.cpp#L111),也就是上述3个解释器的Apply方法。

3.2 Apply

通过上面我们知道,EagerLocalInterpreter、EagerGlobalnterpreter和LazyInterpreter 都将为其包裹上AutogradInterpreter的壳,通过AutogradInterpreter触发Apply的调用。顾名思义,AutogradInterpreter的作用主要是和autograd相关,其主要为eager mode下前向的op节点插入对应的,用于反向计算grad的节点。
 
下面以最常用的(Eager Mode)模式,讲解Apply的执行方法。在Eager Mode(无论是eager local还是eager consistent)模式下,实际都会走到EagerInterpreter的Apply(https://github.com/Oneflow-Inc/oneflow/blob/v0.8.1/oneflow/core/framework/op_interpreter/op_interpreter.cpp#L51)方法:

Maybe<void> EagerInterpreter::Apply(const OpExpr& op_expr, const TensorTuple& inputs,                                    TensorTuple* outputs, const OpExprInterpContext& ctx) const {#define APPLY_IF(op_type)                                              \  if (const auto* op = dynamic_cast<const op_type##Expr*>(&op_expr)) { \    return ApplyImpl(*op, inputs, outputs, ctx);                       \  }  APPLY_IF(UserOp);  APPLY_IF(VariableOp);  APPLY_IF(CastToLocalOp);  APPLY_IF(CastFromLocalOp);  APPLY_IF(GlobalToGlobalOp);  APPLY_IF(CastToGlobalOp);  APPLY_IF(CastFromGlobalOp);  APPLY_IF(DistributeSplitOp);  APPLY_IF(DistributeCloneOp);  APPLY_IF(DistributeConcatOp);  APPLY_IF(DistributeAddOp);  APPLY_IF(FunctionOp);  APPLY_IF(SelectTopNOp)#undef APPLY_IF  OF_UNIMPLEMENTED() << "The type " << op_expr.op_type_name()                     << " has not been supported in EagerInterpreter::Apply.";}

这里通过宏定义APPLY_IF,增加了对不同类型op的分支处理,将op_expr dynamic_cast成相应子类op实现的Expr,如对于大多数用户来说,用到的op都是UserOp类型,所以这里实际上会走到这个分支中:

if (const auto* op = dynamic_cast<const UserOpExpr*>(&op_expr)) { return ApplyImpl(*op, inputs, outputs, ctx);}

再看看EagerLocalInterpreter::ApplyImpl(https://github.com/Oneflow-Inc/oneflow/blob/v0.8.1/oneflow/core/framework/op_interpreter/eager_local_op_interpreter.cpp#L209):

Maybe<void> EagerLocalInterpreter::ApplyImpl(const UserOpExpr& op_expr, const TensorTuple& inputs, TensorTuple* outputs, const OpExprInterpContext& ctx) const { return NaiveInterpret(op_expr, inputs, outputs, ctx);}

其最终实现是NaiveInterpret(https://github.com/Oneflow-Inc/oneflow/blob/v0.8.1/oneflow/core/framework/op_interpreter/eager_local_op_interpreter.cpp#L88)。

3.3 NaiveInterpret

NaiveInterpret简单来说,主要用于做以下四件事:

  • check input tensor的device是否一致
  • 生成output tensor
  • 为output tensor推导和检查shape/stride/dtype
  • 构建op执行指令,并派发至vm

简化版的代码如下:

Maybe<void> NaiveInterpret(const UserOpExpr& user_op_expr, const TensorTuple& inputs,                           const Symbol<Device>& default_device, TensorTuple* outputs,                           const OpExprInterpContext& ctx) {  const auto& attrs = ctx.attrs;  // 检查input tensor是否位于相同device上  ...  // 推导outout tensor的设备类型  // Infer devices  if (!user_op_expr.has_device_and_stream_infer_fn()) {    stream = JUST(GetDefaultStreamByDevice(default_device));    for (int i = 0; i < outputs->size(); i++) {      auto* tensor_impl = JUST(TensorImpl4Tensor(outputs->at(i)));      *JUST(tensor_impl->mut_device()) = default_device;    }  } else {    need_check_mem_case = false;    stream = JUST(user_op_expr.InferDeviceAndStream(attrs, inputs, outputs));  }  // 推导outout tensor的形状、数据类型  // Infer shapes and dtypes  const auto& device_tag = stream->device()->type();  JUST(user_op_expr.InferPhysicalTensorDesc(      attrs, device_tag,      [&](int32_t i) -> const TensorMeta* {        return CHECK_JUST(TensorImpl4Tensor(inputs[i]))->mut_tensor_meta();      },      [&](int32_t i) -> TensorMeta* {        // using thread_local TensorMeta pointer if inplace.        // using tensor_impl TensorMeta pointer if not inplace.        return output_tensor_metas->at(i);      }));  // 为output tensor初始化eager_blob_object  for (int i = 0; i < output_eager_blob_objects->size(); i++) {    auto* tensor_impl = JUST(TensorImpl4Tensor(outputs->at(i)));    if (!output_eager_blob_objects->at(i)) {      if (!JUST(user_op_expr.SupportNonContiguous())) {        std::shared_ptr<Stride> stride(new Stride(*tensor_impl->shape()));        tensor_impl->mut_tensor_meta()->set_stride(stride);      }      const auto& dep_object = NewLocalDepObject();      JUST(tensor_impl->InitEagerBlobObject(dep_object));      output_eager_blob_objects->at(i) = JUST(tensor_impl->eager_blob_object());    } else {      // output i is inplaced.      // check thread_local TensorMeta and tensor_impl TensorMeta.      CHECK_OR_RETURN(tensor_impl->tensor_meta()->shape() == output_tensor_metas->at(i)->shape());      CHECK_OR_RETURN(tensor_impl->tensor_meta()->dtype() == output_tensor_metas->at(i)->dtype());    }  }  // 从user_op_expr中取出kernel  const auto& kernel = JUST(user_op_expr.MutKernel4Stream(stream));  kernel->set_need_check_mem_case(need_check_mem_case);  for (int64_t index : kernel->output_tuple_indexes4mut2_obns()) {    output_eager_blob_objects->at(index)->set_is_shape_synced(false);  }  // kernel dispatch至VM,等待后续实际的调度执行  JUST(PhysicalRun([&](InstructionsBuilder* builder) -> Maybe<void> {    return builder->Call(kernel, input_eager_blob_objects, output_eager_blob_objects, ctx, stream);  }));  return Maybe<void>::Ok();}

PhysicalRun接受一个lambda functor作为参数,这里即InstructionsBuilder->Call方法,该方法接受kernel、input/output的eager blob object、kernel执行的上下文作为参数。Call方法实际会完成OpCall指令的构建,并最终将其派发至vm指令列表中,等待VM实际调度执行。
 

参考资料

  • OneFlow学习笔记:Op注册
  • (https://mp.weixin.qq.com/s/eF-c2irraxnH4iAesURy0Q)
  • 从Functor到OpExprInterpreter
  • https://github.com/Oneflow-Inc/oneflow/tree/v0.8.1
  • https://zhuanlan.zhihu.com/p/523884650
(本文经授权后发布,原文https://segmentfault.com/a/1190000041844858)

其他人都在看
点击“阅读原文”,欢迎体验OneFlow v0.8.0


​

原文作者:OneFlow;如有侵权,请联系管理员删除。

请登录后发表评论 登录
全部评论

注册时间:2020-07-25

  • 博文量
    129
  • 访问量
    54940