 图1:近年来各SOTA神经网络模型的内存与算力需求
1 Cerebras计算核心架构
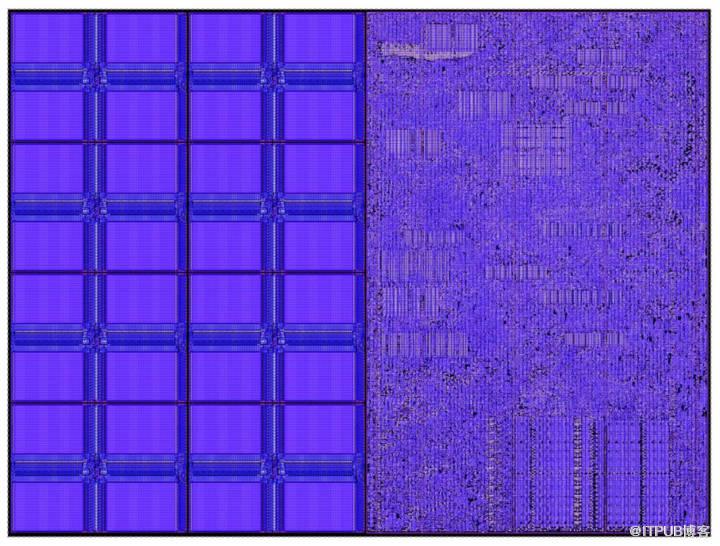 图2:Cerebras计算核心
 图3:Cerebras计算核心的内存设计:每个核心配有独立内存。
2
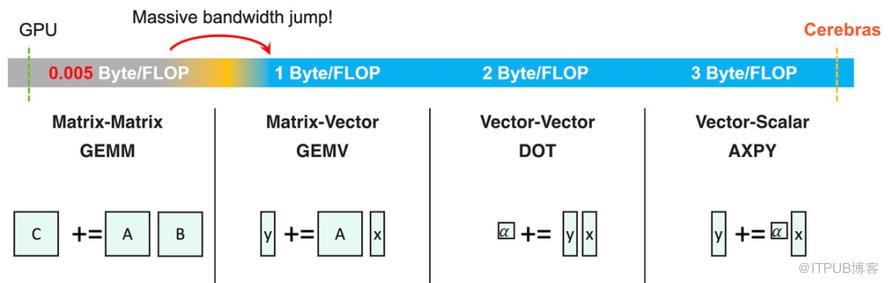
所有BLAS级别的极致性能
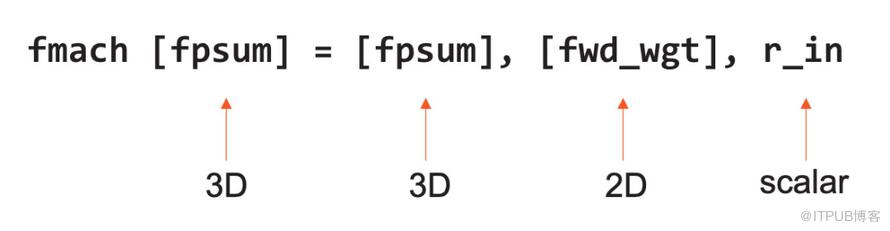 等式1,FMAC指令示例
3 细粒度数据流调度
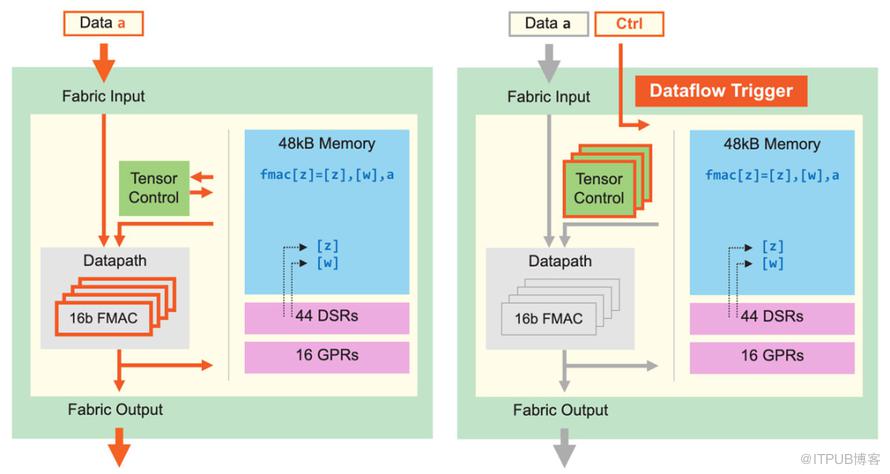 图5:核心数据通路及核心数据流调度。细粒度动态计算核心可提升计算性能,稀疏利用率为GPU的10倍。
4 纵向扩展:超越摩尔定律
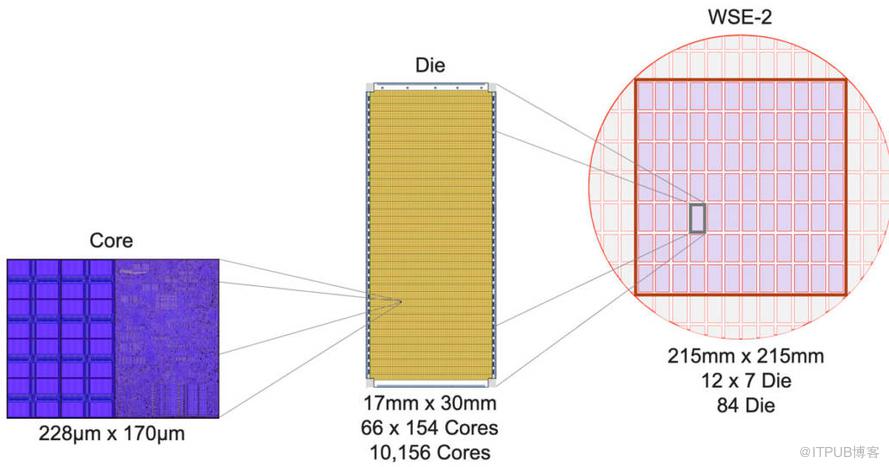
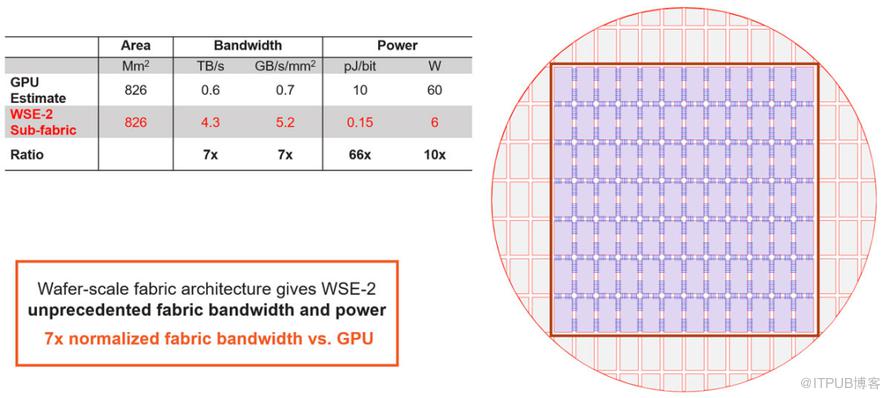
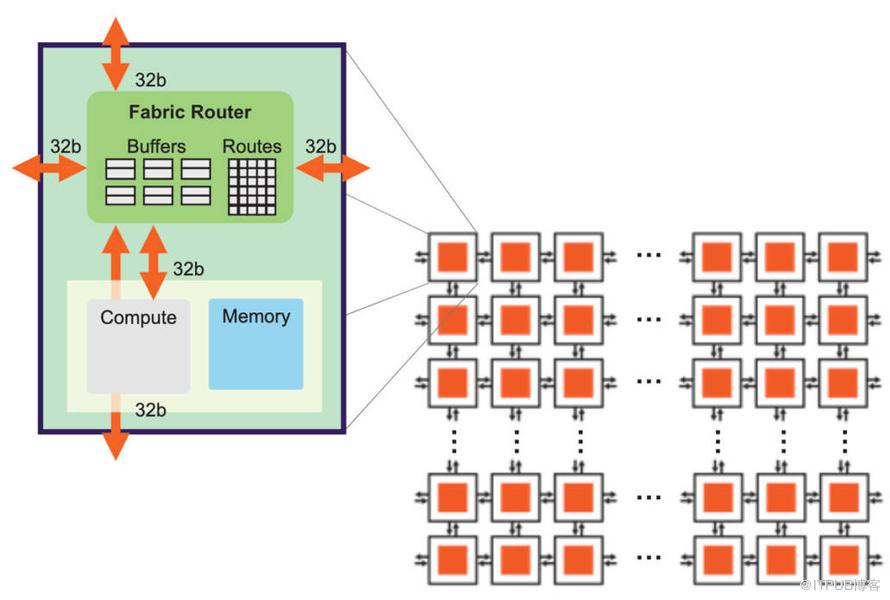 图7:高带宽、低延迟的芯片结构
5 通过权重流式技术支持超大模型

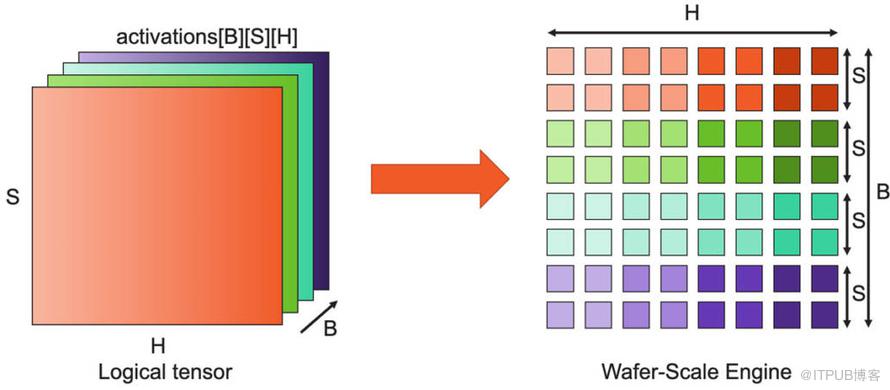
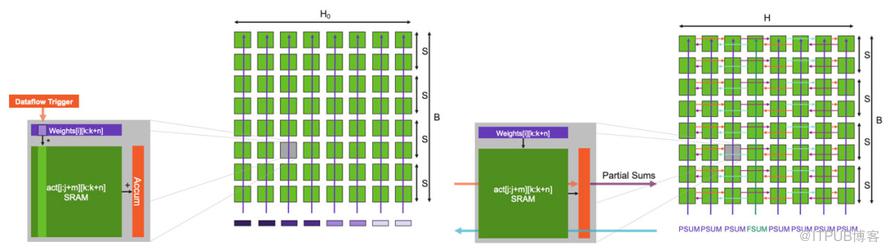
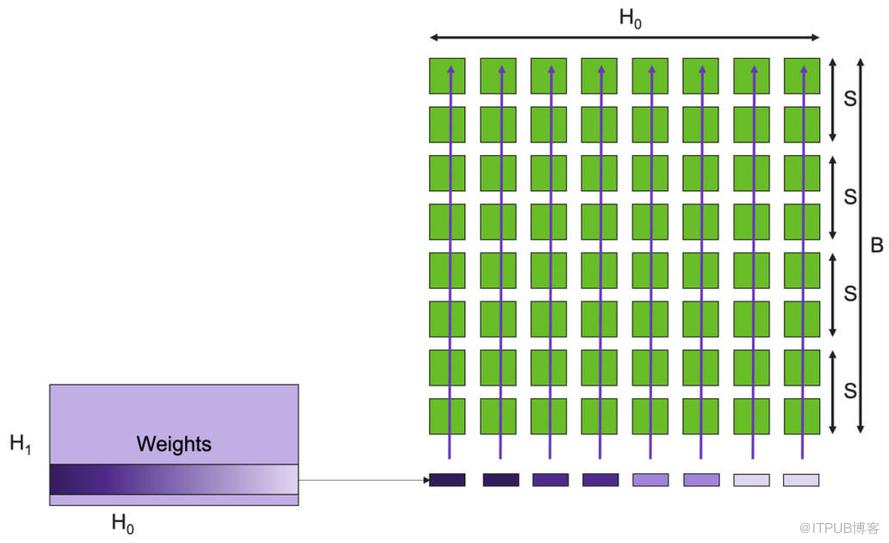 图11:数据流调度以低开销实现完全非结构化的稀疏MatMul运算。
6 横向扩展:为什么这么难
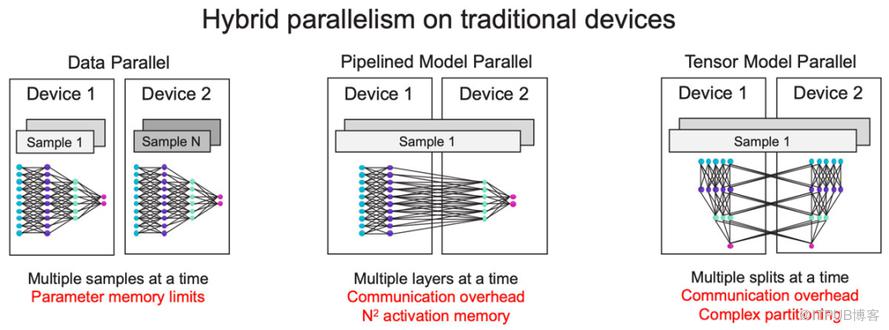
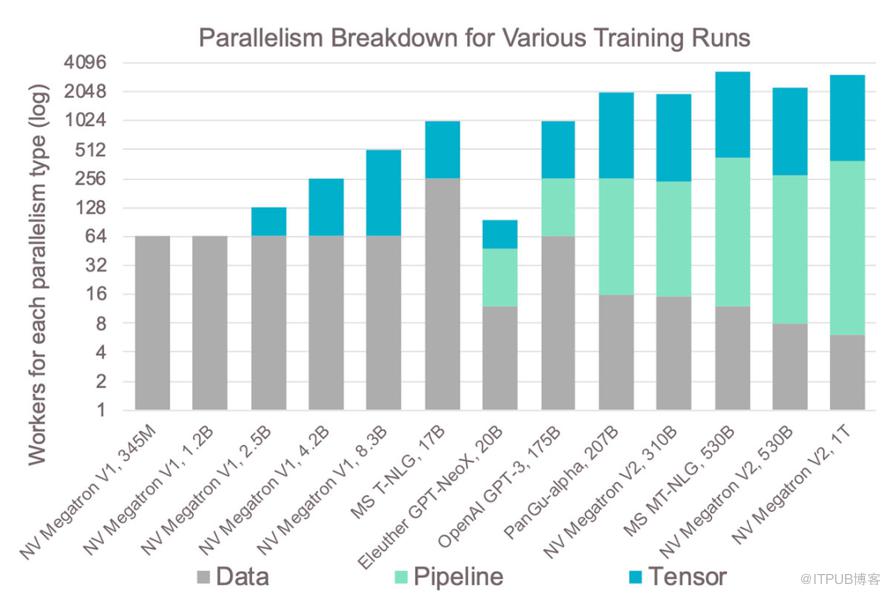
7 Cerebras架构使扩展变得容易
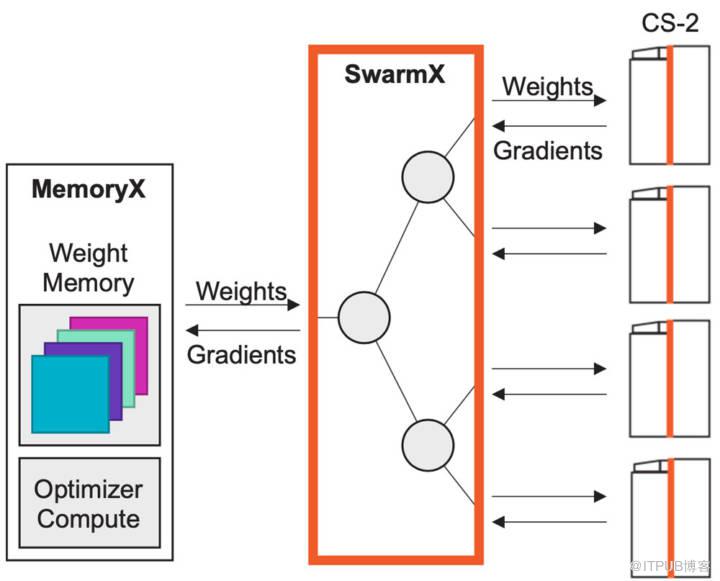 图15:使用MemoryX和SwarmX进行扩展,只需近线性的数据并行。
8 总结
 图16:各种最先进的神经网络的内存和计算要求。横、纵坐标每一格代表一个数量级的提升。
OneFlow v0.8.0正式发布 深度学习硬件的过去、现在和未来 决胜北交大算法大赛,冠军揭示通关攻略 Groq:从头设计一个张量流式处理器架构 Jeff Dean:机器学习在硬件设计中的潜力 OneEmbedding:单卡训练TB级推荐模型不是梦 大模型训练难?效率超群、易用的“李白”模型库来了
原文作者:OneFlow;如有侵权,请联系管理员删除。
上一篇:
OneFlow的大模型分片保存和加载策略

请登录后发表评论
登录
全部评论
