点击上方“Python爬虫与数据挖掘”,进行关注
回复“书籍”即可获赠Python从入门到进阶共10本电子书
扫除运行Scrapy爬虫程序的bug之后,现在便可以开始进行编写爬虫逻辑了。在正式开始爬虫编写之前,在这里介绍四种小技巧,可以方便我们操纵和调试爬虫。
一、建立main.py文件,直接在Pycharm下进行调试
很多时候我们在使用Scrapy爬虫框架的时候,如果想运行Scrapy爬虫项目的话,一般都会想着去命令行中直接执行命令“scrapy crawl crawler_name”,其中crawler_name指的是爬虫的名字,在一开始创建Scrapy爬虫模板的时候就指定了的,而且在该爬虫项目中具有唯一性。但是每次跑到命令行下去执行,看交互的结果,有时候并不是很清晰,所以这里介绍一种方法,可以帮助大家提高开发效率,尤其是调试的时候更是显得方便。
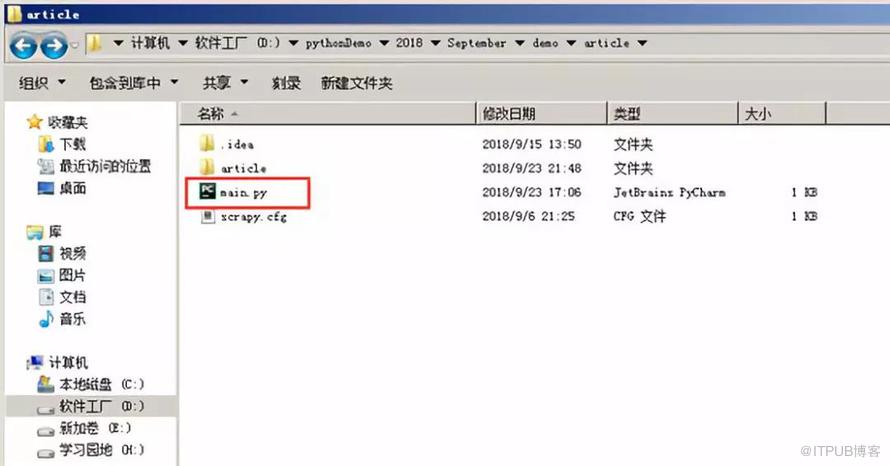
在与爬虫项目的scrapy.cfg文件同级目录下建立一个main.py文件,用于控制整个爬虫项目的执行。
在该文件夹中写入的代码见下图。其中execute函数是内嵌在scrapy中的,调用这个函数可以直接调用该Scrapy工程项目的爬虫脚本,这个函数的执行需要在爬虫项目的父目录下进行。而第7行代码的意思就是获取当前py文件的父目录,省去我们直接复制路径的精力和时间,同时也方便我们将该项目放到其他的平台上去运行,不会报路径的错误。execute函数里边的参数其实就是将Scrapy爬虫执行命令拆分,然后分别以一个字符的方式放到了一个数组中。
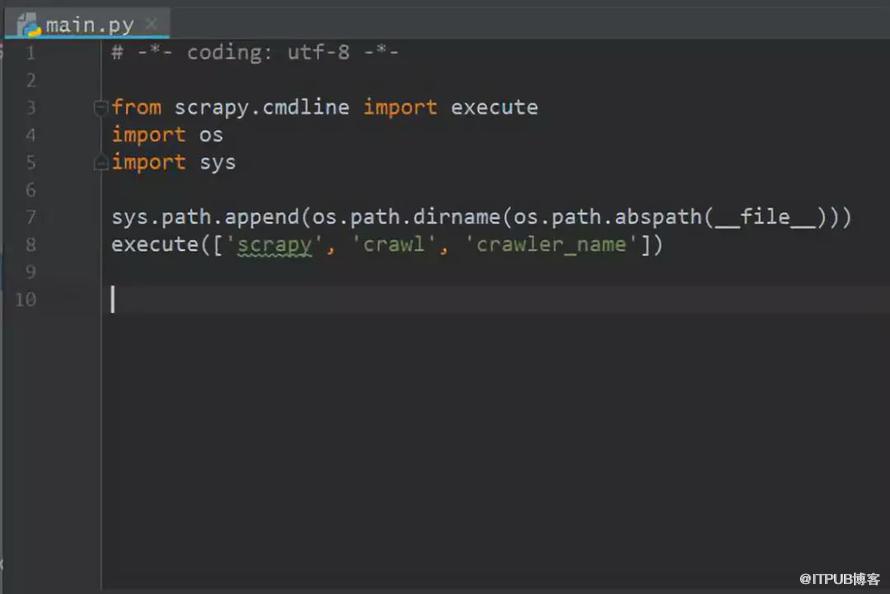
之后我们直接运行这个main.py文件便可以调用Scrapy爬虫程序了。
二、多用Debug进行调试,提高开发速度
相信用过Pycharm的小伙伴都看到过Debug这个东东,它的英文意思就是“小虫子”,在Pycharm中的logo也是个小虫子,像是七星瓢虫一样,不过很多小伙伴可能还没有怎么用过,这里简单的介绍给大家,希望大家日后可以多多用到,对于项目的调试十分有帮助。
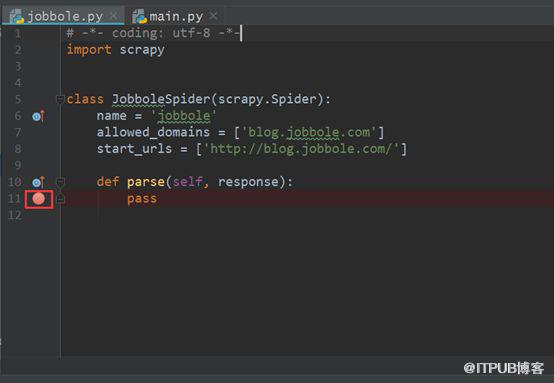
在进行Debug调试之前,我们需要在我们想要调试的代码左侧进行打断点,断点一般是红色的,打断点的方式很简单,只需要在代码的左侧点击一下左键即可,如下图所示。
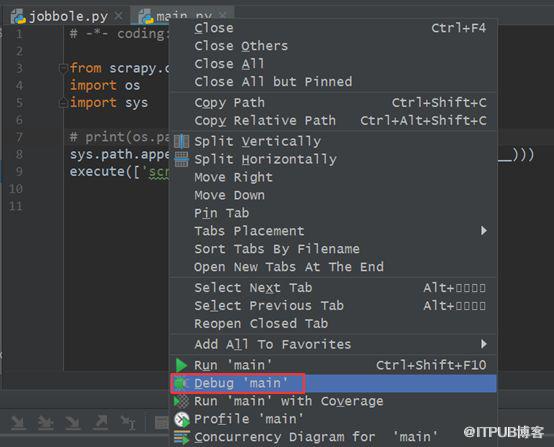
断点设置完成之后,便可以去main.py文件进行调试了。在main.py文件点击右键,然后选择“Debug ‘main’”,如下图所示。
之后爬虫程序便开始进行调试,并且会返回一系列结果,如下图所示,可以方便的进行拖拽查看。同时也会在爬虫文件中以绿色的字体进行显示爬虫的结果,很漂亮。
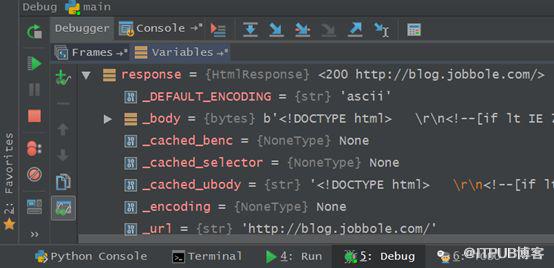
如果想退出或者停止该调试,则点击Pycharm上方选项卡的Run,然后点击“Stop ‘main’”即可,如下图所示。

之后该爬虫程序就会退出调试,恢复正常的Pycharm界面,如下图所示。
关于Scrapy爬虫项目运行和调试两个小技巧先分享到这里,下次将分享Scrapy爬虫项目中更为实用的两种调试方法,敬请期待~~
------------------- End -------------------
往期精彩文章推荐:
网络爬虫过程中5种网页去重方法简要介绍
Python环境搭建—安利Python小白的Python和Pycharm安装详细教程
Python大佬分析了15万歌词,告诉你民谣歌手们到底在唱什么
如何利用Python词云和wordart可视化工具对朋友圈数据进行可视化展示
看完本文有收获?请转发分享给更多的人
Python爬虫与数据挖掘
入群请在微信后台回复【学习】
欢迎大家点赞,留言,转发,转载,感谢大家的相伴与支持。
想加入学习群请在微信后台回复【学习】
万水千山总是情,点个【在看】行不行
原文作者:Python爬虫与数据挖掘;如有侵权,请联系管理员删除。

