回复“书籍”即可获赠Python从入门到进阶共10本电子书
/1 前言/
随着人们生活方式的的提高,房子成为了我们必不可少的一部分。而网上的信息太过于复杂,为了了解最近房价的变化趋势。小编以链家这个网站为例,抓取房价的信息。

/2 项目目标/
实现将获取到的房子的名字、价格、房子的关注度,导入Word模板,并生成独立的Word文档。
/3 涉及的库和网站/
先列出网址,如下所示。
网址:https://bj.lianjia.com/ershoufang/pg1/("bj"北京的缩写)库:requests、time 、lxml
/4 具体分析/
如何对下一页的网址进行请求?
点击下一页的按钮,观察到网站的变化分别如下:
https://bj.lianjia.com/ershoufang/pg1/https://bj.lianjia.com/ershoufang/pg2/https://bj.lianjia.com/ershoufang/pg3/
观察到只有pg()变化,变化的部分用{}格式化代替,再用for循环遍历这网址,实现多个网址请求。
/5 实现步骤/
1. 我们定义一个class类继承object,然后定义init方法继承self,再定义一个主函数main继承self。准备url地址和请求头headers。
import requestsfrom lxml import etreeimport timeclass LianJia(object):def __init__(self):passdef main(self):passif __name__ == '__main__':spider= LianJia()spider.main()
2. 对网站发生请求
def __init__(self):self.url = "https://bj.lianjia.com/ershoufang/pg{}/"self.headers = {"User-Agent":"Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/78.0.3904.108 Safari/537.36"}# 请求数据def get_page(self,url):html = requests.get(url=url,headers=self.headers).content.decode("utf-8")# print(html)self.page_page(html)
3. 对请求到的数据进行处理
# 数据处理def page_page(self,html):parse_html = etree.HTML(html)page = parse_html.xpath('//*[@id="content"]/div[1]/ul/li')house_dict = {}for li in page:house_dict['名称']=li.xpath('.//div[@class="infoclear"]//div[@class="title"]/a/text()')[0].strip()house_dict["价格"] = li.xpath(".//div[@class='priceInfo']/div[@class='totalPrice']/span/text()")[0].strip()+"万"house_dict["关注度"] = li.xpath('.//div[@class="info clear"]//div[@class="followInfo"]//text()')[0].strip()
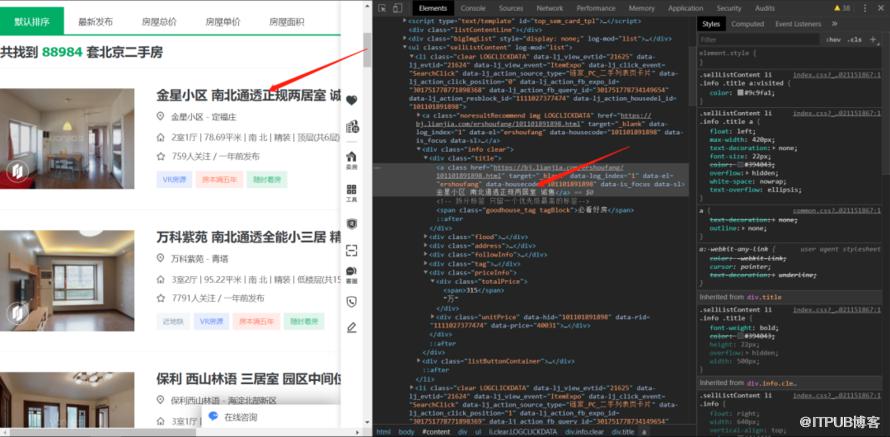
1) 在谷歌浏览器上,进行右键选择开发者工具或者按下键盘的F12,如下图所示。
2) 右键检查,找到房价的链接,如下图所示。
4. 将获取的信息写入word文档
f = open('房子.doc', 'a', encoding = 'utf-8') # 以'w'方式打开文件f.write(str(house_dict))print(house_dict)f.write("\n") # 键和值分行放,键在单数行,值在双数行f.close()
5. 在main方法调用
def main(self):for pg in range(1 ,101): #for遍历得到的网址url = self.url.format(str(pg))print(" = " *50)time.sleep(1.4) #时间延时
/6 效果展示/
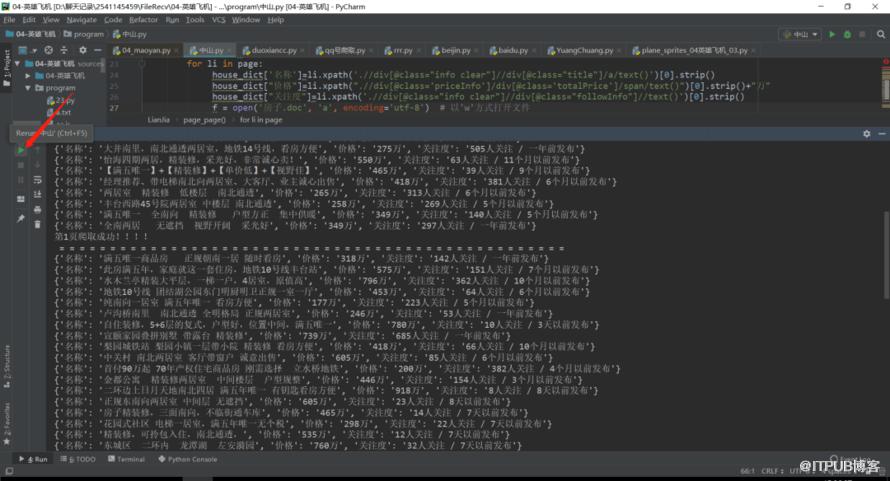
1. 点击绿色按钮运行,将结果显示在控制台,如下图所示。
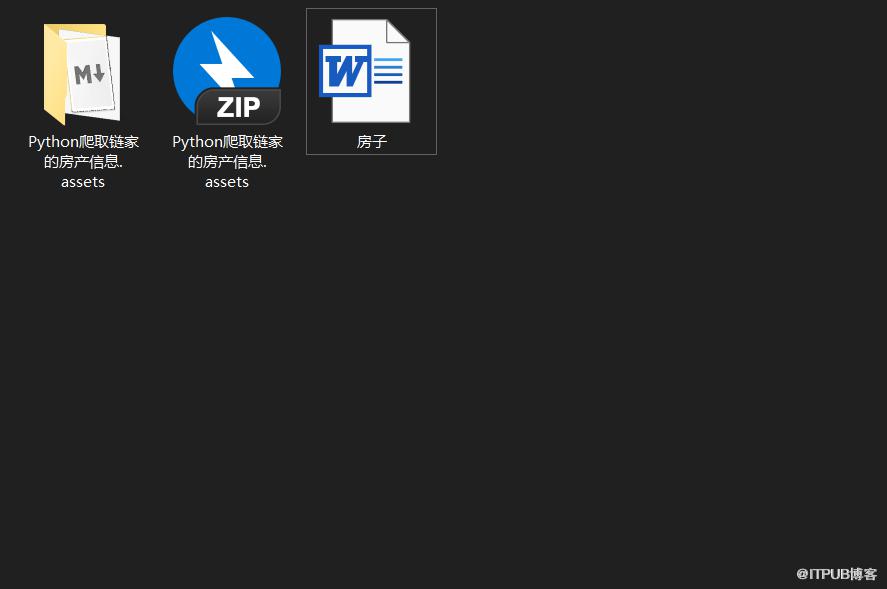
2. 保存在一个名为“房子”world文档里,如下图所示。
/7 小结/
不建议抓取太多数据,容易对服务器造成负载,浅尝辄止即可。
希望通过这个项目,能够帮助大家更好的了解房价的趋势。
本文基于Python网络爬虫,利用爬虫库,实现链家网部分房价信息的抓取。就Python爬取链家的房产信息中的一些难点, 进行详细的讲解和提供有效的解决方案。
欢迎大家积极尝试,有时候看到别人实现起来很简单,但是到自己动手实现的时候,总会有各种各样的问题,切勿眼高手低,勤动手,才可以理解的更加深刻。
如果本文源码的小伙伴,请在后台回复“链家网”三个字进行获取,觉得不错,记得给个Star噢~
------------------- End -------------------
往期精彩文章推荐:
欢迎大家点赞,留言,转发,转载,感谢大家的相伴与支持
想加入Python学习群请在后台回复【入群】
万水千山总是情,点个【在看】行不行
/今日留言主题/
说一两个你常用的爬虫库吧~~
原文作者:Python爬虫与数据挖掘;如有侵权,请联系管理员删除。

