回复“书籍”即可获赠Python从入门到进阶共10本电子书
/1 前言/
随着网络的时代的发展,人们很少去安静的去看一本书。而是选择看网络小说,可是网络小说有些要钱才能看。
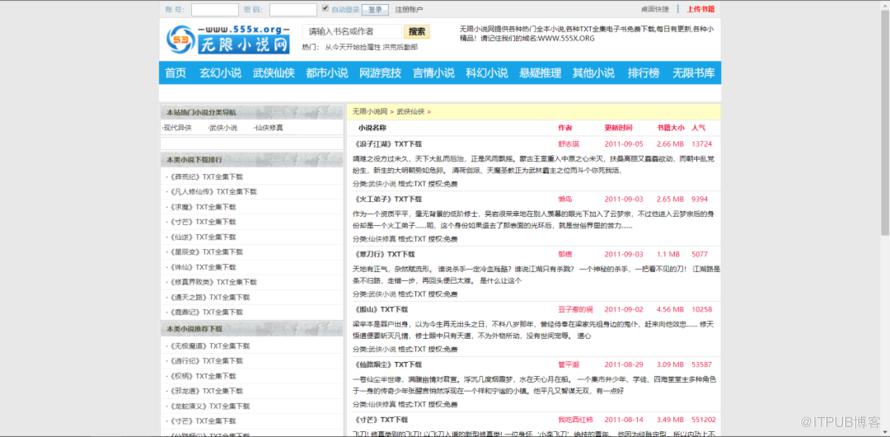
无限小说网
https:// 里边的内容是完全免费的,提供了各种种类的小说。满足用户的需要。可一页一页看小说太麻烦,直接下载多方便。
今天教大家爬取无限小说网,把小说的下载链接通过网络请求直接下载。
/2 项目目标/
获取对应小说的下载链接,点击下载链接网址,下载对应的txt文件。
/3 项目准备/
软件:PyCharm
需要的库:requests、lxml、fake_useragent
网站如下:
https://html/wuxiaxianxia/list_29_{}.html点击下一页时,list_29_{}每增加一页自增加1,用{}代替变换的变量,再用for循环遍历这网址,实现多个网址请求。
/4 项目实现/
1、定义一个class类继承object,定义init方法继承self,主函数main继承self。导入需要的库和网址,代码如下所示。
import requestsfrom lxml import etreefrom fake_useragent import UserAgentimport timeclass xiaoshuo(object):def __init__(self):self.url = "https://www.xiachufang.com/explore/?page={}"def main(self):passif __name__ == '__main__':imageSpider = xiaoshuo()imageSpider.main()
2、随机产生UserAgent。
for i in range(1, 50):self.headers = {'User-Agent': ua.random,}
3、发送请求,获取响应, 页面回调,方便下次请求。
def get_page(self, url):res = requests.get(url=url, headers=self.headers)html = res.content.decode("utf-8")return html
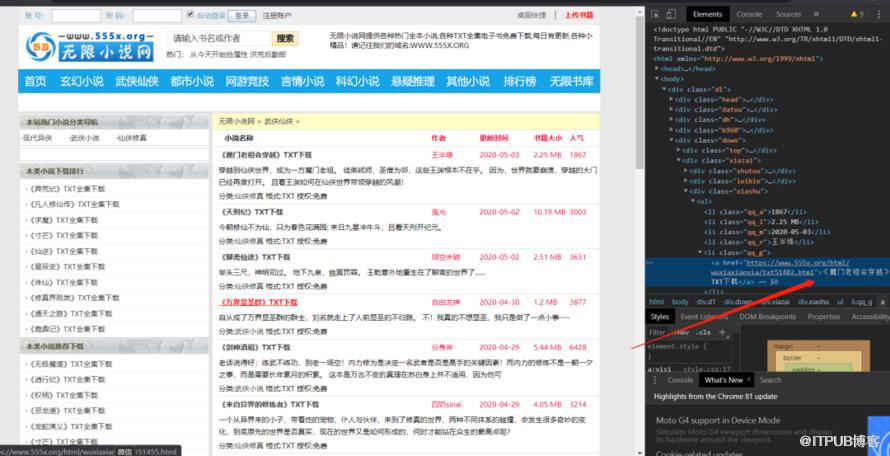
4、xpath解析一级页面数据,获取页面信息。
1)f12运行浏览器,右键检查。找到对应二级页面的地址。
2)二级页面,右键检查。点击下载按钮,找到对应三级页面的地址。
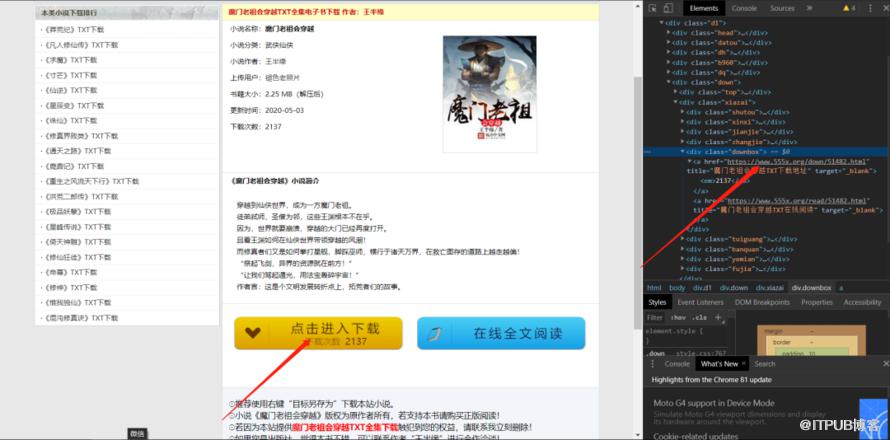
5、三级页面,先找到对应的父节点,再for循环遍历进行爬取。
for rd in three:b = rd.xpath('..//div[@class="shutou"]//b/text()')[0].strip()tress = rd.xpath('..//div[@class="shuji"]//ul/li/a/@href')[0].strip()# print(tress)
6、定义read保存对应的小说名字,下载链接。
read = '''《%s》 下 载 链 接 : %s ''' % (b, tress)print(read)
7、调用方法,实现功能。
html = self.get_page(url)self.parse_page(html)
/5 效果展示/
1、点击绿色小三角运行输入起始页,终止页。
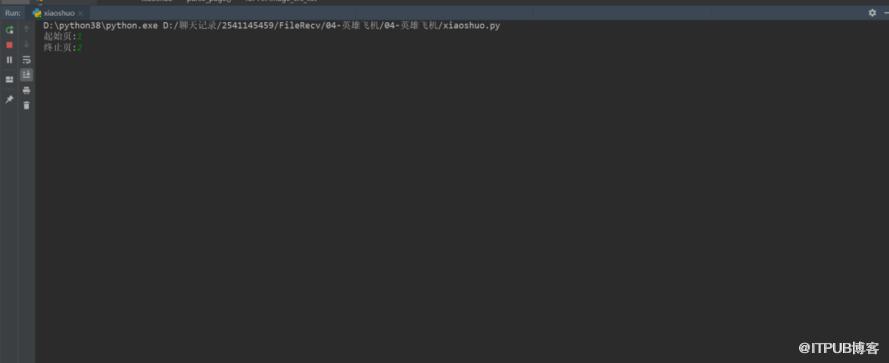
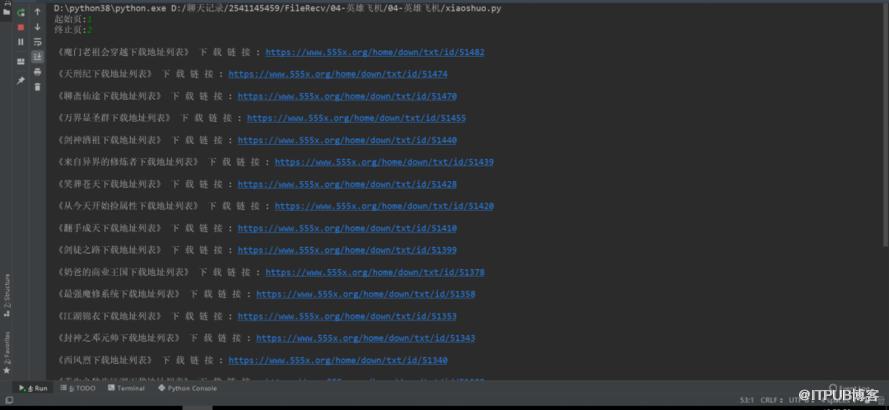
2、运行程序后,结果显示在控制台,如下图所示。
3、点击蓝色下载链接, 网络下载

4、双击小说文件,内容如下图所示。

/6 小结/
1、不建议抓取太多数据,容易对服务器造成负载,浅尝辄止即可。
2、本文基于Python网络爬虫,利用爬虫库,实现爬取小说下载链接,网络请求直接下载。
3、实现的时候,总会有各种各样的问题,切勿眼高手低,勤动手,才可以理解的更加深刻。
4、希望通过这个项目,能够帮助一些上班族,在空闲时能够直接通过网络去获取自己想要的小说 。
5、懒人是科技进步的动力。
6、如果需要本文源码的话,请在公众号后台回复“小说”两个字进行获取,觉得不错,记得给个star噢。
------------------- End -------------------
往期精彩文章推荐:
欢迎大家点赞,留言,转发,转载,感谢大家的相伴与支持
想加入Python学习群请在后台回复【入群】
万水千山总是情,点个【在看】行不行
/今日留言主题/
随便说一两个您使用过的Python库~~
原文作者:Python爬虫与数据挖掘;如有侵权,请联系管理员删除。

