回复“书籍”即可获赠Python从入门到进阶共10本电子书
今天要跟大家分享一个小说爬取案例--------起点小说的小说下载。
在做这个案例之前,我们需要对其进行分析,
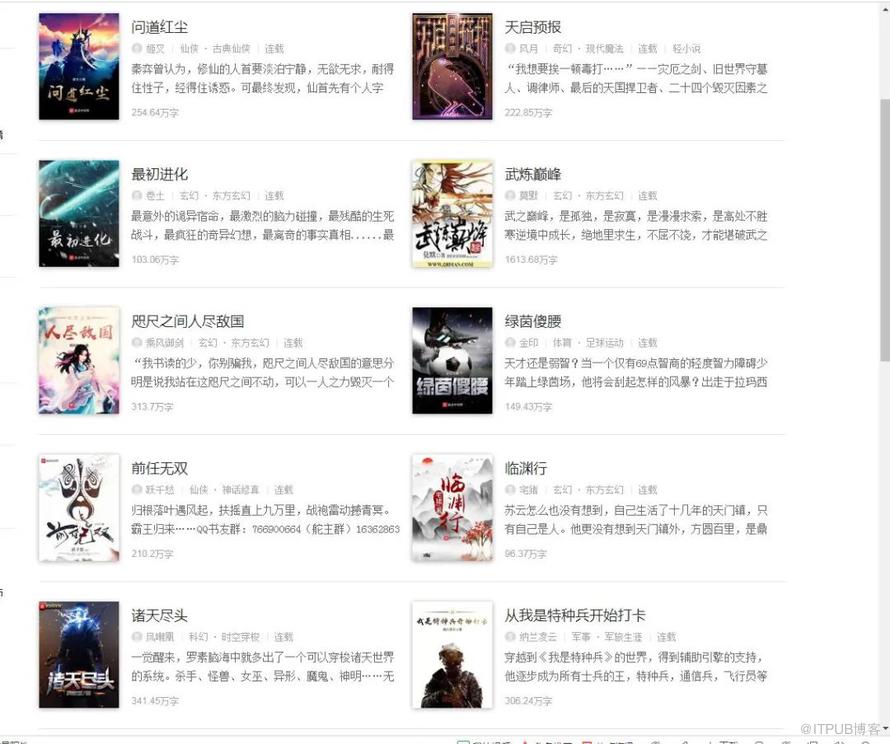
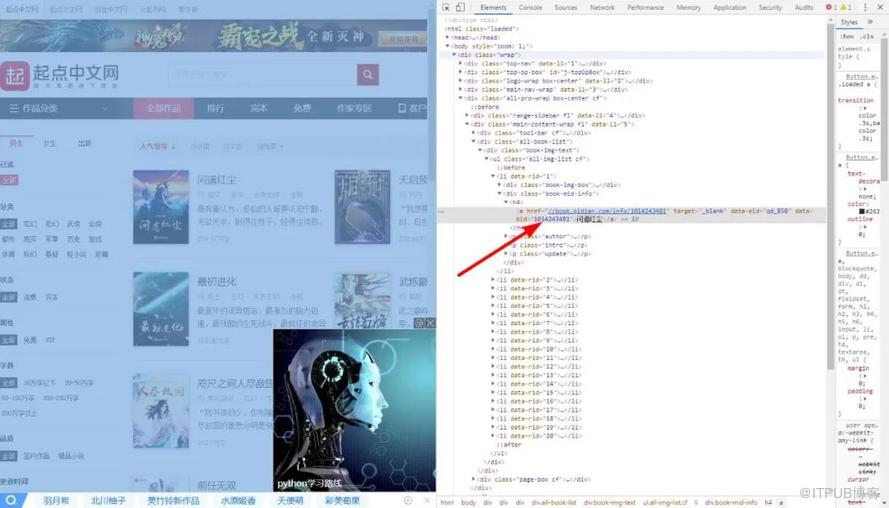
1.界面分析,如图:

通过分析很容易就找到了我们的get请求参数,然后获取相应页面的小说名和链接:
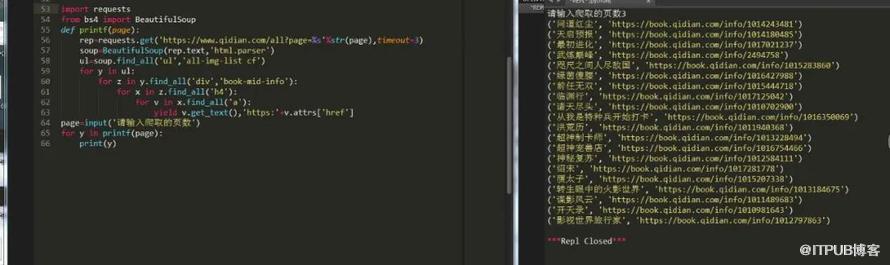
获取到数据之后,我们就随机挑选一篇小说来进行下载,我们选第一篇,
然后打开它的文章目录,可以看到是这样的,如图:
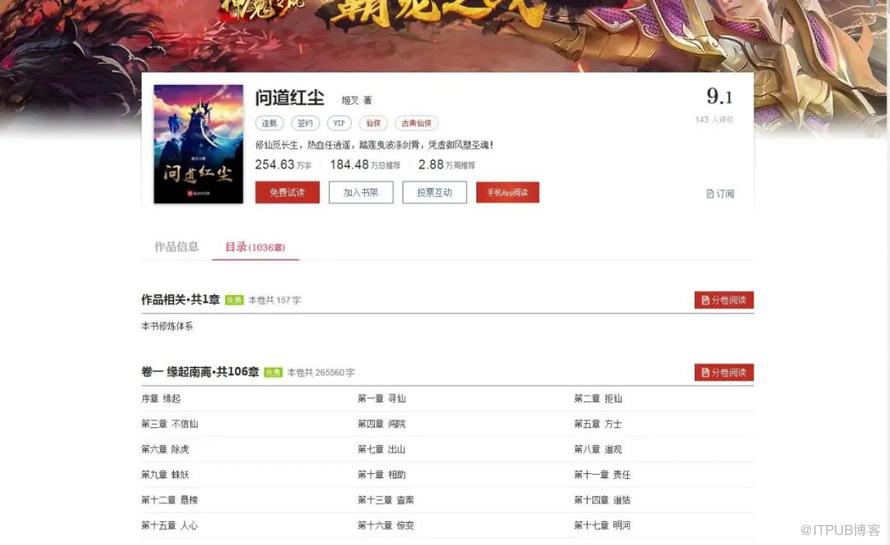
基本上这篇小说很长,可以看到它卷一和卷二是免费的,后面的收费,那么今天我们就只爬免费的章节。
那么我们现在开始分析网页结构,如图:

那么,我们可以先把卷一的名字和章节数以及章节下的每个章节的名字都打印出来。
首先我们可以分析下这个网页地址,如图:
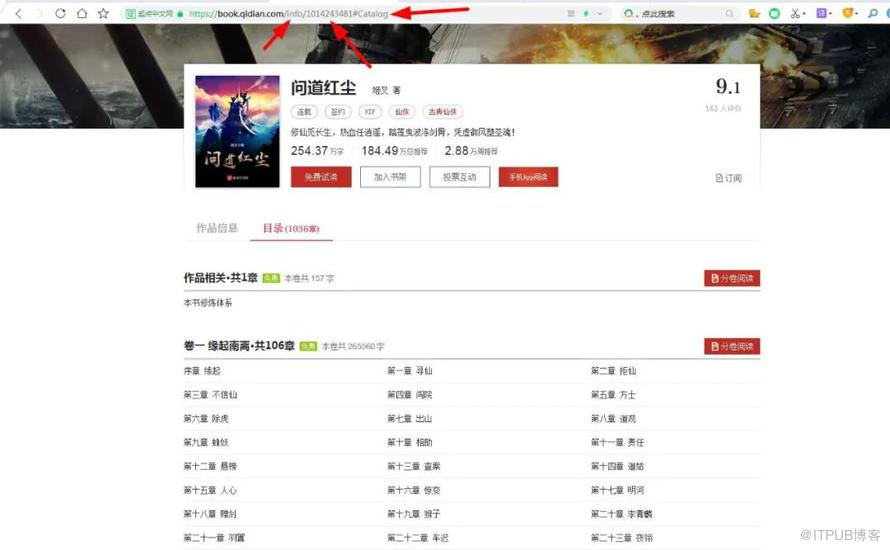
https://book.qidian.com/info/1014243481#Catalog发觉前面的没变,基本就是后面的变了,增加了一个info/1014243481#Catalog,下面开始分析:
info:信息的意思,
1014243481:小说对应的ID,
#Catalog:数据补全,无太大意义
因为刚刚已经将文章链接的内容爬取出来,所以现在只需要拼接一个#Catalog 即可:
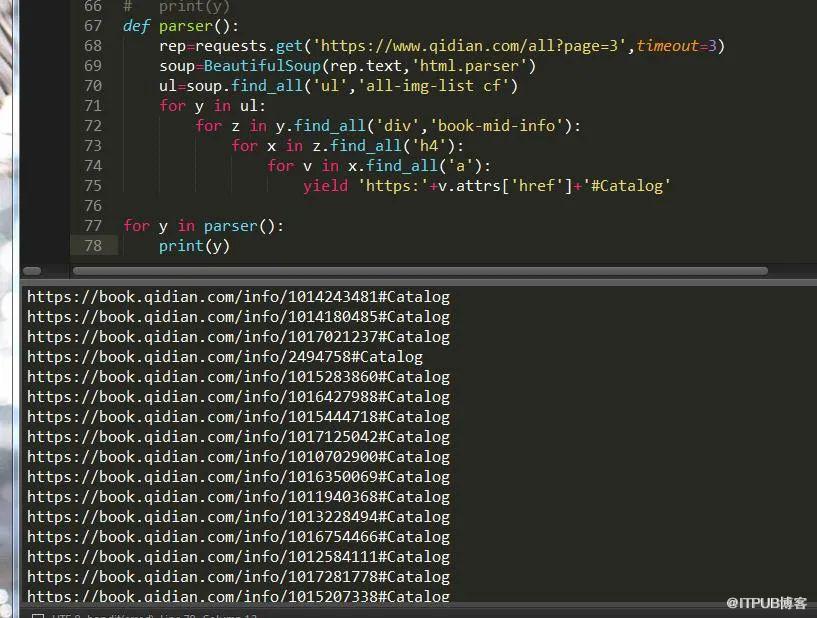
下面我们就可以对它发起请求然后在分析它的页面了,首先发起get请求,按照前面的网页分析结构来看,我们应该这样写:

可以看出,因为这里有异步加载,所以我们的请求不会一下子全部显示出来,需要不断的请求,当然最好加个延迟。
这样我们就获取到了这个页面所有的小说,也可以这样,因为我们没找接口,所以强行解析只能解析部分内容,但是也很全面了。如图:
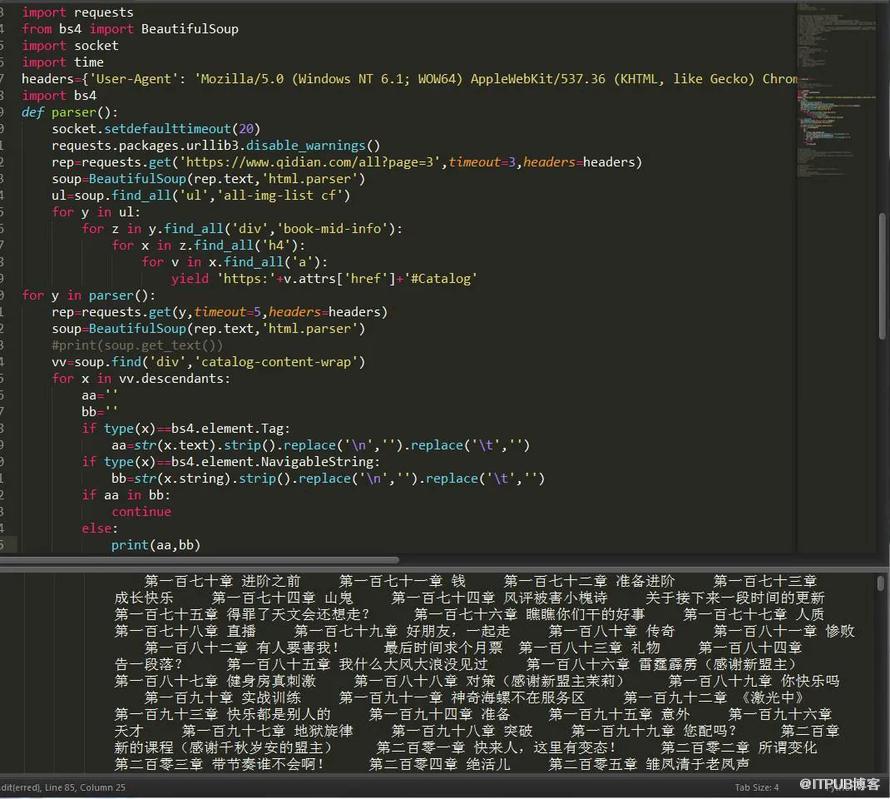
找的还算挺详细,只不过没有找接口时所拿到的数据那么规范好看了。
------------------- End -------------------
往期精彩文章推荐:
欢迎大家点赞,留言,转发,转载,感谢大家的相伴与支持
想加入Python学习群请在后台回复【入群】
万水千山总是情,点个【在看】行不行
/今日留言主题/
随便说一两句吧~
原文作者:Python爬虫与数据挖掘;如有侵权,请联系管理员删除。

