回复“书籍”即可获赠Python从入门到进阶共10本电子书
大家好,我是Python进阶者。
一、前言
前几天在Python白银交流群大家在交流东方财富网分时数据的抓取方法,时分数据如下图所示。
早在之前就给大家分享了东方财富网其他交易数据的抓取方法,可以前往进行查看,手把手教你使用Python网络爬虫获取基金信息。
这里群友【꯭】也给了一份代码,分享给大家。
# -*- coding: utf-8 -*-
# @Time    : 2022/6/1 23:10
# @Author  : Thresh
# @File    : 1.py
import json
import requests


for page in range(5):
   params = (
       ('pagesize', '144'),
       ('ut', '7eea3edcaed734bea9cbfc24409ed989'),
       ('dpt', 'wzfscj'),
       ('cb', 'jQuery1124029337350072397084_1631343037828'),
       ('pageindex', str(page)),
       ('id', '6009051'),
       ('sort', '1'),
       ('ft', '1'),
       ('code', '688103'),
       ('market', '1'),
       ('_', '1631343037827'),
   )
   response = requests.get('http://push2ex.eastmoney.com/getStockFenShi', params=params, verify=False)
   response = response.text
   response = response.split('(')[1]
   response = response.split(')')[0]
   response = json.loads(response)
   data_lis = response["data"]["data"]
   for data in data_lis:
       print(data)
二、实现过程
今天我们要实现的是时分数据的获取,这里提供两个方法,希望对大家有所参考。
关于url的寻找,确实花费了一番心思,最终发现它藏在这里,如下图所示:
之后复制这个链接,在浏览器中打开的话,可以看到密密麻麻的,有点烧脑。
这里【🇳 🇴 🇳 🇪】给了一份代码,如下所示:
import urllib.request
import pandas as pd
url = 'http://16.push2.eastmoney.com/api/qt/stock/details/sse?fields1=f1,f2,f3,f4&fields2=f51,f52,f53,f54,f55&mpi=2000&ut=bd1d9ddb04089700cf9c27f6f7426281&fltt=2&pos=-0&secid=1.688103'
with urllib.request.urlopen(url=url) as r:
    data = r.readline().decode().lstrip('data:')
print(data)
df = pd.DataFrame(eval(data)['data'])
print(df)
运行之后,结果如下图所示:
密密麻麻的,确实可以拿来做屏保了。
后来【🇳 🇴 🇳 🇪】还给了一份代码,如下所示:
# -*- coding: utf-8 -*-
from http.client import HTTPConnection

url = 'http://97.push2.eastmoney.com/'
# 119.3.12.115:80
http_conn = HTTPConnection('119.3.12.115', 80)

params = "/api/qt/stock/details/sse?fields1=f1,f2,f3,f4&fields2=f51,f52,f53,f54,f55&mpi=2000&ut=bd1d9ddb04089700cf9c27f6f7426281&fltt=2&pos=-0&secid=0.300059"
headers = {
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,image/apng,*/*;q=0.8,application/signed-exchange;v=b3;q=0.9",
    "Accept-Encoding": "gzip, deflate",
    "Accept-Language": "zh-CN,zh;q=0.9",
    "Cache-Control": "no-cache",
    "Connection": "keep-alive",
    "Host": "97.push2.eastmoney.com",
    "Pragma": "no-cache",
    "Upgrade-Insecure-Requests": "1",
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/101.0.4951.67 Safari/537.36"
}
http_conn.request("GET", params, headers=headers)

with http_conn.getresponse() as response:
    while not response.closed:
        for line in response:
            print(line.decode("utf-8"))
其中代码中的那个IP地址就是下图的这个,着实有点神奇。
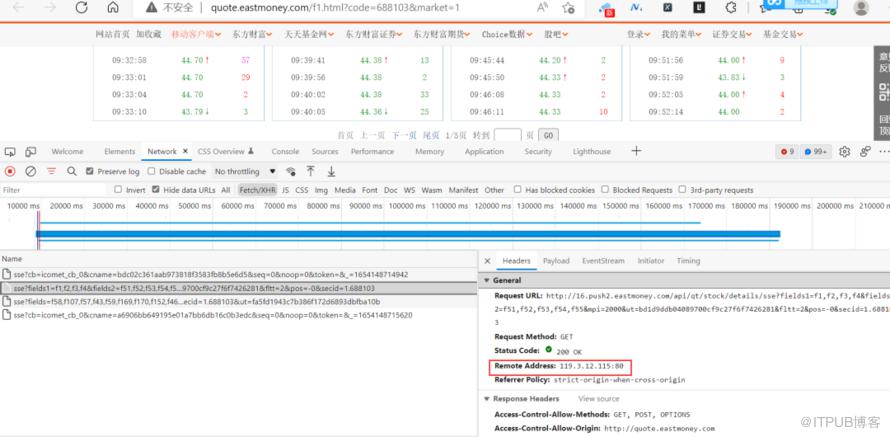 这个代码可以反复的去请求这个网页,只要有数据更新,都可以获取到,不停抓更新出来的数据,太强了!
总的来说,第一个方法要简单一些,第二个方法更加底层,实现起来门槛高一些,但是都是可以参考的,后面遇到类似的,不妨拿出来实战下,事半功倍!
三、总结
大家好,我是Python进阶者。这篇文章主要盘点两种网络爬虫的方法,实现对东方财富网分时数据抓取,文中针对该问题给出了具体的解析和代码实现,帮助粉丝顺利解决了问题。
最后感谢粉丝【dcpeng】提问,感谢【🇳 🇴 🇳 🇪】、【꯭】、【瑜亮老师】给出的思路和代码解析,感谢【dcpeng】、【猫药师Kelly】、【冫马讠成】、【大侠】、【凡人不烦人】等人参与学习交流。
小伙伴们,快快用实践一下吧!如果在学习过程中,有遇到任何问题,欢迎加我好友,我拉你进Python学习交流群共同探讨学习。
------------------- End -------------------
往期精彩文章推荐:
欢迎大家点赞,留言,转发,转载,感谢大家的相伴与支持
想加入Python学习群请在后台回复【入群】
万水千山总是情,点个【在看】行不行
/今日留言主题/
随便说一两句吧~~
原文作者:Python爬虫与数据挖掘;如有侵权,请联系管理员删除。

