回复“书籍”即可获赠Python从入门到进阶共10本电子书
大家好,我是皮皮。
一、前言
前几天在Python钻石交流群【海南菜同学】问了一个Python网络爬虫的问题,下图是截图:
代码初步看上去好像没啥问题,但是结果就是不对。
代码如下:
url = "http://zw.hainan.gov.cn/wssc/ec/jlyhnkj.html"
resp = requests.get(url,headers=headers)
text = resp.text
parse = etree.HTML(text)
price = parse.xpath("//div[@class='productlist']/ul/li/div[4]/text()")
print(type(price),len(price))
# print(price)
for i in price:
    print(i.strip())
现在他是想让数据显示好看一些,将换行符什么的去除。
二、实现过程
这里【dcpeng】给了一份代码,如下所示:
url = "http://zw.hainan.gov.cn/wssc/ec/jlyhnkj.html"
resp = requests.get(url,headers=headers)
text = resp.text
parse = etree.HTML(text)
price = parse.xpath("//div[@class='productlist']/ul/li/div[4]/text()")
print(type(price),len(price))
# print(price)
for i in price:
    print(i.strip().replace('\n',''))
不过运行之后,效果不太大。因为它本身有些数据是空的,所以有的数据会显示空,现在他是想将空的数据,直接去除。这里【甯同学】给了一份代码,如下所示:
不过看上去还是有些问题,12件商品,怎么才出了8个价格,少了一列了。
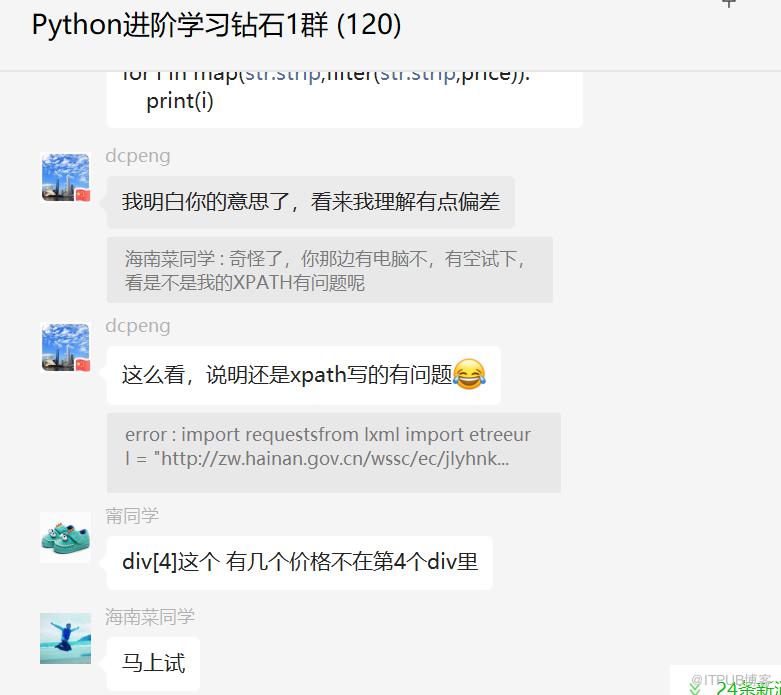
后来才知道,原来不只是这个地方的问题,源头是选择器Xpath提取规则写的有问题。这里【甯同学】给了一份代码,如下图所示:
后来粉丝就顺利的解决了,代码如下所示:
import requests
from lxml import etree
url = "http://zw.hainan.gov.cn/wssc/ec/jlyhnkj.html"
resp = requests.get(url)
text = resp.text
parse = etree.HTML(text)
price = parse.xpath('//div[@class="product_price"]/text()')
print(type(price),len(price))
# print(price)
for i in map(str.strip,filter(str.strip,price)):
    print(i)
 上面的
map函数可能有点难以理解,这里解析如下:
解决这个问题的方法还是很多的,这里再给出几个方法,这里【dcpeng】给了一份代码,如下所示:
resp = requests.get(url, headers=headers)
text = resp.text
parse = etree.HTML(text)
price = parse.xpath("//div[@class='productlist']/ul/li")
print(type(price), len(price))
for i in price:
    print(i.xpath('./div[@class="product_price"]/text()')[1].strip())
结果如下图所示:
【dcpeng】还提供了另外一个方法,如下所示:
resp = requests.get(url, headers=headers)
text = resp.text
parse = etree.HTML(text)
price = parse.xpath("//div[@class='product_price']/text()")
print(type(price), len(price))
for i in price:
    if i.strip():
        print(i.replace('\n', '').strip())
结果如下图所示:
后来【瑜亮老师】也提供了一个代码,代码如下所示:
url = "http://zw.hainan.gov.cn/wssc/ec/jlyhnkj.html"
resp = requests.get(url)
text = resp.text
parse = etree.HTML(text)
price = parse.xpath("//div[@class='productlist']/ul/li/div[4]/text()")
# 直接使用列表推导式,去掉冗余数据
price = [i.strip() for i in price if i.strip()]
print(price)
# 为了方便统计,再去掉¥符号,再转换成数字
# price = [int(float(i.replace('¥', '').replace(',', ''))) for i in price]
# 或者用re.sub去掉多余符号,再转换成数字,上下两种方法,选一个就行
# 需要import re
# price = [int(float(re.sub(r'[¥,]', '', i))) for i in price]
print(price)
结果如图所示:
方法多多!
三、总结
大家好,我是皮皮。这篇文章主要盘点了一个Python网络爬虫的问题,文中针对该问题给出了具体的解析和代码实现,帮助粉丝顺利解决了问题。
最后感谢粉丝【海南菜同学】提问,感谢【dcpeng】、【甯同学】、【瑜亮老师】给出的思路和代码解析,感谢【Engineer】、【此类生物】、【皮皮】、【心田有垢生荒草】等人参与学习交流。
大家在学习过程中如果有遇到问题,欢迎随时联系我解决(我的微信:pdcfighting),应粉丝要求,我创建了一些高质量的Python付费学习交流群,欢迎大家加入我的Python学习交流群!
小伙伴们,快快用实践一下吧!如果在学习过程中,有遇到任何问题,欢迎加我好友,我拉你进Python学习交流群共同探讨学习。
------------------- End -------------------
往期精彩文章推荐:
欢迎大家点赞,留言,转发,转载,感谢大家的相伴与支持
想加入Python学习群请在后台回复【入群】
万水千山总是情,点个【在看】行不行
/今日留言主题/
随便说一两句吧~~
原文作者:Python爬虫与数据挖掘;如有侵权,请联系管理员删除。

