回复“书籍”即可获赠Python从入门到进阶共10本电子书
大家好,我是皮皮。
一、前言
前几天在Python钻石交流群【萤火】问了一个Python网络爬虫的问题,下图是截图:
下图是报错截图:
二、实现过程
这里【error】给了一个代码,如下所示,满足粉丝的需求:
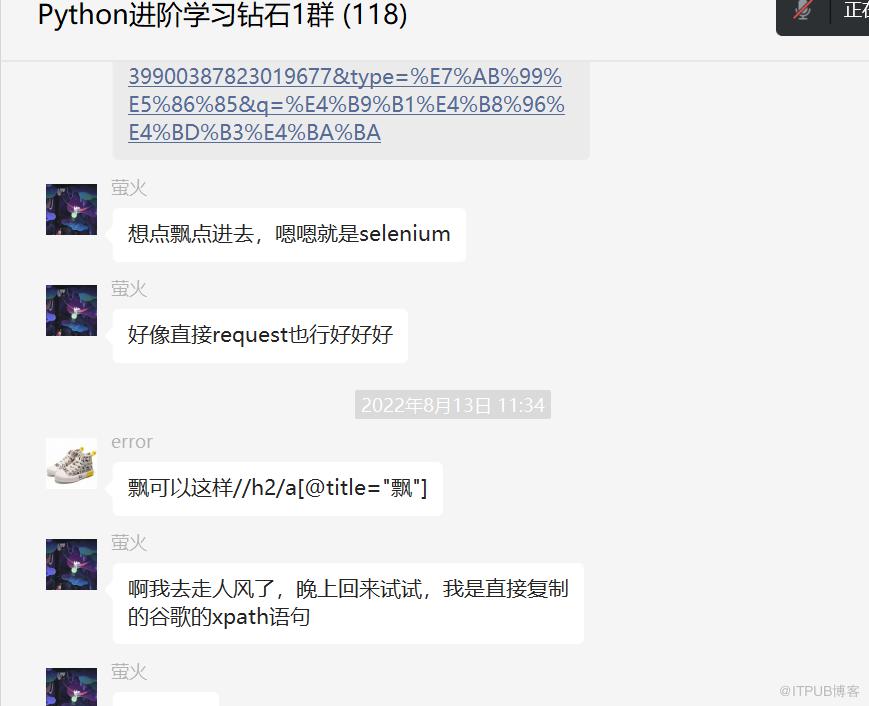 用selenium没找到的话,大概率是网页还没渲染出来,代码就运行到了抓取规则,所以抓不到。
其实他的匹配规则是可以拿到数据的,只不过用jupyter运行selenium的时候容易出问题,也不推荐。
起码用其他的编译器来看,应该都可以实现的!
三、总结
大家好,我是皮皮。这篇文章主要盘点了一个Python网络爬虫的问题,文中针对该问题给出了具体的解析和代码实现,帮助粉丝顺利解决了问题。
最后感谢粉丝【萤火】提问,感谢【此类生物】、【瑜亮老师】、【error】给出的思路和代码解析,感谢【冫马讠成】、【猫药师Kelly】、【dcpeng】等人参与学习交流。
大家在学习过程中如果有遇到问题,欢迎随时联系我解决(我的微信:pdcfighting),应粉丝要求,我创建了一些高质量的Python付费学习交流群,欢迎大家加入我的Python学习交流群!
小伙伴们,快快用实践一下吧!如果在学习过程中,有遇到任何问题,欢迎加我好友,我拉你进Python学习交流群共同探讨学习。

------------------- End -------------------
往期精彩文章推荐:
欢迎大家点赞,留言,转发,转载,感谢大家的相伴与支持
想加入Python学习群请在后台回复【入群】
万水千山总是情,点个【在看】行不行
/今日留言主题/
随便说一两句吧~~
原文作者:Python爬虫与数据挖掘;如有侵权,请联系管理员删除。

