回复“书籍”即可获赠Python从入门到进阶共10本电子书
大家好,我是皮皮。
一、前言
前几天在Python铂金交流群【红色基因代代传】问了一个Python处理的问题,提问截图如下:

文件里边的部分截图如下:
大概的需求如下所示:
二、实现过程
这里【Python进阶者】根据需求,写了一份代码,如下所示:
import re
with open('西游记.txt', 'r', encoding='utf-8') as f:
    text = f.read()
regex = re.compile(r'.*?《》(.*?)《》.*?', re.S)
result = re.findall(regex, text)
print(len(list(result)))
for item in result:
    print(item)
可以得到如下的效果:
后来【瑜亮老师】发现了一个问题,并且指出:
改进后的代码如下所示:
import re

with open('西游记.txt', 'r+', encoding='utf-8') as f:
    txt = f.read()

rex1 = r'《》目录 (.*?)\n\n\n'
rex2 = r'《》目录 (第一百回.*?《西游记》至此终。)'
result = re.findall(rex1, txt, re.S)
temp = re.findall(rex2, txt, re.S)
result += temp
# print(len(result))
for item in result:
    print(item)
运行之后,可以得到下图的结果:
顺利地解决了粉丝的问题。
三、总结
大家好,我是皮皮。这篇文章主要盘点了一个Python文本处理的问题,文中针对该问题,使用正则表达式匹配出想要的结果,并给出了具体的解析和代码实现,帮助粉丝顺利解决了问题。
最后感谢粉丝【红色基因代代传】提问,感谢【Python进阶者】、【瑜亮老师】给出的思路和代码解析,感谢【冫马讠成】、【D I Y】等人参与学习交流。
大家在学习过程中如果有遇到问题,欢迎随时联系我解决(我的微信:pdcfighting),应粉丝要求,我创建了一些高质量的Python付费学习交流群,欢迎大家加入我的Python学习交流群!
小伙伴们,快快用实践一下吧!如果在学习过程中,有遇到任何问题,欢迎加我好友,我拉你进Python学习交流群共同探讨学习。
赠书规则
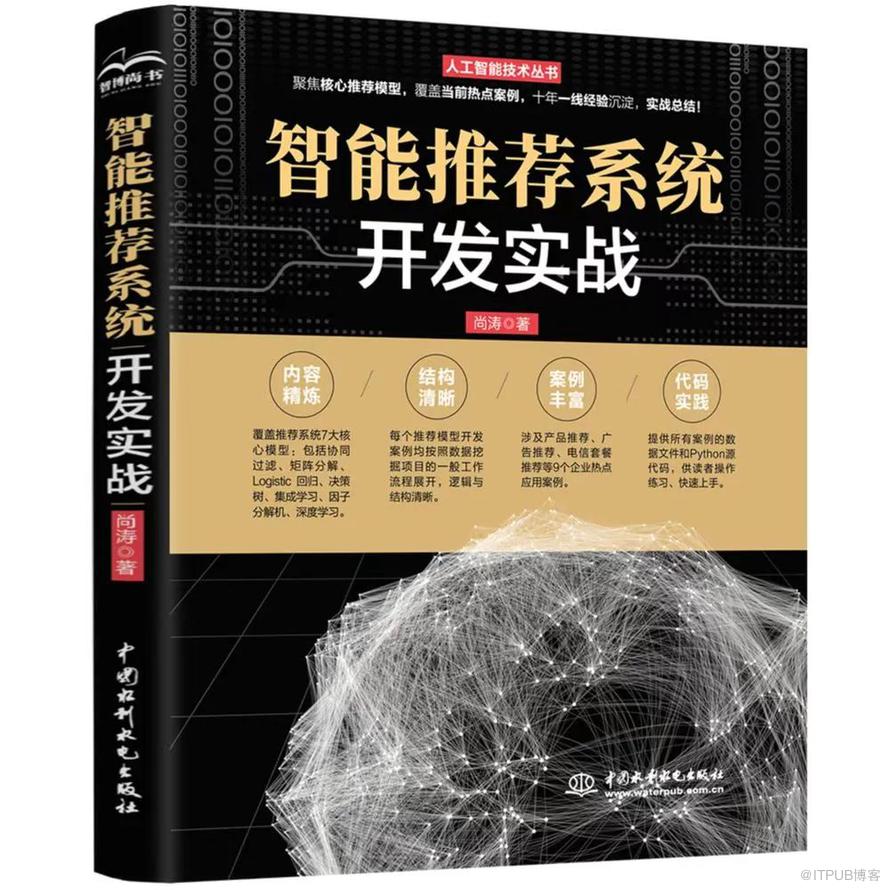
编辑推荐
1.简单易学:本书使用 Python 3.7 版本进行编写,代码简单,易于读者学习。
2.实践为主:本书不是空讲推荐算法理论知识,而是以实际的案例清晰简明地介绍如何使用Python 实现推荐模型的开发落地。
3.内容全面:覆盖推荐系统领域常见的模型及热点案例。
4.配备数据和源代码:提供所有案例的数据文件和 Python 源代码供读者操作练习、快速上手。
5.学习路线图清晰:每个推荐模型开发案例均按照数据挖掘项目的一般工作流程逐步展开,分析逻辑清晰。
------------------- End -------------------
往期精彩文章推荐:

欢迎大家点赞,留言,转发,转载,感谢大家的相伴与支持
想加入Python学习群请在后台回复【入群】
万水千山总是情,点个【在看】行不行
/今日留言主题/
随便说一两句吧~~
原文作者:Python爬虫与数据挖掘;如有侵权,请联系管理员删除。

