IntelliJ-IDEA-Mavne-Scala-Spark开发环境搭建
背景
几乎所有编程语言的第一个程序都是 Hello World。
下载并安装JDK、Scala、Maven
之前的Hadoop HA 和 Spark集群的文章中已经安装过JDK、Scala。Maven安装也很简单,略。
下载Idea并安装Scala插件
在线安装有点慢,但网上很多方法解决,略。
创建一个maven-scala工程

按向导一步步填写、下一步。
修改 pom.xml文件中的版本号
将scala.version修改成本机安装的Scala版本,并加入hadoop以及spark所需要的依赖,完整的内容如下:
<project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/maven-v4_0_0.xsd">
  <modelVersion>4.0.0</modelVersion>
  <groupId>com.gemantic.bigdata</groupId>
  <artifactId>bigdata-spark</artifactId>
  <version>1.0-SNAPSHOT</version>
  <inceptionYear>2008</inceptionYear>
  <properties>
    <maven.compiler.source>1.7</maven.compiler.source>
    <maven.compiler.target>1.7</maven.compiler.target>
    <scala.version>2.11.4</scala.version>
    <spark.version>2.0.0</spark.version>
    <spark.artifact>2.11</spark.artifact>
    <hbase.version>1.2.2</hbase.version>
    <hadoop.version>2.6.0</hadoop.version>
    <dependency.scope>compile</dependency.scope>
  </properties>

  <repositories>
    <repository>
      <id>scala-tools.org</id>
      <name>Scala-Tools Maven2 Repository</name>
      <url>http://scala-tools.org/repo-releases</url>
    </repository>
  </repositories>

  <pluginRepositories>
    <pluginRepository>
      <id>scala-tools.org</id>
      <name>Scala-Tools Maven2 Repository</name>
      <url>http://scala-tools.org/repo-releases</url>
    </pluginRepository>
  </pluginRepositories>

  <dependencies>
    <dependency>
      <groupId>org.scala-lang</groupId>
      <artifactId>scala-library</artifactId>
      <version>${scala.version}</version>
    </dependency>
    <dependency>
      <groupId>junit</groupId>
      <artifactId>junit</artifactId>
      <version>4.4</version>
      <scope>test</scope>
    </dependency>
    <dependency>
      <groupId>org.specs</groupId>
      <artifactId>specs</artifactId>
      <version>1.2.5</version>
      <scope>test</scope>
    </dependency>

    <dependency>
      <groupId>org.apache.commons</groupId>
      <artifactId>commons-lang3</artifactId>
      <version>3.0</version>
    </dependency>
    <dependency>
      <groupId>org.apache.hadoop</groupId>
      <artifactId>hadoop-hdfs</artifactId>
      <version>${hadoop.version}</version>
    </dependency>
    <dependency>
      <groupId>org.apache.hadoop</groupId>
      <artifactId>hadoop-common</artifactId>
      <version>${hadoop.version}</version>
    </dependency>
    <dependency>
      <groupId>org.apache.spark</groupId>
      <artifactId>spark-core_${spark.artifact}</artifactId>
      <version>${spark.version}</version>
      <scope>${dependency.scope}</scope>
    </dependency>
    <dependency>
      <groupId>org.apache.spark</groupId>
      <artifactId>spark-sql_${spark.artifact}</artifactId>
      <version>${spark.version}</version>
      <scope>${dependency.scope}</scope>
    </dependency>
    <dependency>
      <groupId>org.apache.spark</groupId>
      <artifactId>spark-hive_${spark.artifact}</artifactId>
      <version>${spark.version}</version>
      <scope>${dependency.scope}</scope>
    </dependency>
    <dependency>
      <groupId>org.apache.spark</groupId>
      <artifactId>spark-mllib_${spark.artifact}</artifactId>
      <version>${spark.version}</version>
      <scope>${dependency.scope}</scope>
    </dependency>
    <dependency>
      <groupId>org.apache.spark</groupId>
      <artifactId>spark-streaming-kafka-0-8_2.11</artifactId>
      <version>${spark.version}</version>
      <scope>${dependency.scope}</scope>
    </dependency>
  </dependencies>

  <build>
    <sourceDirectory>src/main/scala</sourceDirectory>
    <testSourceDirectory>src/test/scala</testSourceDirectory>
    <plugins>
      <plugin>
        <groupId>org.scala-tools</groupId>
        <artifactId>maven-scala-plugin</artifactId>
        <executions>
          <execution>
            <goals>
              <goal>compile</goal>
              <goal>testCompile</goal>
            </goals>
          </execution>
        </executions>
        <configuration>
          <scalaVersion>${scala.version}</scalaVersion>
          <args>
            <arg>-target:jvm-${maven.compiler.target}</arg>
          </args>
        </configuration>
      </plugin>
      <plugin>
        <artifactId>maven-assembly-plugin</artifactId>
        <configuration>
          <descriptors>
            <descriptor>src/main/assembly/distribution.xml</descriptor>
          </descriptors>
        </configuration>
      </plugin>
      <plugin>
        <groupId>org.apache.maven.plugins</groupId>
        <artifactId>maven-eclipse-plugin</artifactId>
        <configuration>
          <downloadSources>true</downloadSources>
          <buildcommands>
            <buildcommand>ch.epfl.lamp.sdt.core.scalabuilder</buildcommand>
          </buildcommands>
          <additionalProjectnatures>
            <projectnature>ch.epfl.lamp.sdt.core.scalanature</projectnature>
          </additionalProjectnatures>
          <classpathContainers>
            <classpathContainer>org.eclipse.jdt.launching.JRE_CONTAINER</classpathContainer>
            <classpathContainer>ch.epfl.lamp.sdt.launching.SCALA_CONTAINER</classpathContainer>
          </classpathContainers>
        </configuration>
      </plugin>

    </plugins>

    <resources>
      <resource>
        <directory>src/main/resources</directory>
        <includes>
          <include>**/*</include>
        </includes>
      </resource>
    </resources>
  </build>
  <reporting>
    <plugins>
      <plugin>
        <groupId>org.scala-tools</groupId>
        <artifactId>maven-scala-plugin</artifactId>
        <configuration>
          <scalaVersion>${scala.version}</scalaVersion>
        </configuration>
      </plugin>
    </plugins>
  </reporting>
</project>
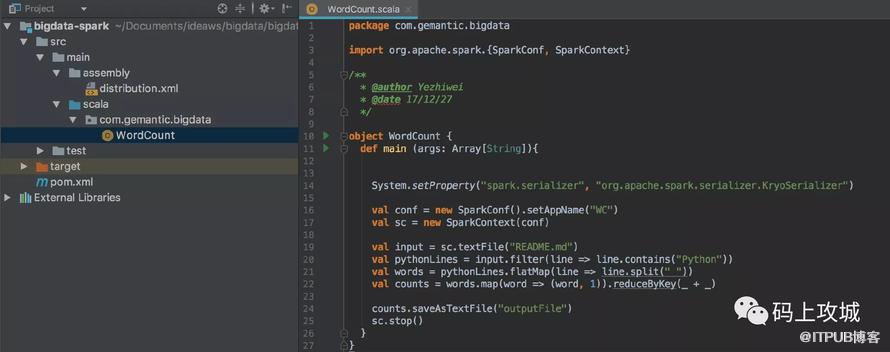
删除自动生成的代码,创建自己的 HelloWorld
实现功能是:把 spark 目录下的
README.md文件中包含Python的行,然后做 Word Count。最后将结果保存到HDFS上。
package com.gemantic.bigdata

import org.apache.spark.{SparkConf, SparkContext}

/**
  * @author Yezhiwei
  * @date 17/12/27
  */

object WordCount {
  def main (args: Array[String]){


    System.setProperty("spark.serializer", "org.apache.spark.serializer.KryoSerializer")

    val conf = new SparkConf().setAppName("WC")
    val sc = new SparkContext(conf)

    val input = sc.textFile("README.md")
    val pythonLines = input.filter(line => line.contains("Python"))
    val words = pythonLines.flatMap(line => line.split(" "))
    val counts = words.map(word => (word, 1)).reduceByKey(_ + _)

    counts.saveAsTextFile("outputFile")
    sc.stop()
  }
}
打包命令
mvn clean package
或者

在 target 目录下生成 bigdata-spark-1.0-SNAPSHOT.jar
上传测试
将上面的 bigdata-spark-1.0-SNAPSHOT.jar 上传到服务器,提交任务到集群,命令如下:
root@ubuntu238:/usr/local/spark-1.6.0-bin-hadoop2.6# ./bin/spark-submit --class com.gemantic.bigdata.WordCount --master yarn-cluster --executor-memory 512m /data/bigdata/spark/lib/bigdata-spark-1.0-SNAPSHOT.jar 10
执行过程中的日志输出:
17/12/28 11:42:08 WARN util.NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
17/12/28 11:42:08 INFO yarn.Client: Requesting a new application from cluster with 2 NodeManagers
17/12/28 11:42:08 INFO yarn.Client: Verifying our application has not requested more than the maximum memory capability of the cluster (8192 MB per container)
17/12/28 11:42:08 INFO yarn.Client: Will allocate AM container, with 896 MB memory including 384 MB overhead
17/12/28 11:42:08 INFO yarn.Client: Setting up container launch context for our AM
17/12/28 11:42:08 INFO yarn.Client: Setting up the launch environment for our AM container
17/12/28 11:42:08 INFO yarn.Client: Preparing resources for our AM container
17/12/28 11:42:09 INFO yarn.Client: Uploading resource file:/usr/local/spark-1.6.0-bin-hadoop2.6/lib/spark-assembly-1.6.0-hadoop2.6.0.jar -> hdfs://masters/user/root/.sparkStaging/application_1514254657629_0009/spark-assembly-1.6.0-hadoop2.6.0.jar
17/12/28 11:42:12 INFO yarn.Client: Uploading resource file:/data/bigdata/spark/lib/bigdata-spark-1.0-SNAPSHOT.jar -> hdfs://masters/user/root/.sparkStaging/application_1514254657629_0009/bigdata-spark-1.0-SNAPSHOT.jar
17/12/28 11:42:12 INFO yarn.Client: Uploading resource file:/tmp/spark-add007da-644d-47f5-99be-2ce1ddf89a4f/__spark_conf__5606044700861845297.zip -> hdfs://masters/user/root/.sparkStaging/application_1514254657629_0009/__spark_conf__5606044700861845297.zip
17/12/28 11:42:12 INFO spark.SecurityManager: Changing view acls to: root
17/12/28 11:42:12 INFO spark.SecurityManager: Changing modify acls to: root
17/12/28 11:42:12 INFO spark.SecurityManager: SecurityManager: authentication disabled; ui acls disabled; users with view permissions: Set(root); users with modify permissions: Set(root)
17/12/28 11:42:12 INFO yarn.Client: Submitting application 9 to ResourceManager
17/12/28 11:42:12 INFO impl.YarnClientImpl: Submitted application application_1514254657629_0009
17/12/28 11:42:13 INFO yarn.Client: Application report for application_1514254657629_0009 (state: ACCEPTED)
17/12/28 11:42:13 INFO yarn.Client:
     client token: N/A
     diagnostics: N/A
     ApplicationMaster host: N/A
     ApplicationMaster RPC port: -1
     queue: default
     start time: 1514432532552
     final status: UNDEFINED
     tracking URL: http://master:8088/proxy/application_1514254657629_0009/
     user: root
17/12/28 11:42:14 INFO yarn.Client: Application report for application_1514254657629_0009 (state: ACCEPTED)

...


17/12/28 11:42:22 INFO yarn.Client: Application report for application_1514254657629_0009 (state: RUNNING)
17/12/28 11:42:22 INFO yarn.Client:
     client token: N/A
     diagnostics: N/A
     ApplicationMaster host: 192.168.111.239
     ApplicationMaster RPC port: 0
     queue: default
     start time: 1514432532552
     final status: UNDEFINED
     tracking URL: http://master:8088/proxy/application_1514254657629_0009/
     user: root
17/12/28 11:42:23 INFO yarn.Client: Application report for application_1514254657629_0009 (state: RUNNING)

...


17/12/28 11:42:39 INFO yarn.Client: Application report for application_1514254657629_0009 (state: FINISHED)
17/12/28 11:42:39 INFO yarn.Client:
     client token: N/A
     diagnostics: N/A
     ApplicationMaster host: 192.168.111.239
     ApplicationMaster RPC port: 0
     queue: default
     start time: 1514432532552
     final status: SUCCEEDED
     tracking URL: http://master:8088/proxy/application_1514254657629_0009/
     user: root
17/12/28 11:42:39 INFO util.ShutdownHookManager: Shutdown hook called
17/12/28 11:42:39 INFO util.ShutdownHookManager: Deleting directory /tmp/spark-add007da-644d-47f5-99be-2ce1ddf89a4f
检查输出
root@ubuntu238:/usr/local/hadoop-2.6.1# ./bin/hdfs dfs -ls /user/root/outputFile
17/12/28 13:09:27 WARN util.NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Found 3 items
-rw-r--r--   3 root supergroup          0 2017-12-28 11:42 /user/root/outputFile/_SUCCESS
-rw-r--r--   3 root supergroup        144 2017-12-28 11:42 /user/root/outputFile/part-00000
-rw-r--r--   3 root supergroup        100 2017-12-28 11:42 /user/root/outputFile/part-00001

root@ubuntu238:/usr/local/hadoop-2.6.1# ./bin/hdfs dfs -text /user/root/outputFile/part-00000
17/12/28 13:10:01 WARN util.NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
(Python,2)
(Interactive,1)
(R,,1)
(can,1)
(Java,,1)
(Shell,1)
(Alternatively,,1)
(shell:,1)
(Scala,,1)
(Python,,2)
(prefer,1)
(engine,1)
(##,1)
root@ubuntu238:/usr/local/hadoop-2.6.1# ./bin/hdfs dfs -text /user/root/outputFile/part-00001
17/12/28 13:10:26 WARN util.NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
(you,2)
(if,1)
(APIs,1)
(that,1)
(high-level,1)
(optimized,1)
(in,1)
(an,1)
(and,2)
(use,1)
(the,1)

原文作者:HelloTech技术派;如有侵权,请联系管理员删除。

