Scrapy 的初步认识

Scrapy 的初步认识
Scrapy 是一个高级的 Python 爬虫框架,它不仅包含了爬虫的特性,还可以方便的将爬虫获取的数据保存到 csv、json 等文件中。
Scrapy 使用了 Twisted 作为框架,Twisted 是事件驱动的,对于会阻塞线程的操作(访问文件、数据库等),比较适合异步的代码。
Scrapy 整体架构
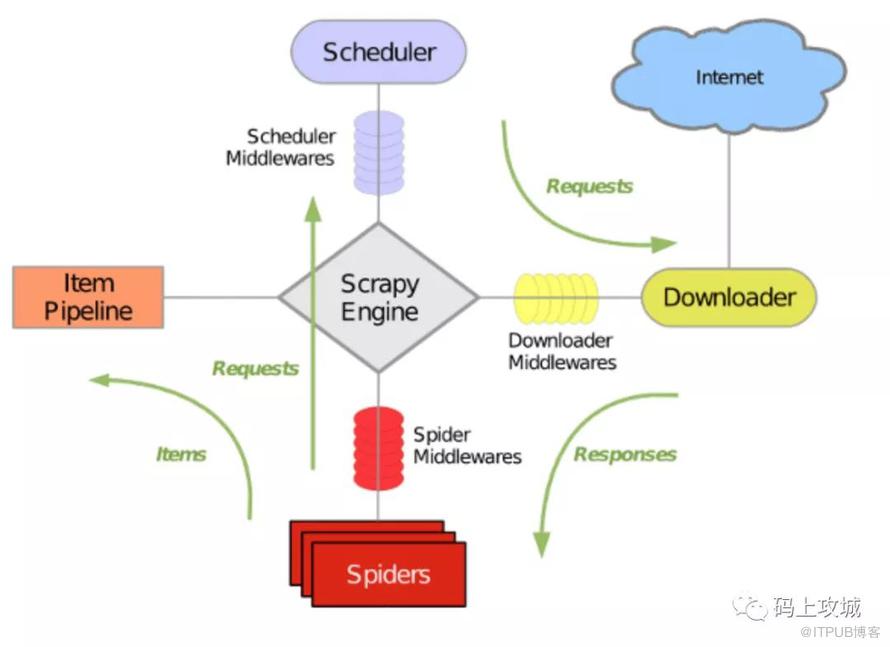
Scrapy 数据流是由执行的核心引擎(Engine)控制,流程是这样的:
Engine 获得初始请求开始抓取。
Engine 开始请求调度程序 Scheduler,并准备对下一次的请求进行抓取。
Scheduler 返回下一个请求给 Engine。
Engine 请求发送到下载器 Downloader,通过下载中间件下载网络数据。
一旦 Downloader 完成页面下载,将下载结果返回给 Engine。
Engine 将 Downloader 的响应通过 Middlewares 返回给 Spider 进行处理。
Spider 处理响应,并通过 Middlewares 返回处理后的 Items,以及新的请求给 Engine。
Engine 发送处理后的 Items 到 Pipeline,然后把处理结果返回给 Scheduler,计划处理下一个请求抓取。
重复该过程(继续步骤1),直到爬取完所有的 url 请求。
项目结构及文件说明
├── EastmoneySpider
│   ├── README.md
│   ├── __init__.py
│   ├── items.py
│   ├── middlewares.py
│   ├── pipelines.py
│   ├── settings.py
│   └── spiders
│       ├── __init__.py
│       ├── blog.py
│       ├── jobbole.py
└── scrapy.cfg
items.py 负责数据模型的建立,类似于实体类。存放的是要爬取数据的字段信息,如:文章标题,文件发布时间,文章 url 地址。
middlewares.py 自己定义的中间件。
pipelines.py 负责对 Spider 返回数据的处理。Pipeline 主要是对 Spider 中爬虫的返回的数据的处理,这里可以让 Items 写入到数据库,也可以让写入到文件。
settings.py 负责对整个爬虫的配置。
spiders目录 负责存放继承自 scrapy 的爬虫类。
为主要的爬虫代码,包括了对页面的请求以及页面的处理,parse 方法的 response 返回的是这个页面的信息,这时如果需要对获取的每个文章的地址继续访问,就用到了 yield Request() 这种用法,可以把获取到文章的 url 地址继续传递进来再次进行请求(如:爬取文章列表页,然后继续爬去文章详情页的场景)。
scrapy 提供了 response.css 这种的 css 选择器以及 response.xpath 的 xpath 选择器方法,可以根据自己的需求获取想要的字段信息
scrapy.cfg scrapy 基础配置
原文作者:HelloTech技术派;如有侵权,请联系管理员删除。

