表存在,为何报错?Python多数据源配置中的1146错误
背景
在Python服务中配置多个数据源时,可能会遇到调用查询接口时报1146表不存在的错误,尽管实际上表是存在的。通过日志输出的SQL语句进行测试时,也能够正常查询出数据。为什么会报 1146 表不存在的错误呢?
这个问题的主要原因是在配置多个数据源时,执行查询数据的方法命名相同,导致在调用工具接口时没有连接到预期的数据源。下面将详细介绍这个问题的原因,并提供解决方法。
问题分析
在开发Python服务时,使用多个数据源可以让我们在应用程序中连接和操作多个数据库。这在某些场景下非常有用。然而,如果不小心处理多数据源的配置,就有可能遇到上述问题。
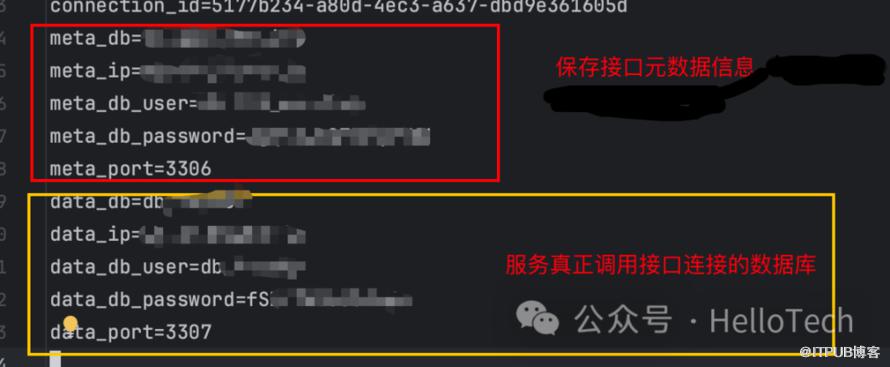
如下图所示:一个数据源负责保存元数据信息,另一个数据源是业务数据,查询接口使用的数据源。
代码示例
meta 数据库配置(meta_database.py)
meta_ip = os.getenv("meta_ip")
meta_db = os.getenv("meta_db")
meta_db_user = os.getenv("meta_db_user")
meta_db_password = os.getenv("meta_db_password")
meta_port = os.getenv("meta_port")

SQLALCHEMY_DATABASE_URL = f"mysql+aiomysql://{meta_db_user}:{meta_db_password}@{meta_ip}:{meta_port}/{meta_db}?charset=utf8"

async_meta_engine = create_async_engine(
    SQLALCHEMY_DATABASE_URL, pool_pre_ping=True, echo=True
)

AsyncMetaSessionLocal = async_sessionmaker(
    bind=async_meta_engine,
    autoflush=False,
    future=True,
)

async def execute_query(query, *args, **kwargs):
    async with AsyncMetaSessionLocal() as session:
        result = await session.execute(query, *args, **kwargs)
        return result

async def fetch_one(query, *args, **kwargs):
    result = await execute_query(query, *args, **kwargs)
    return result.scalars().first()

async def fetch_all(query, *args, **kwargs):
    result = await execute_query(query, *args, **kwargs)
    return result.scalars().all()
data 数据库配置(data_database.py)
data_ip = os.getenv("data_ip")
data_db = os.getenv("data_db")
data_db_user = os.getenv("data_db_user")
data_db_password = os.getenv("data_db_password")
data_port = os.getenv("data_port")

SQLALCHEMY_DATABASE_URL = f"mysql+aiomysql://{data_db_user}:{data_db_password}@{data_ip}:{data_port}/{data_db}?charset=utf8"

async_engine = create_async_engine(
    SQLALCHEMY_DATABASE_URL, pool_pre_ping=True, echo=True
)

AsyncSessionLocal = async_sessionmaker(
    bind=async_engine,
    autoflush=False,
    future=True,
)

async def execute_query(query, *args, **kwargs):
    async with AsyncSessionLocal() as session:
        result = await session.execute(query, *args, **kwargs)
        return result

async def fetch_one(query, *args, **kwargs):
    result = await execute_query(query, *args, **kwargs)
    return result.scalars().first()

async def fetch_all(query, *args, **kwargs):
    result = await execute_query(query, *args, **kwargs)
    return result.scalars().all()
两个文件中的代码基本一样,从环境变量中获取配置信息,并且每个数据源都有独立的连接和会话。只是其中的查询数据的方法(fetch_one、fetch_all)是一样的。
在配置多个数据源时,我们需要确保每个数据源都有独立的连接和会话。然而,在这种情况下,问题出现在执行查询数据的方法命名上。在两个数据源的配置中,方法名称都是相同的 ,如fetch_all,这导致在调用工具接口时无法正确地连接到期望的数据源,进而报告表不存在的错误。
当不同的模块或库中具有相同的方法名称时,可能会导致以下问题:
命名冲突:如果多个模块都定义了相同名称的方法,那么在使用这些模块时,可能会导致命名冲突。调用该方法时,解释器可能无法确定使用哪个模块中的方法。 不可预测的行为:如果多个模块中具有相同名称的方法,但实现方式不同,那么在调用该方法时可能会导致不可预测的行为。具体使用哪个方法取决于导入模块的顺序和上下文。
解决方法
为了避免以上问题,可以考虑以下几种解决方案:
使用命名空间:将方法放置在不同的命名空间或模块中,可以避免命名冲突。通过在调用方法时指定完整的命名空间或模块名称,可以明确地指定要使用的方法。 重命名方法:如果修改这些模块的代码的权限,可以尝试为冲突的方法重命名,以避免冲突。确保在所有使用该方法的地方进行相应的修改。 使用别名:如果无法修改模块的代码,但需要同时使用这些模块中的方法,可以使用别名来区分它们。在导入模块时,可以为模块指定别名,并在调用方法时使用相应的别名来消除歧义。
在代码中,为fetch_all方法添加别名,以区分不同的数据源。以下是示例代码:

通过为方法添加别名,可以明确指定要使用的方法,避免与其他模块中可能存在的同名方法冲突。
小结
在开发过程中,为了避免这类问题,我们应该仔细设计模块和方法的命名,确保它们不会和其他模块发生冲突。同时,在配置多个数据源时,要确保每个数据源都有独立的连接和会话,避免混淆和错误的发生。
以上是解决Python多数据源配置引发的表不存在错误的一些方法和建议。欢迎留言讨论哈
推荐阅读
原文作者:HelloTech技术派;如有侵权,请联系管理员删除。

