逻辑回归模型在很多领域都有应用,比如:
病人是否患病(阴性、阳性) 客户未来违约情况(违约、不违约) 客户流失预测 企业经营风险预测 等等其他。。。。
逻辑回归(Logistic Regression)是一种用于解决二分类问题的机器学习方法,用于估计某种事物的可能性。逻辑回归是一个分类算法而不是回归算法。通常是利用已知的自变量来预测一个离散型因变量的值(像二进制值0/1,是/否,真/假)。它就是通过拟合一个逻辑函数(logit fuction)来预测一个事件发生的概率。
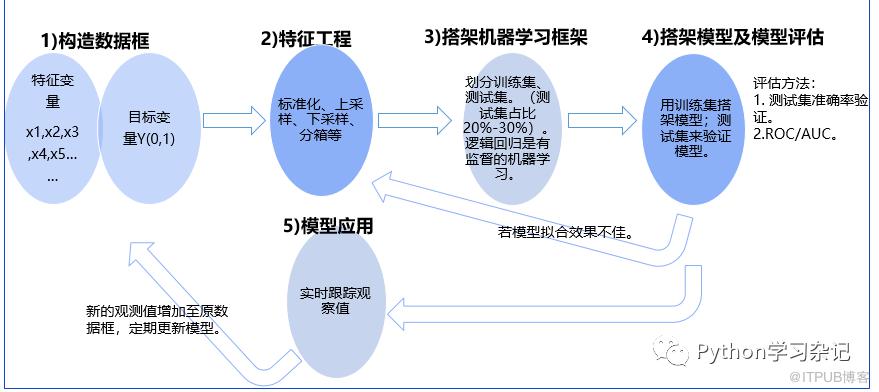
1.构建数据框
2.特征工程(分箱)
3.搭建机器学习框架
在此处进行了标准化,标准化放在第二步和第三步都可以。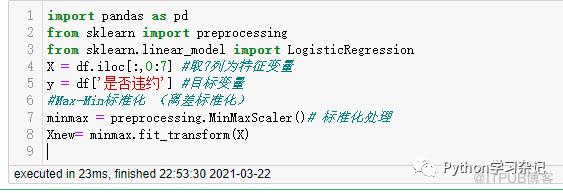
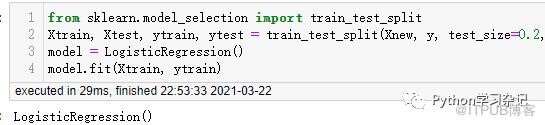
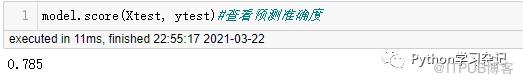
4.搭架逻辑回归模型并评估模型

5.逻辑回归模型应用测试
def ppp_pjb(x0,x1,x2,x3,x4,x5,x6):
      B=pd.DataFrame([x0,x1,x2,x3,x4,x5,x6]).T
      B.columns =df1.iloc[:,0:7].columns
      dfn=pd.concat([df1.iloc[:,0:7],B],ignore_index=True)
      dfn['地区'] =dfn['地区'].replace({'北京':3,'上海':3,'浙江':2,'江苏':2 ,'安徽':1,'江西':1,'河南':1,'湖北':1})
      dfn['性别'] =dfn['性别'].replace({'男':1,'女':0})
      dfn['学历'] =dfn['学历'].replace({'专科及以下':1,'本科':2,'硕士及以上':3})
      dfn.收入=pd.cut(dfn.收入,[0,100000,200000,300000,1000000],labels=[1,2,3,4])
      dfn.年龄=pd.cut(dfn.年龄,[0,30,40,60],labels=[1,2,3])
      dfn.历史授信额度=pd.cut(dfn.历史授信额度,[0,40000,70000,200000],labels=[1,2,3])
      from sklearn.model_selection import train_test_split
      minmax = preprocessing.MinMaxScaler()# 标准化处理
      Xn= minmax.fit_transform(dfn)
      if model.predict([ Xn[-1]])[0]==1:
          return  print('基础信息:【'+'地区:'+x0+',收入:'+str(x1)+',年龄:'+str(x2)+',性别:'+x3+',历史授信额度:'+str(x4)+
                        ',学历:'+x5+',历史违约次数:'+str(x6)+'】'+'\n'+'预测结果:【违约,'+'模型测算违约率为'+
                          str(round(model.predict_proba(Xn)[-1][1],2))+'】')
      else:
          return  print('基础信息:【'+'地区:'+x0+',收入:'+str(x1)+',年龄:'+str(x2)+',性别:'+x3+',历史授信额度:'+str(x4)+
                        ',学历:'+x5+',历史违约次数:'+str(x6)+'】'+'\n'+'预测结果:【不违约,'+'模型测算违约率为'+
                        str(round(model.predict_proba(Xn)[-1][1],2))+'】')
6.完整代码
import pandas as pd
from sklearn import preprocessing
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import roc_auc_score, roc_curve
import matplotlib.pyplot as plt
df= pd.read_excel('客户信息及违约情况new.xlsx')
df['地区'] =df['地区'].replace({'北京':3,'上海':3,'浙江':2,'江苏':2 ,'安徽':1,'江西':1,'河南':1,'湖北':1})
df['性别'] =df['性别'].replace({'男':1,'女':0})
df['学历'] =df['学历'].replace({'专科及以下':1,'本科':2,'硕士及以上':3})
df.收入=pd.cut(df.收入,[0,100000,200000,300000,1000000],labels=[1,2,3,4])
df.年龄=pd.cut(df.年龄,[18,30,40,60],labels=[1,2,3])
df.历史授信额度=pd.cut(df.历史授信额度,[0,40000,70000,100000],labels=[1,2,3])
X = df.iloc[:,0:7] #取7列为特征变量
y = df['是否违约'] #目标变量
Xtrain, Xtest, ytrain, ytest = train_test_split(X, y, test_size=0.2, random_state=3)  # 划分训练集和测试集
#Max-Min标准化 (离差标准化)
#建立MinMaxScaler对象
minmax = preprocessing.MinMaxScaler()
# 标准化处理
Xtrainb= minmax.fit_transform(Xtrain)
Xtestb = minmax.fit_transform(Xtest)
model = LogisticRegression()
model.fit(Xtrainb, ytrain)
print('测试集预测准确率:',model.score(Xtestb, ytest))#查看预测准确度
ypred_proba = model.predict_proba(Xtestb)
fpr, tpr, thres = roc_curve(ytest, ypred_proba[:, 1])
plt.figure(figsize=(10,7))
plt.rcParams['font.sans-serif'] = ['SimHei']  # 设置中文
plt.plot(fpr, tpr)  # 通过plot()函数绘制折线图
plt.title('ROC曲线',fontsize=20)  # 添加标题
plt.xlabel('FPR',fontsize=20)  # 添加X轴标签
plt.ylabel('TPR',fontsize=20)  # 添加Y轴标
plt.tick_params(labelsize=20)
print('AUC:',round(roc_auc_score(ytest, ypred_proba[:,1]),2))
print('系数:',[round(model.fit(Xtrainb, ytrain).coef_[0][i],2) for i in range(7)],'\n截距项:',round(model.intercept_[0],2))
运行结果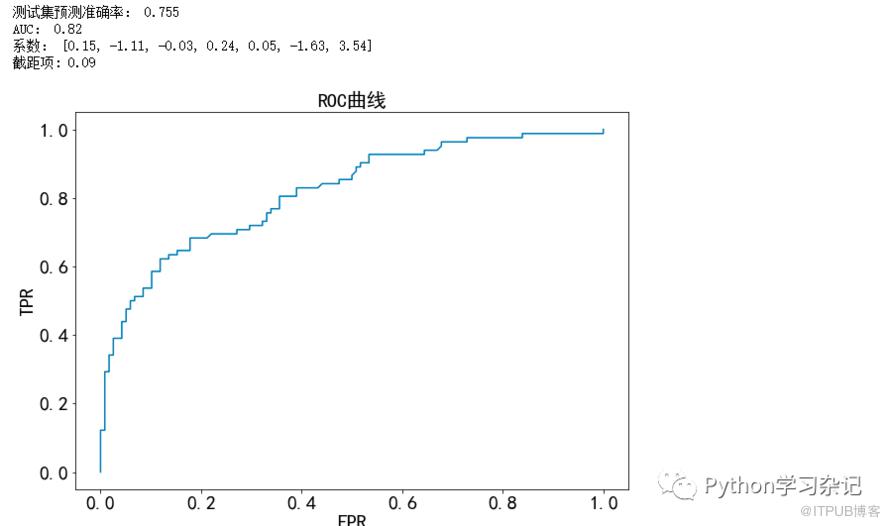
7.模型的延伸(评分卡模型)
本文介绍的只是逻辑回归的一个简化案例,实际上实际业务中比本案例要复杂。各大银行使用的评分卡模型也是由逻辑回归模型搭架,但其对逻辑回归进行了进一步优化,其优化的步骤如下:
1)在特征工程部分,对特征进行分箱,与总样本对比,计算woe编码,最终计算信息权重IV,根据信息权重筛选出权重占比较大的特征变量。
2)评分方法:先给一个基础分,评分按照每个特征值分箱相对于总样本的偏差 (ODDS,好坏比)相应的扣分和加分。
3)一般分为A卡(贷前,申请评分卡)、B卡(贷中,行为评分卡)、C卡(贷后,催收评分卡),对应特征变量不全相同,但评分方法大致相同。
原文作者:Python学习杂记;如有侵权,请联系管理员删除。
上一篇:
k-近邻算法介绍及实例
下一篇:
常用快捷键汇总

请登录后发表评论
登录
全部评论
