之前我做数据处理经常使用pandas库,numpy用的相对较少。但在编写遗传算法的时候有个轮盘对赌选取基因的过程,发现用numpy写就很方便了。现在把numpy的基本使用简单归纳一下。
先看一段代码: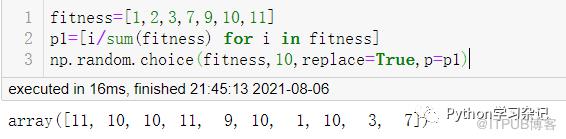 上面的代码含义:在fitness里面取数取10次,
其每个值取到的概率对应在p1里面,replace=True是指取样是可以重复取。可以看看更简单的过程:
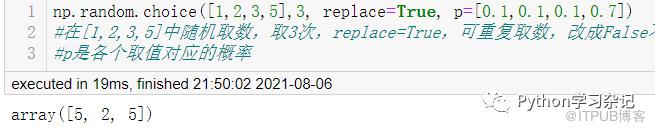 如果每个数取到的概率一样,那也可以实现自举抽样的过程。可见numpy在很多时候还是很方便的。本文归纳一下numpy更多的基础的用法。
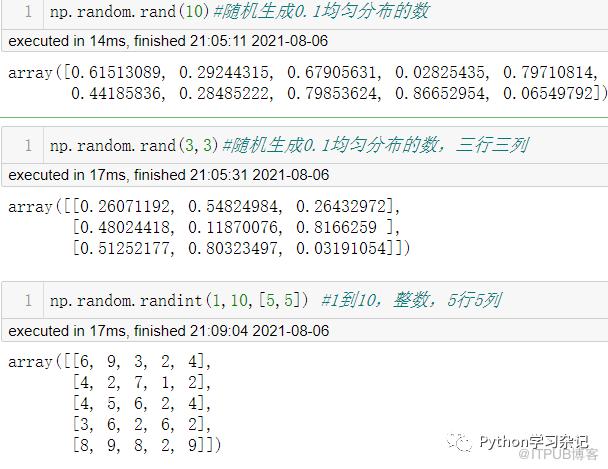
生成数列
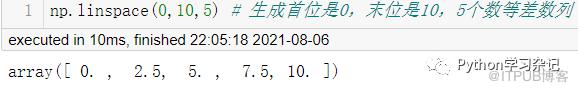
这些数列,一般是有规律的数列,方便后续做运算。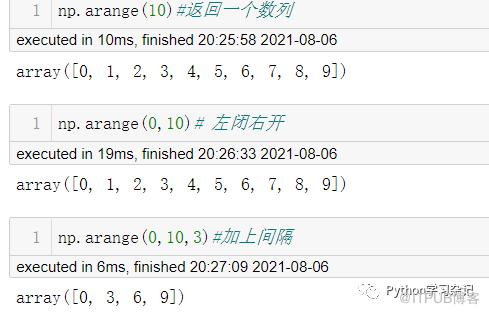
生成矩阵
这些矩阵可以先生成,先搭个框架,后面再通过循环迭代,更新矩阵里的数据,其作用类似于pandas的DataFrame.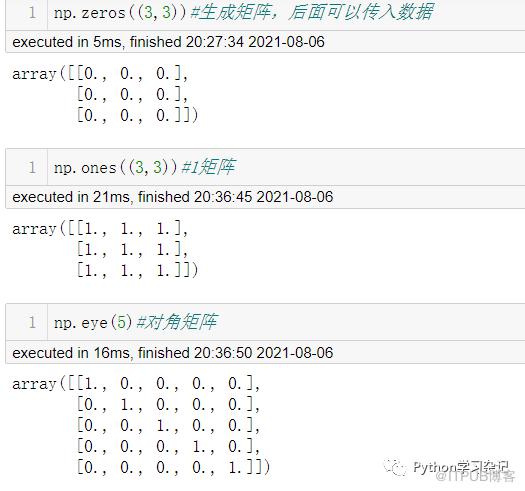
筛选数据
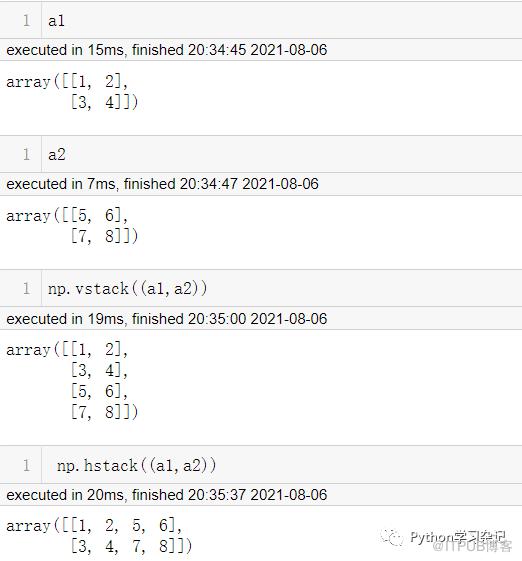
矩阵拼接
数据拼接经常用到,numpy也很方便。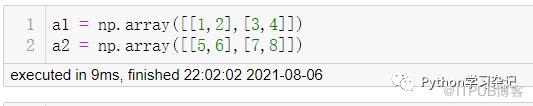
矩阵的乘法
在数据处理中,经常遇到乘法求和,可以直接通过矩阵的乘法实现。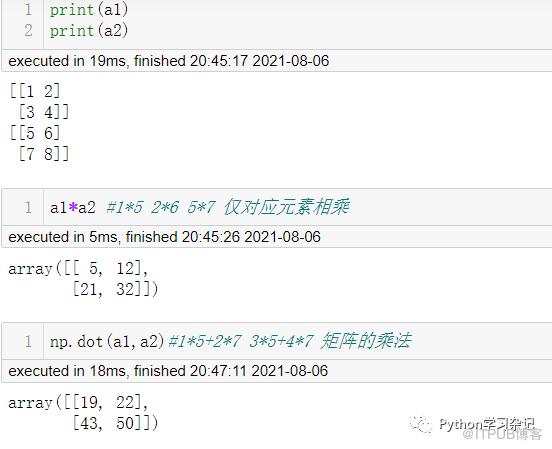
其他常见的用法
有时候需要提取数据中最大值、最小值的索引、对数据求和、求平均值等等,numpy里都能很快实现。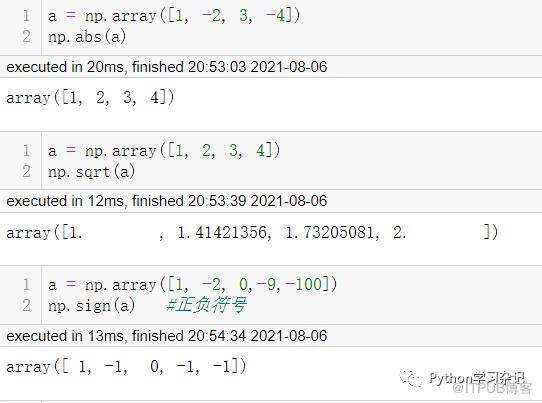
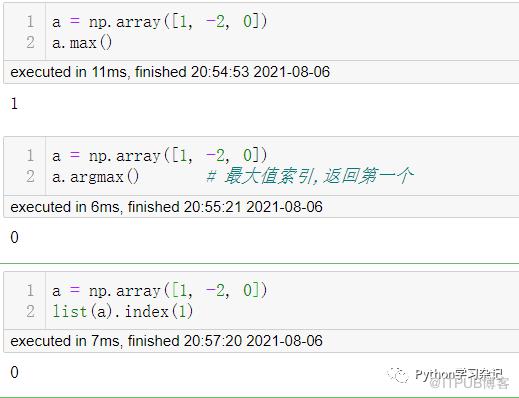
 本文简单介绍了一下numpy的基本常用功能,如果想深入学习可以去查看官网文档。
前面有朋友留言问到,jupyter如何显示运行时间,要安装了一个插件 nbextensions,只需要在Anaconda Prompt中输入如下命令:
pip install jupyter_contrib_nbextensions
jupyter contrib nbextension install --user
打开jupyter会多了一个选项框,勾上显示运行时间即可。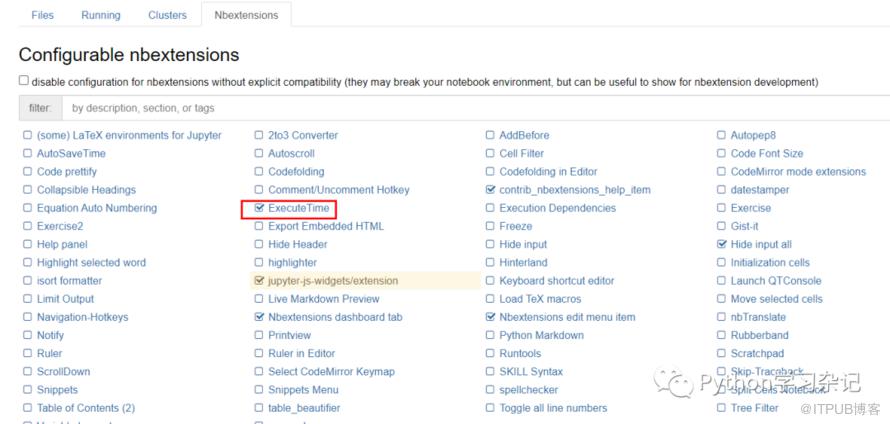
原文作者:Python学习杂记;如有侵权,请联系管理员删除。

请登录后发表评论
登录
全部评论
