or-tools是谷歌AI系列的运筹优化系列的包,里面提供了很多不错的优化工具。从官网上看,or-tools能解决的问题主要有线性优化、整数优化、路由(车辆运输问题)、装箱、调度(排程、工作分配)等问题。感兴趣的朋友可以去官网学习。
对应排程问题,or-tools也提供了很好的解决方案。假如有个工厂的5台机器,要进行5个大类的作业,的工序如下: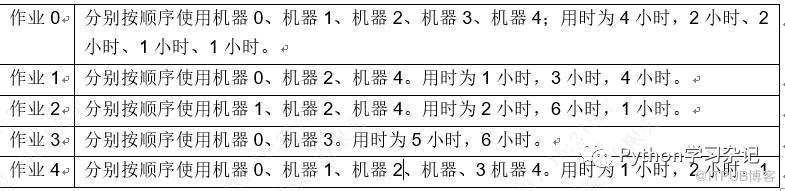 现在的问题是如何进行分配作业,使该工序全部完成使用的时间最短。
转化为模型可读的数据
    jobs_data = [  # task = (machine_id, processing_time).
        [(0,4),(1,2), (2,2),(3,1),(4,1)], # Job0
        [(0,1),(2,3),(4,4)], # Job1
        [(1,2),(2,6),(4,1),],# Job2
        [(0,5),(3,6)],#Job3
        [(0,1),(1,2),(2,1),(3,3),(4,3)]#Job4
    ]
调用cp-sat求解器
cp-sat求解器是非常经典的非线性约束求解器,谷歌or-tools直接可以调用该求解器。调用代码如下
import collections

# Import Python wrapper for or-tools CP-SAT solver.
from ortools.sat.python import cp_model


def MinimalJobshopSat():
    """Minimal jobshop problem."""
    # Create the model.
    model = cp_model.CpModel()

    jobs_data = [  # task = (machine_id, processing_time).
        [(0,4),(1,2), (2,2),(3,1),(4,1)], # Job0
        [(0,1),(2,3),(4,4)], # Job1
        [(1,2),(2,6),(4,1),],# Job2
        [(0,5),(3,6)],#Job3
        [(0,1),(1,2),(2,1),(3,3),(4,3)]#Job4
    ]

    machines_count = 1 + max(task[0] for job in jobs_data for task in job)
    all_machines = range(machines_count)

    # Computes horizon dynamically as the sum of all durations.
    horizon = sum(task[1] for job in jobs_data for task in job)

    # Named tuple to store information about created variables.
    task_type = collections.namedtuple('task_type', 'start end interval')
    # Named tuple to manipulate solution information.
    assigned_task_type = collections.namedtuple('assigned_task_type',
                                                'start job index duration')

    # Creates job intervals and add to the corresponding machine lists.
    all_tasks = {}
    machine_to_intervals = collections.defaultdict(list)

    for job_id, job in enumerate(jobs_data):
        for task_id, task in enumerate(job):
            machine = task[0]
            duration = task[1]
            suffix = '_%i_%i' % (job_id, task_id)
            start_var = model.NewIntVar(0, horizon, 'start' + suffix)
            end_var = model.NewIntVar(0, horizon, 'end' + suffix)
            interval_var = model.NewIntervalVar(start_var, duration, end_var,
                                                'interval' + suffix)
            all_tasks[job_id, task_id] = task_type(start=start_var,
                                                   end=end_var,
                                                   interval=interval_var)
            machine_to_intervals[machine].append(interval_var)

    # Create and add disjunctive constraints.
    for machine in all_machines:
        model.AddNoOverlap(machine_to_intervals[machine])

    # Precedences inside a job.
    for job_id, job in enumerate(jobs_data):
        for task_id in range(len(job) - 1):
            model.Add(all_tasks[job_id, task_id +
                                1].start >= all_tasks[job_id, task_id].end)

    # Makespan objective.
    obj_var = model.NewIntVar(0, horizon, 'makespan')
    model.AddMaxEquality(obj_var, [
        all_tasks[job_id, len(job) - 1].end
        for job_id, job in enumerate(jobs_data)
    ])
    model.Minimize(obj_var)

    # Solve model.
    solver = cp_model.CpSolver()
    status = solver.Solve(model)

    if status == cp_model.OPTIMAL:
        # Create one list of assigned tasks per machine.
        assigned_jobs = collections.defaultdict(list)
        for job_id, job in enumerate(jobs_data):
            for task_id, task in enumerate(job):
                machine = task[0]
                assigned_jobs[machine].append(
                    assigned_task_type(start=solver.Value(
                        all_tasks[job_id, task_id].start),
                                       job=job_id,
                                       index=task_id,
                                       duration=task[1]))

        # Create per machine output lines.
        output = ''
        for machine in all_machines:
            # Sort by starting time.
            assigned_jobs[machine].sort()
            sol_line_tasks = '机器 ' + str(machine) + ': '
            sol_line = '           '

            for assigned_task in assigned_jobs[machine]:
                name = '作业_%i_%i' % (assigned_task.job, assigned_task.index)
                # Add spaces to output to align columns.
                sol_line_tasks += '%-10s' % name

                start = assigned_task.start
                duration = assigned_task.duration
                sol_tmp = '[%i,%i]' % (start, start + duration)
                # Add spaces to output to align columns.
                sol_line += '%-10s' % sol_tmp

            sol_line += '\n'
            sol_line_tasks += '\n'
            output += sol_line_tasks
            output += sol_line

        # Finally print the solution found.
        print('最优耗时: %i' % solver.ObjectiveValue())
        print(output)


MinimalJobshopSat()
查看输出结果并画甘特图
上面的程序跑出来最优排程如下,其排程的结果是17小时可完成所有作业。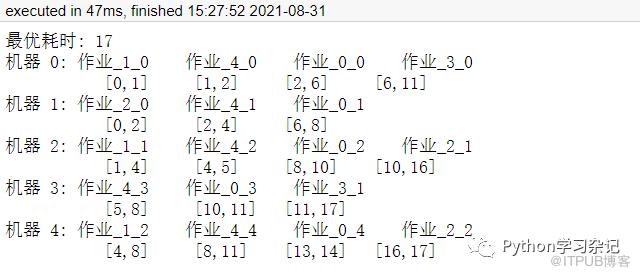 排程甘特图
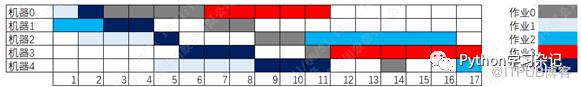 从甘特图可以发现:对于作业0的最后一项工序,往后推2个小时也可以,也是合理的,不影响最后的总时长。
原文作者:Python学习杂记;如有侵权,请联系管理员删除。
上一篇:
Python制作gif动图
下一篇:
Python大屏可视化

请登录后发表评论
登录
全部评论
