我们在做聚类分析的时候,有时候比较困惑的是如何确定最佳聚类簇数,比如k-means的k到底取多少?比较流行的方法是用手肘法,观察SSE的拐点处,这个需要通过直观观察去判定,人的直观判定总是会存在误差。
轮廓系数是判定聚类的k值比较好的一个指标,它是聚类效果好坏的一种评价方式。最早由Peter J. Rousseeuw在1986提出,它结合内聚度和分离度两种因素,可以用来在相同原始数据的基础上用来评价不同算法、或者算法不同运行方式对聚类结果所产生的影响。
轮廓系数公式
轮廓系数的概念和公式
轮廓系数用于衡量聚类结果的紧密度和分离度。轮廓系数的公式为:
s = (b-a)/max(a,b),
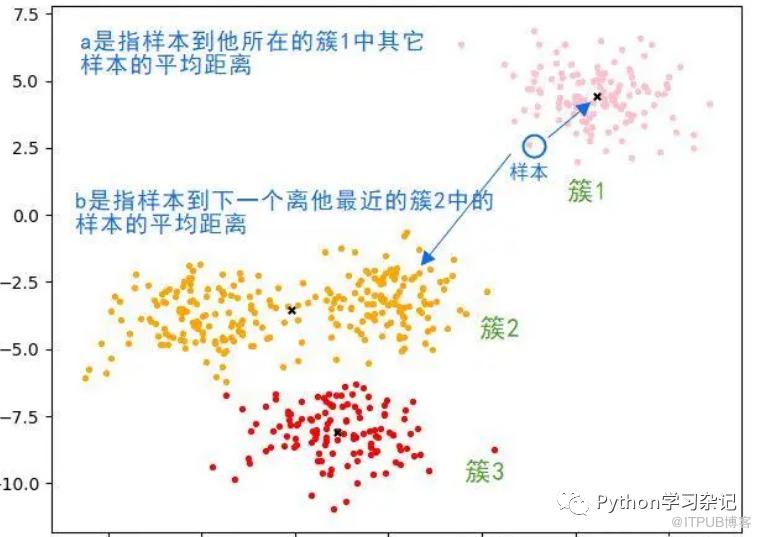
计算 b(i) =min(i向量到某一不包含它的簇内的所有点的平均距离)。
其中,a是簇内不相似度的平均值,称为内聚度;b是簇间不相似度的平均值,称为分离度。
最后计算每个向量数据的轮廓系数,并求平均值就是整个模型分类后的轮廓系数。
轮廓系数的意义
轮廓系数的值在-1到1之间,值越大表示聚类结果越好。 当值为负数时,表示聚类结果不佳,数据点更适合被分配到其他簇。 当值接近0时,表示聚类结果不明显,数据点的分配可能不太合理。 当值接近1时,表示聚类结果很好,数据点与所在簇的其他数据点很相似,与其他簇的数据点很不相似。
kmeans算法流程
1、选择K个点作为初始质心。
2、将每个点指派到最近的质心,形成K个簇。
3、对于上一步聚类的结果,进行平均计算,得出该簇的新的聚类中心。
4、重复上述两步/直到迭代结束:质心不发生变化。
轮廓系数计算
直接调包计算
from sklearn.cluster import KMeans
from sklearn.metrics import silhouette_score
import numpy as np
# 生成数据集
np.random.seed(1)
X= np.random.uniform(1,10, size=(50, 2))
# 定义不同的K值进行聚类
for k in range(2, 8):
    kmeans = KMeans(n_clusters=k, random_state=42)
    kmeans.fit(X)
    labels = kmeans.labels_
    # 计算轮廓系数
    score = silhouette_score(X, labels)
    print(f"K={k}, 轮廓系数={score:.2f}")
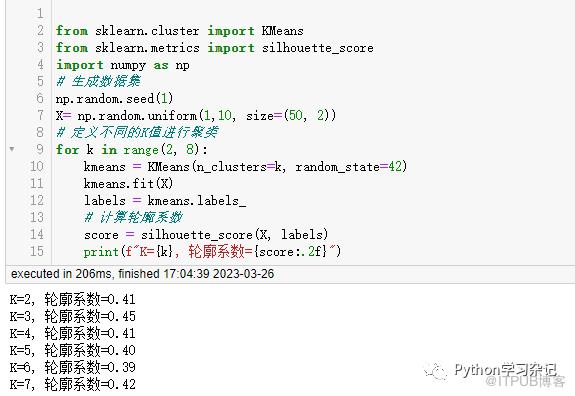
输出结果
手工计算
为了更清楚的了解轮廓系数原理,现在手动编写轮廓系数的计算过程,还是以kmeans每次最后聚类的结果数据为输入数据,计算轮廓系数。
1)内聚度
a=np.sum([np.linalg.norm(X[m] - center) for center in X[a11[j]]])/(len(a11[j])-1)
2)分离度
##轮廓系数b的计算
c=[]#存储平均数据
for j2 in arr_1:
    c1=np.sum([np.linalg.norm(X[m] - center) for center in X[a11[j2]]])/(len(a11[j2]))
    c.append(c1)
b=min(c)
3)每个点的轮廓系数
s.append((b-a)/max(a,b))#把每点轮廓系数都存储起来,后续对s求平均值即可
4)完整代码及输出

可以观察到,结果跟kmeans调包计算的轮廓系数结果一致。当然轮廓系数也有一些缺点:比如对于簇结构为凸的数据轮廓系数值高,而对于簇结构非凸需要使用DBSCAN进行聚类的数据,轮廓系数值低,因此,不同聚类算法之间不应该以轮廓系数来评价。
原文作者:Python学习杂记;如有侵权,请联系管理员删除。

