k-means++
这是一个基于k-means算法的改进,对初始簇做了更合理的选择,在选择簇的时候,距离之前簇更远的点被选到的概率更大。K-Means++对初始聚类中心点的选取做了优化,简要来说就是使初始聚类中心点尽可能的分散开来,这样可以有效减少迭代次数,加快运算速度。
from pyclustering.cluster.center_initializer import kmeans_plusplus_initializer
from pyclustering.cluster.kmeans import kmeans
from pyclustering.cluster import cluster_visualizer
from pyclustering.utils import read_sample
from pyclustering.samples.definitions import SIMPLE_SAMPLES
# Read data 'SampleSimple3' from Simple Sample collection.
sample = read_sample(SIMPLE_SAMPLES.SAMPLE_SIMPLE3)
# Calculate initial centers using K-Means++ method.
centers = kmeans_plusplus_initializer(sample, 4, kmeans_plusplus_initializer.FARTHEST_CENTER_CANDIDATE).initialize()
# Display initial centers.
visualizer = cluster_visualizer()
visualizer.append_cluster(sample)
visualizer.append_cluster(centers, marker='*', markersize=10)
visualizer.show()

# Perform cluster analysis using K-Means algorithm with initial centers.
kmeans_instance = kmeans(sample, centers)

# Run clustering process and obtain result.
kmeans_instance.process()
k-median
k-median 算法是k-means 算法的一种变形。它的基本原理和我们的k-means 相似。这个就是最重要的一句话。
如果你会了k-means 算法,那么k-median 算法就很好理解。因为k-means 定义的时候就是不断更换中心,中心的选取是根据聚类的平均值也就是我们的means 来定的。那么k-medians 选取的就是我们的中位数。
from pyclustering.cluster.kmedians import kmedians
from pyclustering.cluster import cluster_visualizer
from pyclustering.utils import read_sample
from pyclustering.samples.definitions import FCPS_SAMPLES

# Load list of points for cluster analysis.
sample = read_sample(FCPS_SAMPLES.SAMPLE_TWO_DIAMONDS)

# Create instance of K-Medians algorithm.
initial_medians = [[0.0, 0.1], [2.5, 0.7]]
kmedians_instance = kmedians(sample, initial_medians)

# Run cluster analysis and obtain results.
kmedians_instance.process()
clusters = kmedians_instance.get_clusters()
medians = kmedians_instance.get_medians()

# Visualize clustering results.
visualizer = cluster_visualizer()
visualizer.append_clusters(clusters, sample)
visualizer.append_cluster(initial_medians, marker='*', markersize=10)
visualizer.append_cluster(medians, marker='*', markersize=10)
visualizer.show()
K-Medoids
K-Medoids(中心点)算法不选用平均值,转而采用簇中位置最中心的对象,即中心点(medoids)作为参照点,算法步骤也和 K-means类似,其实质上是对 K-means算法的改进和优化。因此,K-Medoids最大的区别,最后的簇心一定是已有数据中的点,并不是随机生成的新点。
from pyclustering.cluster.kmedoids import kmedoids
from pyclustering.cluster.center_initializer import kmeans_plusplus_initializer
from pyclustering.cluster import cluster_visualizer
from pyclustering.utils import read_sample
from pyclustering.samples.definitions import FCPS_SAMPLES

# Load list of points for cluster analysis.
sample = read_sample(FCPS_SAMPLES.SAMPLE_TWO_DIAMONDS)

# Initialize initial medoids using K-Means++ algorithm
initial_medoids = kmeans_plusplus_initializer(sample, 2).initialize(return_index=True)

# Create instance of K-Medoids (PAM) algorithm.
kmedoids_instance = kmedoids(sample, initial_medoids)

# Run cluster analysis and obtain results.
kmedoids_instance.process()
clusters = kmedoids_instance.get_clusters()
medoids = kmedoids_instance.get_medoids()

# Print allocated clusters.
#print("Clusters:", clusters)

# Display clustering results.
visualizer = cluster_visualizer()
visualizer.append_clusters(clusters, sample)
visualizer.append_cluster(initial_medoids, sample, markersize=12, marker='*', color='gray')
visualizer.append_cluster(medoids, sample, markersize=14, marker='*', color='black')
visualizer.show()
GA聚类
基本原理。对于选定的k,距离的核心指标误差平方和sse为遗传算法的目标,该目标越小越好,根据该目标设定适应度函数,使用遗传算法聚类。
from pyclustering.cluster.ga import genetic_algorithm, ga_observer, ga_visualizer
from pyclustering.utils import read_sample
from pyclustering.samples.definitions import SIMPLE_SAMPLES


# Read data for clustering
sample = read_sample(SIMPLE_SAMPLES.SAMPLE_SIMPLE1)

# Create instance of observer that will collect all information:
observer_instance = ga_observer(True, True, True)

# Create genetic algorithm where observer will collect information:
ga_instance = genetic_algorithm(data=sample,
                                count_clusters=2,
                                chromosome_count=20,
                                population_count=20,
                                count_mutation_gens=1,
                                observer=observer_instance)

# Start processing
ga_instance.process()

# Obtain results
clusters = ga_instance.get_clusters()

# Print cluster to console
print("Amount of clusters: '%d'. Clusters: '%s'" % (len(clusters), clusters))

# Show cluster using observer:
ga_visualizer.show_clusters(sample, observer_instance)
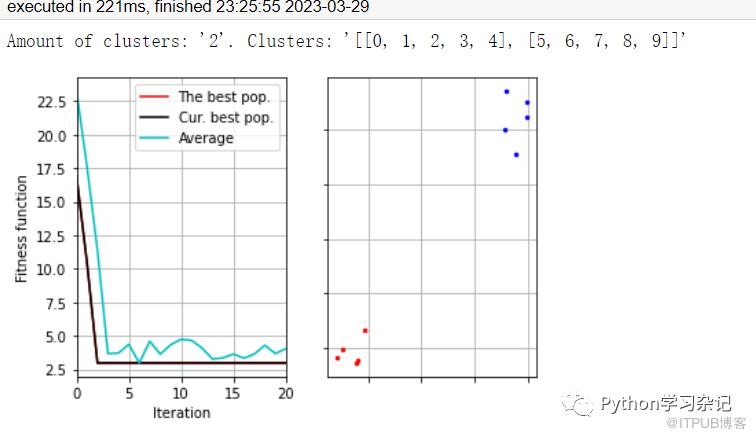
除了以上聚类方法之外,官方文档还有许多聚类方法,并且有详细的函数介绍。感兴趣的可以去官网继续学习。
原文作者:Python学习杂记;如有侵权,请联系管理员删除。
上一篇:
时间复杂度:一步步理解算法效率
下一篇:
凸优化介绍

请登录后发表评论
登录
全部评论
