在数学和机器学习领域,梯度是一个至关重要的概念,它描述了函数在某一点上的变化率和方向。理解梯度的本质对于掌握优化算法,尤其是梯度下降法至关重要。本文将介绍梯度、梯度下降的基本原理,并展示其基础的代码实现。
梯度
在多变量微积分中,梯度是一个向量,它指向函数值增加最快的方向,并且其大小等于该方向的最大增量。对于一个标量场(多个变量的函数),梯度提供了在每一点上函数变化最剧烈的方向。
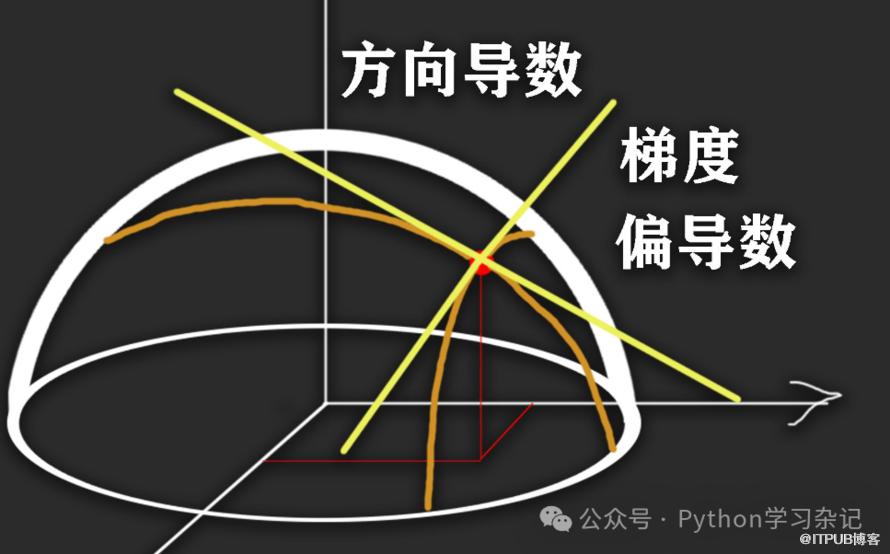
例如,假设有一个二维函数f(x, y),
其在点(x₀, y₀)处的梯度可以表示为:
∇f(x₀, y₀) = (∂f/∂x, ∂f/∂y) 其中,∂f/∂x和∂f/∂y是函数f相对于x和y的偏导数。
梯度下降概念及其应用
梯度下降是一种迭代算法,用于找到使得目标函数最小化的参数值。在每次迭代中,算法沿着当前点的负梯度方向移动一小步,因为负梯度方向是函数值下降最快的方向。
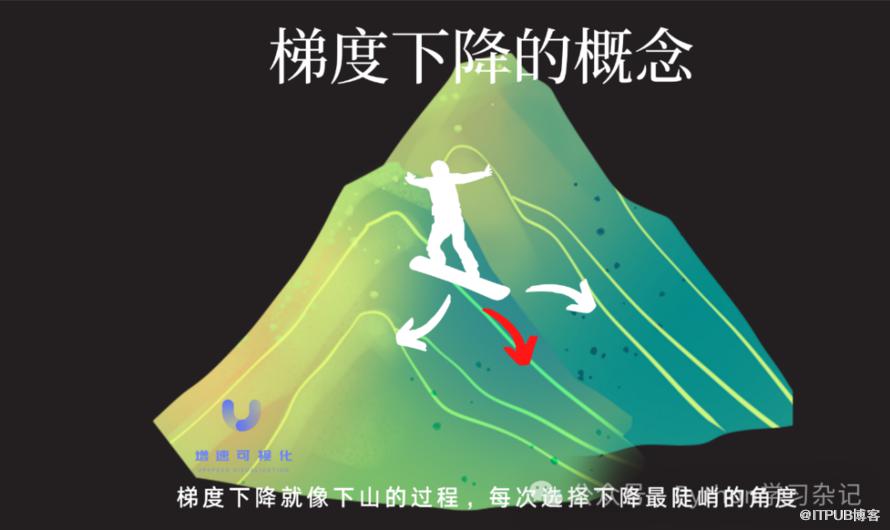
这个过程重复进行,直到达到某个停止准则,如梯度的大小足够小或者迭代次数达到预设值。梯度下降被广泛应用多个领域:
机器学习
梯度下降是训练神经网络和其他机器学习算法中最常用的优化方法之一。通过最小化损失函数,梯度下降可以使算法在给定的数据集上学习到最佳的模型参数。例如,在图像分类中,梯度下降可用于调整卷积神经网络的权重和偏差,以使网络能够准确预测图像中的对象。
物理建模
在物理建模中,梯度下降可以用于拟合实验数据和优化模型参数。例如,科学家可以使用梯度下降来确定物理模型中的未知参数,从而最佳地匹配模型与观测结果。
自然语言处理
在自然语言处理中,梯度下降可用于训练语言模型和嵌入式表示。通过最小化损失函数,梯度下降可以调整文本生成模型以产生更准确和流畅的句子。
金融市场预测
梯度下降可用于基于历史数据来预测金融市场趋势。通过最小化损失函数,梯度下降可以动态调整投资策略,以使预测结果最大化。
图像处理
在图像处理中,梯度下降可用于图像恢复和去噪。通过最小化图像的损失函数,梯度下降可以找到最佳的参数组合,以使图像恢复或去噪的结果最佳。
优化问题
在经济学、工程学等领域,许多问题可以被形式化为寻找最优解的优化问题。
深度学习
神经网络的训练通常涉及到大量的参数调整,梯度下降是最常用的参数优化方法之一。
应用案例
梯度下降优化步骤
具体来说,梯度下降算法包括以下几个步骤:
初始化参数:我们需要为模型参数设定一个初始值。这些参数可以是随机值,也可以是基于某些方法的初始估计值。
计算梯度:计算目标函数在当前参数值下的梯度。对于多元函数,梯度包含了所有变量的偏导数。
更新参数:根据计算出的梯度来更新参数。更新方向是梯度的反方向,即函数值下降最快的方向。更新步长由学习率控制,学习率是一个超参数,需根据实际情况调整。
迭代更新:重复步骤2和步骤3,直到满足停止条件。停止条件可以是达到预设的迭代次数,或者是梯度小于某个阈值,或是目标函数值的变化小于某个阈值等。
梯度下降算法可能陷入局部最优解而非全局最优解,特别是在目标函数非凸的情况下。此外,学习率的选择对算法的收敛速度和稳定性也有很大影响。学习率过大,可能导致算法在最小值附近震荡而无法收敛;学习率过小,则可能导致算法收敛速度过慢。
基础代码示例
下面是一个简单的梯度下降算法实现的Python代码示例,用于求解一元线性回归问题的参数优化:
import numpy as np

# 定义一元线性回归模型的目标函数(均方误差)
def mse_loss(X, y, w, b):
    y_pred = X.dot(w) + b
    return np.mean((y_pred - y) ** 2)

# 定义梯度计算函数
def compute_gradients(X, y, w, b):
    m = len(y)
    y_pred = X.dot(w) + b
    dw = -2/m * np.sum(X * (y - y_pred))
    db = -2/m * np.sum(y - y_pred)
    return dw, db

# 梯度下降算法实现
def gradient_descent(X, y, w_init, b_init, learning_rate, epochs):
    w = w_init
    b = b_init

    # 记录损失值以便后续分析
    losses = []

    for epoch in range(epochs):
        # 计算梯度
        dw, db = compute_gradients(X, y, w, b)

        # 更新参数
        w -= learning_rate * dw
        b -= learning_rate * db

        # 计算当前损失值并记录
        loss = mse_loss(X, y, w, b)
        losses.append(loss)

        # 打印当前迭代次数和损失值(可选)
        print(f"Epoch {epoch+1}/{epochs}, Loss: {loss:.4f}")

    return w, b, losses

# 示例数据
X = np.array([[1], [2], [3], [4], [5]])  # 特征值
y = np.array([2, 4, 6, 8, 10])  # 目标值

# 初始化参数和学习率
w_init = 0
b_init = 0
learning_rate = 0.01
epochs = 1000

# 执行梯度下降算法并获取结果
w, b, losses = gradient_descent(X, y, w_init, b_init, learning_rate, epochs)
print(f"Optimized weights: w = {w:.2f}, b = {b:.2f}")
Epoch 995/1000, Loss: 8.0000
Epoch 996/1000, Loss: 8.0000
Epoch 997/1000, Loss: 8.0000
Epoch 998/1000, Loss: 8.0000
Epoch 999/1000, Loss: 8.0000
Epoch 1000/1000, Loss: 8.0000
Optimized weights: w = 0.00, b = 6.00这段代码首先定义了目标函数(均方误差)和梯度计算函数,然后实现了梯度下降算法。在算法实现中,使用了循环来迭代更新参数,在每次迭代后计算并记录当前的损失值。
原文作者:Python学习杂记;如有侵权,请联系管理员删除。

