Sweetviz 是一个开源的Python库,它能够生成美观、高密度的可视化图表,以此来启动探索性数据分析(EDA)。通过仅需两行代码,就可以输出一个完全自包含的HTML应用程序。Sweetviz 的目标是快速可视化目标值和比较数据集,帮助用户快速分析目标特征、训练数据与测试数据之间的差异,以及其他数据特征任务。
本文介绍使用sweetviz如何快速生成数据报告。
安装画图库
pip install sweetviz导入数据
我这里用的网上标准泰坦尼克的训练数据和测试数据。数据下载地址:https://drive.google.com/file/d/11MgXvwics58UwiMjUSWJDAjn6hiflC-W/view
import sweetviz
import pandas as pd
train = pd.read_csv("train.csv")
test = pd.read_csv("test.csv")
生成报告
我们现在有2个数据帧(训练和测试),我们想分析目标值“Survived”。我们可以用以下代码生成一个报告:
my_report = sweetviz.compare([train, "Train"], [test, "Test"], "Survived")运行此命令将执行分析并创建报表对象。要获取输出,只需使用以下命令:show_html()
my_report.show_html("Report.html") # Not providing a filename will default to SWEETVIZ_REPORT.html报告解读
报告摘要
摘要并排显示了两个数据帧的特征。我们可以立即确定测试集的大小大约是训练集的一半,但它包含相同的特征。底部的图例向我们表明,训练集确实包含“Survived”目标变量,但测试集不包含。
请注意,Sweetviz 将在确定每列的数据类型时进行最佳猜测,介于数字、类别/布尔值和文本之间。这些可以被覆盖,下面会详细介绍。
数据关联关系
 以上图表表示数据之间的关联性,具体关联性如何查看,可详细阅读后续的官方文档链接,这里只做简要的介绍。
重要说明:分类-分类关联(由不确定性系数提供)是不对称的,这意味着每行表示行标题(左侧)提供每列信息的程度。例如,“Pclass”和“Fare”是提供有关“Survived”最多信息的元素。对于泰坦尼克号数据集,这些信息是相当对称的,但并不是每次都这样。
最后,这些关联/关联方法只是它们对数据和关系的基本分布做出初步假设。
目标变量
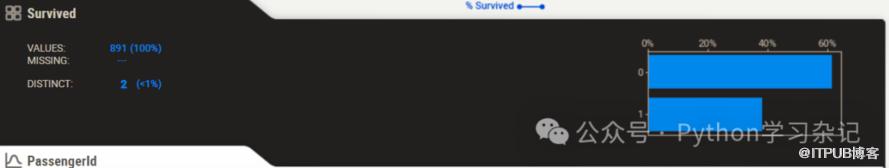 目前只能将数值和布尔要素作为目标。指定目标变量后,它将首先显示在一个特殊的黑框中。
从这个总结中我们可以得出结论,“Survived”在训练集中没有缺失数据(891,100%),有 2 个不同的可能值(占所有值的不到 1%),从图中可以估计出大约 60% 没有存活。
详细区域(分类/布尔值)
当您将鼠标悬停在任何变量上时,右侧的区域将显示详细信息。详细信息的内容取决于要分析的变量的类型。对于分类(或布尔值)变量,与目标变量一样,分析如下:
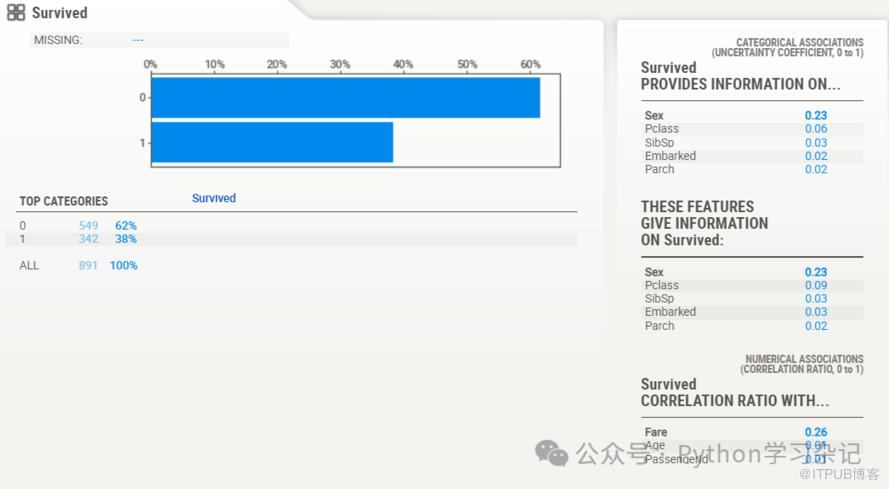 在这里,我们可以看到每个班级的确切统计数据,其中 62% 没有幸存下来,38% 幸存下来。您还可以获得其他每个功能的关联的详细信息。
数值数据
数值数据显示有关其摘要的更多信息。在这里,我们可以看到,在这种情况下,大约有 20% 的数据丢失。目标值(在本例中为“Survived”)绘制为一条直线,位于分布图的正上方。这样可以即时分析目标分布相对于其他变量。
详细数值数据
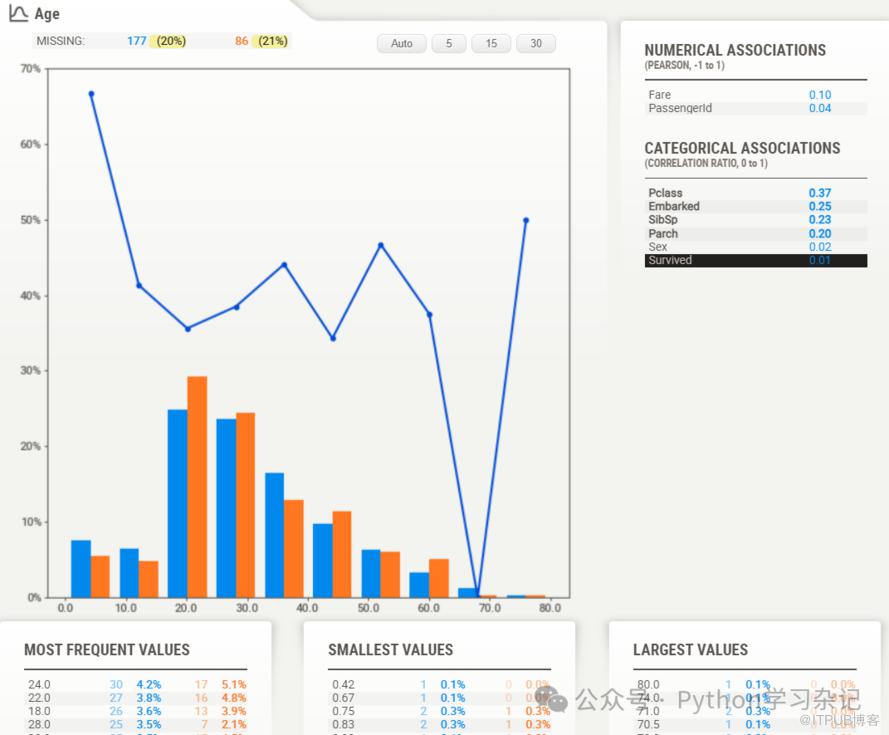 与分类数据类型一样,数值数据类型在其详细信息区域中显示一些额外的信息。值得注意的是图表顶部的按钮。这些按钮会更改图表中显示的“条柱”数量。可以选择以下选项:自动/5/15/30。
文本数据
目前,系统不认为是数字或分类的任何内容都将被视为“文本”。文本要素目前仅将计数(百分比)显示为统计数据。
其他
官方网站还有其他的更详细的显示界面说明,如果想了解更多的信息的朋友可参考以下链接。
https://towardsdatascience.com/powerful-eda-exploratory-data-analysis-in-just-two-lines-of-code-using-sweetviz-6c943d32f34
https://github.com/fbdesignpro/sweetviz?tab=readme-ov-file
原文作者:Python学习杂记;如有侵权,请联系管理员删除。

