本文将介绍使用Python对数据快速进行统计分析的30个经典操作,包括计算平均值、中位数、众数、方差、移动平均、相关系数等。
先建一个简单的列表数据,后续对该列表进行相应的数据统计分析。
import numpy as np

data = [1, 2, 3, 4, 5, 10, 4, 5, 10, 4, 5]
计算平均值、最大值、最小值中位数、众数、方差、标准差等
from scipy import stats
import numpy as np
mean = np.mean(data)#平均值
max_value = np.max(data)#最大值
min_value = np.min(data)#最小值
median = np.median(data)#中位数
mode = stats.mode(data)#众数
variance = np.var(data)#方差
std_dev = np.std(data)#标准差
range_value = np.ptp(data)#极差
计算分位数
q1 = np.percentile(data, 25)
q3 = np.percentile(data, 75)
percentile_90 = np.percentile(data, 90)
计算偏度
skewness = stats.skew(data)
计算峰度
kurtosis = stats.kurtosis(data)
计算相关系数
data1 = [1, 2, 3, 4, 5]
data2 = [2, 4, 6, 8, 10]
correlation = np.corrcoef(data1, data2)[0, 1]
计算协方差
covariance = np.cov(data1, data2)[0, 1]
计算累积和
cumulative_sum = np.cumsum(data)
计算累积积
cumulative_product = np.cumprod(data)
计算累积最大值和最小值
cumulative_max = np.maximum.accumulate(data)
cumulative_min = np.minimum.accumulate(data)
计算累积平均值
cumulative_mean = np.cumsum(data) / np.arange(1, len(data) + 1)
计算累积方差
cumulative_variance = np.cumsum((data - mean) ** 2) / np.arange(1, len(data) + 1)
计算累积标准差
cumulative_std_dev = np.sqrt(cumulative_variance)
计算移动平均
def moving_average(data, window_size):
    return [sum(data[i:i+window_size])/window_size for i in range(len(data)-window_size+1)]
计算指数加权移动平均(EWMA)
def ewma(data, alpha):
    ewma = [data[0]]
    for i in range(1, len(data)):
        ewma.append(alpha * data[i] + (1 - alpha) * ewma[-1])
    return ewma
计算列表元素的Z分数(标准分数)
def z_scores(data):
    mean = np.mean(data)
    std_dev = np.std(data)
    return [(x - mean) / std_dev for x in data]
计算列表数据的累积密度函数(Cumulative Distribution Function, CDF)
def cdf(data):
    sorted_data = sorted(data)
    return [len(sorted_data[:i+1])/len(data) for i in range(len(data))]
计算概率密度函数(Probability Density Function, PDF)
def pdf(data, bins=10):
    histrogram, bin_edges = np.histogram(data, bins=bins, density=True)
    return histrogram
计算列表的排序索引
def rank_data(data):
    sorted_data = sorted([(value, idx) for idx, value in enumerate(data)])
    return [idx for value, idx in sorted_data]
计算列表的逆序对数量
def count_inversions(data):
    return sum(1 for i in range(len(data)) for j in range(i+1, len(data)) if data[i] > data[j])
计算列表的中位数绝对偏差(MAD)
def mad(data):
    median_val = np.median(data)
    return np.median(np.abs(data - median_val))
计算列表元素的二阶矩(M2)
def M2(data):
    n = len(data)
    mean = np.mean(data)
    return sum((x - mean) ** 2 for x in data) / n
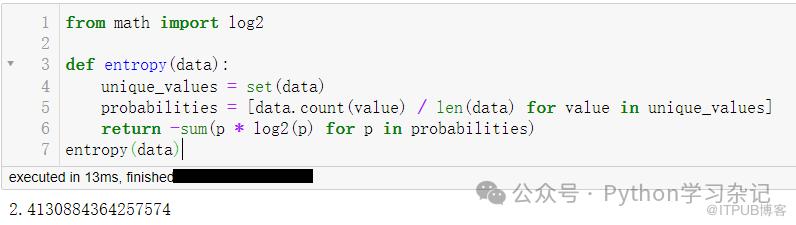
计算信息熵
from math import log2

def entropy(data):
    unique_values = set(data)
    probabilities = [data.count(value) / len(data) for value in unique_values]
    return -sum(p * log2(p) for p in probabilities)
entropy(data)
计算列表的自动相关性
import pandas as pd

def autocorrelation(data, lag=1):
    series = pd.Series(data)
    return series.autocorr(lag)
计算Pearson相关系数矩阵
def pearson_corr_matrix(data_list):
    df = pd.DataFrame(data_list)
    return df.corr()
计算Jackknife统计量
from statsmodels.stats.outliers_influence import variance_inflation_factor

def jackknife_statistics(data):
    return [variance_inflation_factor(pd.Series(data), i) for i in range(len(data))]
计算列表的元素频率
def frequency_count(data):
    freq_dict = {}
    for item in data:
        if item in freq_dict:
            freq_dict[item] += 1
        else:
            freq_dict[item] = 1
    return freq_dict
生成数据的频率分布表
def frequency_distribution(data, bins=10):
    histogram, bin_edges = np.histogram(data, bins=bins)
    return histogram, bin_edges
计算列表的中位数绝对偏差比率(Median Absolute Deviation Ratio)
def mad_ratio(data):
    median = np.median(data)
    mad = np.median(np.abs(data - median))
    return mad / np.std(data)
检测列表中的线性趋势
def linear_trend(data):
    import numpy as np
    x = range(len(data))
    slope, intercept, r_value, p_value, std_err = stats.linregress(x, data)
    return slope, intercept, r_value
计算列表的三角矩(Trimmed Mean)
def trimmed_mean(data, proportion=0.1):
    sorted_data = sorted(data)
    trim_amnt = int(len(data) * proportion)
    trimmed_data = sorted_data[trim_amnt:-trim_amnt]
    return np.mean(trimmed_data)
以上是30个使用Python对数据进行统计分析的经典操作,涵盖了从基本的描述性统计到更高级的统计度量。每个操作都附有代码实现,以便读者方便地在实际应用中使用这些方法。
原文作者:Python学习杂记;如有侵权,请联系管理员删除。
上一篇:
Python字典常用的20个经典操作

请登录后发表评论
登录
全部评论
