在数据科学和分析领域,Pandas是一个广泛使用的Python库,它提供了丰富的数据分析和处理的操作。
然而,当处理大规模数据集时,Pandas的性能可能会受到影响。NumPy可与Pandas结合使用来优化数据处理流程。本文将通过一个具体的样本数据来展示如何使用Numpy提升Pandas处理数据的效率。
1. 准备样本数据
首先,我们创建一个包含10000行和4列的样本数据集,使用Pandas来生成这个数据集。
import pandas as pd
import numpy as np

# 设置随机种子以获得可复现的结果
np.random.seed(0)

# 创建数据
data = {
    'Column1': np.random.randn(10000),
    'Column2': np.random.randint(1, 100, size=10000),
    'Column3': np.random.choice(['A', 'B', 'C', 'D'], size=10000),
    'Column4': np.random.rand(10000)
}

# 创建DataFrame
df = pd.DataFrame(data)
df
2. 利用NumPy进行向量化操作
向量化操作可以避免Python的循环,从而提高性能。以下是如何使用NumPy进行向量化操作的示例。
# 向量化计算Column1的平方
df['Column1_squared'] = np.square(df['Column1'])
df
3. 使用NumPy进行条件筛选
NumPy的布尔索引可以与Pandas的DataFrame结合使用,以实现快速的条件筛选。
# 筛选出Column2大于50的行
df_filtered = df[df['Column2'].values > 50]
df_filtered
4. 利用NumPy进行聚合操作
虽然Pandas提供了丰富的聚合函数,但在某些情况下,使用NumPy进行聚合可以提高效率。
# 计算Column1的平均值
average = np.mean(df['Column1'])
average
5. 利用NumPy进行复杂的数学运算
NumPy提供了广泛的数学函数库,这些函数通常比Pandas的等效函数更快。
# 计算Column1的标准差
std_dev = np.std(df['Column1'], ddof=1)
std_dev
6. 优化内存使用
NumPy数组允许你指定数据类型,这可以减少内存使用并提高性能。
# 将Column2转换为更小的数据类型
df['Column2'] = df['Column2'].astype(np.uint8)
7. 性能测试
在优化数据处理流程时,进行性能测试是非常重要的。以下是如何使用Python的timeit模块来评估不同方法的性能。
import timeit

# 测试Pandas和NumPy方法的性能
pandas_time = timeit.timeit('df["Column1"].mean()', globals=globals(), number=100000)
numpy_time = timeit.timeit('np.mean(df["Column1"].values)', globals=globals(), number=100000)

print(f"Pandas mean time: {pandas_time}")
print(f"NumPy mean time: {numpy_time}")
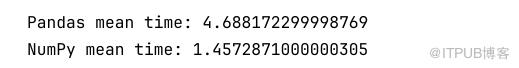 从输出结果来看,通过运行10万次测试,Numpy要快3倍多。
8. 结论
本文简单介绍了使用NumPy如何在Pandas中使用来提高数据处理性能。通过结合使用NumPy和Pandas,可以在保持数据处理的灵活性的同时,提高运算效率。
原文作者:Python学习杂记;如有侵权,请联系管理员删除。
上一篇:
机器学习中的监督学习和无监督学习
下一篇:
使用Python第三方库高效处理时间数据

请登录后发表评论
登录
全部评论
