Python下载B站视频
看B站的时候,有时候看到很喜欢的总想下载下来,虽然APP里提供了下载,但奈何下载的格式不知道是什么格式,无法在其他播放器里看,于是就想下载到电脑本地播放。当然,就目前而言,WiFi和流量其实足以替代大部分硬件存储。所以这个需求不是很高,只是个人爱好。
那么网页上什么视频是可以下载,什么视频不能下载呢?简单来说:只要你能在网页观看的视频,都是可以下载的,因为你的浏览器接受到了视频文件才能播放,而我们只需要获取到这些文件就行。当然这依个人技术和网站,有些网站就是不让你下载,层层加密,一般人破解不了,但这只是个别,大部分还是正常的,要层层加密网站开发可是要多出钱的。加密的话一般是将视频的接口加密,也有在视频文件上做手脚的。
现在我们就B站举个例子。首先,打开某个视频链接,按F12,点击播放视频,这样network里面就有很多数据:
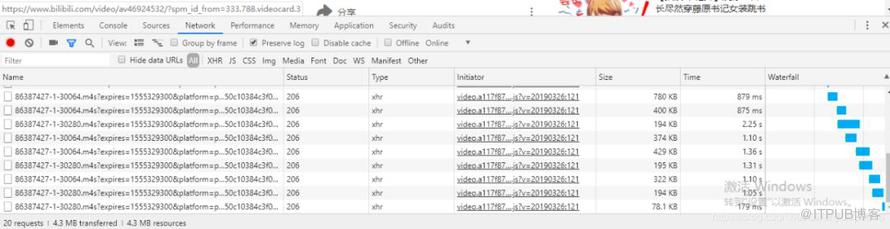
接着,我们一条一条数据看,直到你看到下面这样的:

那么,右边的这些是什么意思呢,这是二进制数据,所以以文本格式打开会显示乱码,这些大概率是视频文件,如果是图片文件的话浏览器是会正常显示的。我们接着看headers里的信息:
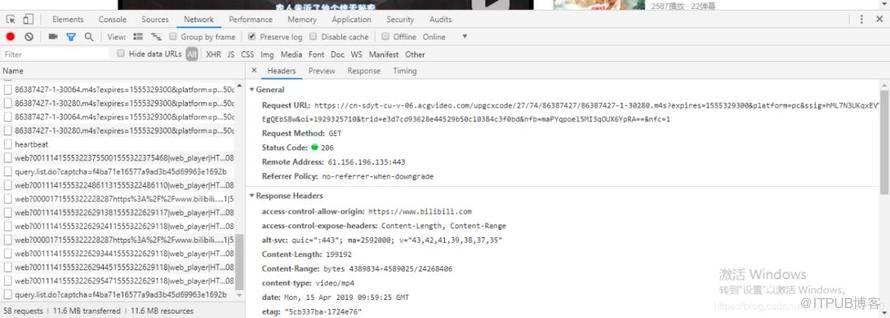
我们来解读一下headers里面的信息:
Request URL: 发起请求的URL,视频的下载地址
Request Method: 请求的类型,视频下载正常为GET
Status Code: 状态码,206的话说明链接下的文件是支持range参数的,也就是说我请求头里加一个range参数,说明你想要文件的哪一段,这为文件的断点续传和多进程下载提供了便利
Remote Address: 服务器地址,没什么软用
接着看响应头(response headers):
Content-Length: 返回文件长度
Content-Range: bytes4389834-4589025/24268406 (文件位置和总长度,单位字节)
Content-type: video/mp4 ,文件类型
这三个是我们看中的,其他没什么用
请求头(requests headers)
Provisional headers are shown ,这是谷歌浏览器的一个小问题,只会显示一部分请求头。我查了一下,大概意思是:浏览器其实并未向远程服务器发送请求,这条请求可能是请求本地已缓存的资源,也可能是其他某些原因。我试了下清空缓存,然后就显示了完整的头信息。
Origin: 值不重要,加入爬虫头信息就行
Range:bytes=4389834-4589025 ,你要请求的数据
Referer:访问的上一个页面,一般会动态构建,比如av地址
User-Agent: 这个不多说
我们先分析URL是怎么来的,看一下没什么规律,应该不是js动态构建的,那么要么是通过接口返回的,要么是在从原网页中和网页结构一起返回的。
我们随便打开一个视频:https://www.bilibili.com/video/av49336067/。在network里的response,Ctrl+f搜索视频的链接,如果没有则搜索链接里面的一些关键词,应该有可能数据在js里面,然后动态构建的。
视频链接确实在网页返回的数据中,不过当一个网页含有多个视频的时候,就有一点小小的区别,这时候网页数据里没有视频链接,需要带上aid和cid请求另一个接口得到视频的下载地址,这里就不多说了,具体看代码或者自己去尝试。B站没有任何加密很简单。
需要源代码请点击阅读全文。
原文作者:Python成长路;如有侵权,请联系管理员删除。

