scrapyd的Windows管理客户端
ScrapydManage
GitHub地址:https://github.com/kanadeblisst/ScrapydManage
码云:https://gitee.com/kanadeblisst/ScrapydManage
前段时间无聊写的一个scrapyd的Windows管理客户端,软件只是将scrapyd的api集成到exe文件中,软件是由aardio写的,上面有源码,可以自行编译,也可以下载GitHub中release已编译的exe文件。
温馨提示:因为aardio语言只是由一个人在维护,论坛也关闭了,所以可能会出现一些问题,这很难找到原因并解决。这个我现在测试了一下还能用,不过以前写的一个hook微信的软件已经无法正常注入dll了。 功能和界面都很简单,想要完善的话可以二次开发。
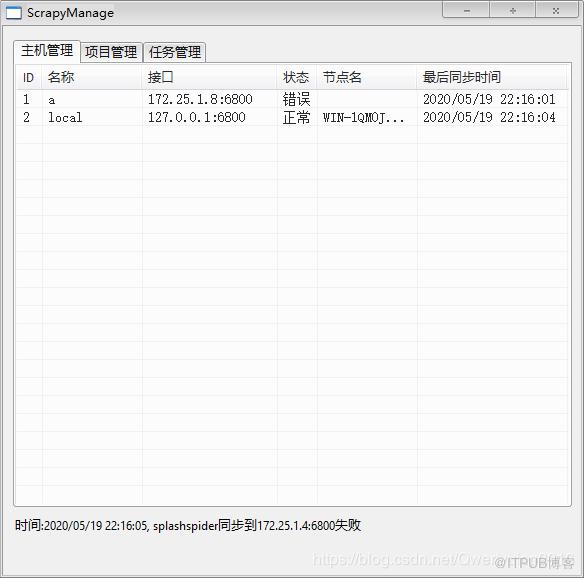
主机管理界面
右键菜单: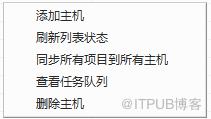
添加主机
添加主机就是添加scrapyd的api地址,例如127.0.0.1:6800。不理解scrapyd怎么使用的可以参考官方文档:https://scrapyd.readthedocs.io/en/stable/index.html。其实很简单,pip install scrapyd,然后命令行输入scrapyd,或者先在当前目录创建scrapyd.conf,修改一些配置参数然后在输入scrapyd运行。
【参考配置】:
[scrapyd]
eggs_dir    = D:/scrapyd/eggs # egg存放路径
logs_dir    = D:/scrapyd/logs # log存放路径
items_dir   = D:/scrapyd/items # item存放路径
jobs_to_keep = 5
dbs_dir     = D:/scrapyd/dbs  # dbs存放路径
max_proc    = 0
max_proc_per_cpu = 4
finished_to_keep = 100
poll_interval = 5.0
bind_address = 0.0.0.0   # 绑定地址
http_port   = 6800       # 绑定端口
debug       = off
runner      = scrapyd.runner
application = scrapyd.app.application
launcher    = scrapyd.launcher.Launcher
webroot     = scrapyd.website.Root
node_name = localhost
[services]
schedule.json     = scrapyd.webservice.Schedule
cancel.json       = scrapyd.webservice.Cancel
addversion.json   = scrapyd.webservice.AddVersion
listprojects.json = scrapyd.webservice.ListProjects
listversions.json = scrapyd.webservice.ListVersions
listspiders.json  = scrapyd.webservice.ListSpiders
delproject.json   = scrapyd.webservice.DeleteProject
delversion.json   = scrapyd.webservice.DeleteVersion
listjobs.json     = scrapyd.webservice.ListJobs
daemonstatus.json = scrapyd.webservice.DaemonStatus
改一些认识的参数就行,不认识的等需要的时候再查也行。不过不要随意的将公网的服务器的绑定IP改成0.0.0.0,这存在很大的隐患,有心者完全可以通过scrapyd的api做很多事。要在公网服务器使用的话需要用Nginx做反向代理添加验证信息。
刷新列表状态
只是向所有主机发起请求更新状态和节点名两栏,看第一张图应该很好理解
同步所有项目到所有主机
顾名思义。默认版本号(version)为当前时间戳
查看任务队列
发服务端请求listjobs这个接口,返回scrapyd服务端当前pending(待抓取)、running(正抓取)、finished(已抓取)的相关信息
删除主机
顾名思义
项目管理界面
项目管理主要是读取当前exe文件同级目录下projects目录内的文件夹,有点绕口大概就这意思吧。右键有三个功能:刷新项目列表、同步所有项目到、同步到(需要右键某个项目)
创建任务界面
右键有两个功能:创建任务、取消任务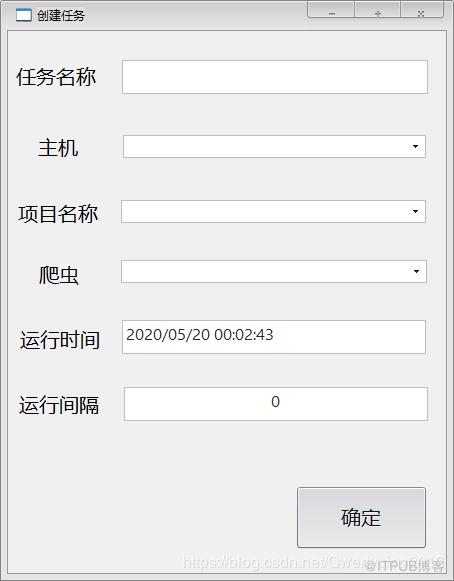 注意这里需要一级一级填写,软件步骤如下:选择主机->软件请求服务端返回该主机下的所有项目->选择项目->软件请求服务端返回该项目下的所有爬虫
运行时间可以是如图的字符串格式,表示在指定时间运行;也可以是数字(单位秒),在指定秒数之后运行。时间间隔表示是否重复运行爬虫,重复时间间隔,只支持数字(单位秒),比如一天运行一次就填86400。
因为需要等服务器返回数据,即使用多线程也要等返回值,所以选择主机或者项目后会有卡顿,卡顿时间看服务器返回数据的延迟,本地的话很快。
如果需要什么其他功能的话可以自行开发,源码已经有了,二次开发应该不难,aardio语法和JavaScript类似,我也接触没多久。不过因为交流社区被开发者关闭了,所以这个语言基本也就是开发者自己在查bug了,而且有时候找个功能都要翻遍论坛和文档,没有时间和耐心不建议使用。
原文作者:Python成长路;如有侵权,请联系管理员删除。

