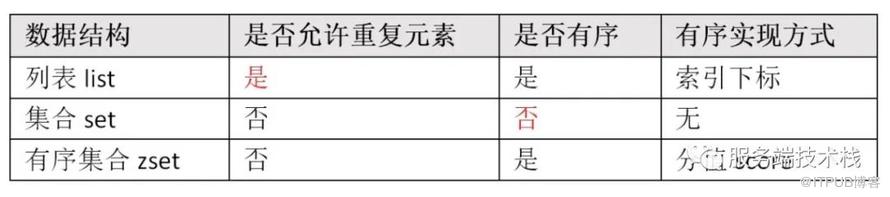
zset是一种可以用来排序功能的有序集合,每个元素有一个浮点型的score属性,根据score来从小到大排序,score相同时,按照key的ascii码排序` 。
和其他数据结构比较
一、基本使用

ZADD key [NX|XX] [CH] [INCR] score member [score member ...]1、zadd插入元素到有序集合语法
2、key有序集合名
3、NX-元素不存在时才设置成功,XX-元素存在时才设置成功
4、CH 修改返回值=添加的新元素和修改的元素之和
5、INCR 修改新的score为原score加上新指定的score值
6、score 新元素的分数值
7、新元素名称
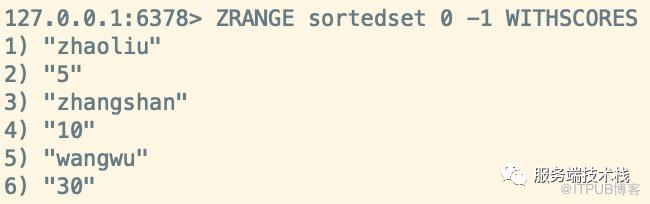
ZRANGE key start stop [WITHSCORES]1、ZRANGE 按范围查找有序集合中元素,支持返回元素的分数
2、key是需要查找的有序集合
3、start 开始坐标,0-代表第1个元素,依次内推,-1-代表最后一个元素
4、WITHSCORES 是否返回分值
二、存储类型
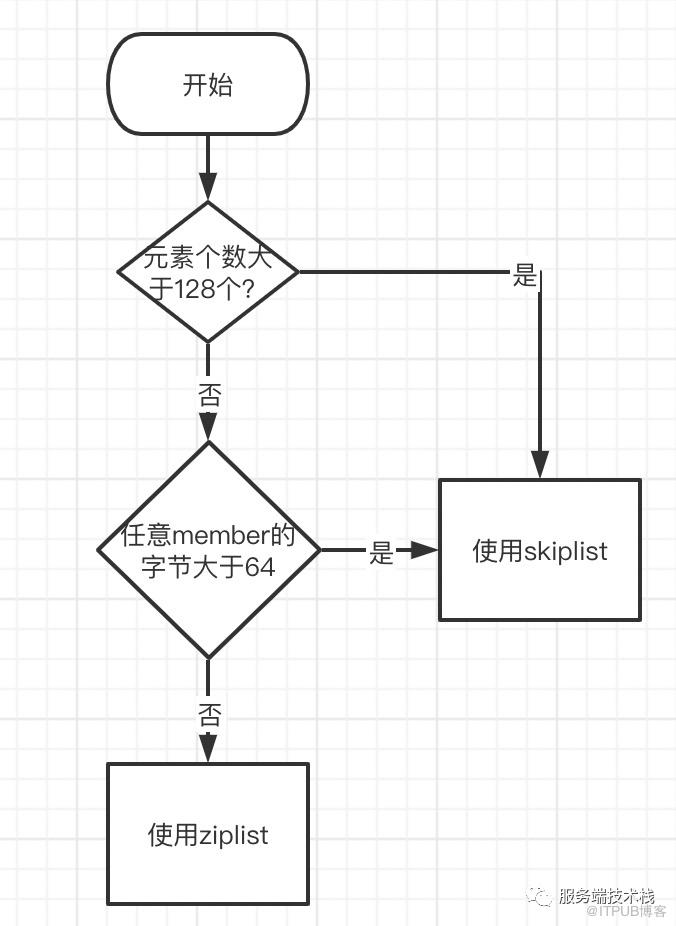
和hash类型一样,zset也使用两种编码:ziplist和skiplist(跳表)。
在redis.conf中,通过下面的配置条件来切换存储类型
zset-max-ziplist-entries 128zset-max-ziplist-value 64
在源码中,新增一个元素时候,如果不存在有序集合,会根据配置创建不同存储类型的zset。
// 新增元素命令 根据配置创建不同编码的zsetvoid zaddGenericCommand(client *c, int flags) {.../* Lookup the key and create the sorted set if does not exist. */zobj = lookupKeyWrite(c->db,key);if (zobj == NULL) {if (xx) goto reply_to_client; /* No key + XX option: nothing to do. */if (server.zset_max_ziplist_entries == 0 ||server.zset_max_ziplist_value < sdslen(c->argv[scoreidx+1]->ptr)){//如果满足配置的ziplist阈值,使用ziplist编码zobj = createZsetObject();} else {// 使用skiplistzobj = createZsetZiplistObject();}dbAdd(c->db,key,zobj);} else {if (zobj->type != OBJ_ZSET) {addReply(c,shared.wrongtypeerr);goto cleanup;}}...}
ziplist结构在上文中,已经分析过,本文就不再分析了,本文将重点分析skiplist
三、跳表分析
redis跳表的特点:
1、用c语言翻译实现了`William Pugh`的平衡树的概率替代方案算法。
2、支持重复的score成员
3、支持分数排序,也支持数据排序
4、有一个后向指针,所以它是一个双向链表,后向指针仅在“级别 1”。这允许从尾到头遍历列表,对ZREVRANGE很有用
四、跳表结构定义
/* 跳表节点定义 ZSETs use a specialized version of Skiplists */typedef struct zskiplistNode {//元素内容 字符串类型sds ele;//分数double score;//后继指针,用于从后向前查找数据struct zskiplistNode *backward;struct zskiplistLevel {//前驱指针,用于向前面查找数据struct zskiplistNode *forward;//元素跨度unsigned long span;} level[];} zskiplistNode;typedef struct zskiplist {struct zskiplistNode *header, *tail;//大小unsigned long length;//总层数int level;} zskiplist;typedef struct zset {//字典dict *dict;//跳表zskiplist *zsl;} zset;
总结:跳表是一个链表,每个节点上有一个层级数组,每一层的节点都保存下一个节点的指针。
五、skiplist新增方法源码分析
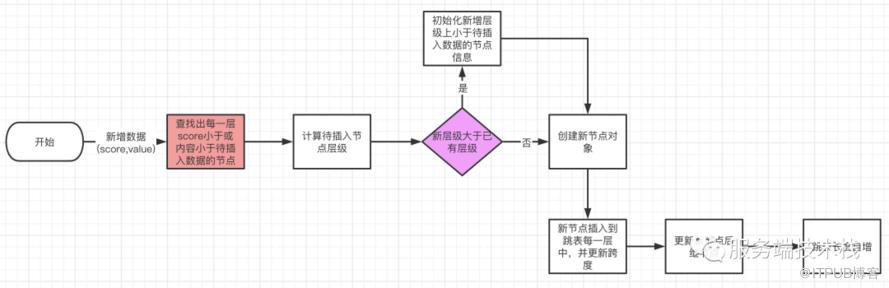
//插入一个节点zskiplistNode *zslInsert(zskiplist *zsl, double score, sds ele) {/* update保存每一层插入位置的前一个节点 */zskiplistNode *update[ZSKIPLIST_MAXLEVEL], *x;unsigned int rank[ZSKIPLIST_MAXLEVEL];int i, level;serverAssert(!isnan(score));//zset头节点x = zsl->header;//从最大层开始遍历,寻找每一层插入位置的前一个节点for (i = zsl->level-1; i >= 0; i--) {//计算插入位置 最大层基础是0,其他是下一层作为基础/* store rank that is crossed to reach the insert position */rank[i] = i == (zsl->level-1) ? 0 : rank[i+1];//当前节点的分数小于插入元素分数,或者分数相等,内容小于插入元素内容(需要在这个节点前插入数据)while (x->level[i].forward &&(x->level[i].forward->score < score ||(x->level[i].forward->score == score &&sdscmp(x->level[i].forward->ele,ele) < 0))){// 累加当前节点跨越的节点数rank[i] += x->level[i].span;// 记录比现在当前节点小的节点x = x->level[i].forward;}update[i] = x;}/* we assume the element is not already inside, since we allow duplicated* scores, reinserting the same element should never happen since the* caller of zslInsert() should test in the hash table if the element is* already inside or not. *///计算新元素 的等级level = zslRandomLevel();//新元素等级 比当前跳表等级 大if (level > zsl->level) {//初始化新等级和老等级之间的每个等级 插入位置前一个节点数据for (i = zsl->level; i < level; i++) {//初始化 插入位置前一个节点 是第1个节点rank[i] = 0;//初始化 插入位置前一个节 为头节点update[i] = zsl->header;//初始化 插入位置前一个节点 跨越的节点数 为跳表长度update[i]->level[i].span = zsl->length;}zsl->level = level;}//创建一个新节点x = zslCreateNode(level,score,ele);//遍历每一层 根据之前算好的前一个位置 将新节点插入到每层的位置for (i = 0; i < level; i++) {//更新新节点下一个节点x->level[i].forward = update[i]->level[i].forward;//新节点插入 链接update[i]->level[i].forward = x;//更新跨度/* update span covered by update[i] as x is inserted here */x->level[i].span = update[i]->level[i].span - (rank[0] - rank[i]);update[i]->level[i].span = (rank[0] - rank[i]) + 1;}/* increment span for untouched levels */for (i = level; i < zsl->level; i++) {update[i]->level[i].span++;}//修改新的节点的前驱节点x->backward = (update[0] == zsl->header) ? NULL : update[0];if (x->level[0].forward)x->level[0].forward->backward = x;else//新节点属于尾节点zsl->tail = x;//长度增加zsl->length++;return x;}//随机计算新层级int zslRandomLevel(void) {int level = 1;// 随机数 < 65535*0.25(百分之25概率要加1个层级) 层级自增1while ((random()&0xFFFF) < (ZSKIPLIST_P * 0xFFFF))level += 1;return (level<ZSKIPLIST_MAXLEVEL) ? level : ZSKIPLIST_MAXLEVEL;}
整体流程入下图:
原文作者:服务端技术栈;如有侵权,请联系管理员删除。

