前言
上文已经分析到LoadBalancerFC最终会通过Ribbon中的Rule对象选择一个服务进行发起通信,但是没有详细分析Rule的选择服务流程,本文将继续详细分析。本文内容是OpenFeign集成Ribbon负载均衡的核心实现部分。
先回顾上文讲到的选择服务方法,位于com.netflix.loadbalancer.reactive.LoadBalancerCommand#selectServer 方法
private Observable<Server> selectServer() {return Observable.create(new OnSubscribe<Server>() {public void call(Subscriber<? super Server> next) {try {//通过loadBalancerContext选择出服务Server server = loadBalancerContext.getServerFromLoadBalancer(loadBalancerURI, loadBalancerKey);next.onNext(server);next.onCompleted();} catch (Exception e) {next.onError(e);}}});}
loadBalancerContext负责根据loadBalancer对象选择服务,而loadBalancer对象最终是通过Rule对象来获取服务的。
public Server getServerFromLoadBalancer( URI original, Object loadBalancerKey) throws ClientException {String host = null;int port = -1;//...ILoadBalancer lb = getLoadBalancer();//通过负载均衡获取服务Server svc = lb.chooseServer(loadBalancerKey);logger.debug("{} using LB returned Server: {} for request {}", new Object[]{clientName, svc, original});return svc;}
loadBalancerContext负责根据LoadBalancer对象选择服务,而loadBalancer对象最终是通过Rule对象来获取服务的。
那么ILoadBalancer对象和Rule对象是如何初始化的呢?
LoadBalancer和Rule初始化
我们可以看到Ribbon的自动装配类RibbonClientConfiguration,找到LoadBalancer和Rule的默认配置类。
public class RibbonClientConfiguration {public ILoadBalancer ribbonLoadBalancer(IClientConfig config, ServerList<Server> serverList, ServerListFilter<Server> serverListFilter, IRule rule, IPing ping, ServerListUpdater serverListUpdater) {//初始化LoadBalancer对象为ZoneAwareLoadBalancerreturn (ILoadBalancer)(this.propertiesFactory.isSet(ILoadBalancer.class, this.name) ? (ILoadBalancer)this.propertiesFactory.get(ILoadBalancer.class, config, this.name): new ZoneAwareLoadBalancer(config, rule, ping, serverList, serverListFilter, serverListUpdater));}public IRule ribbonRule(IClientConfig config) {if (this.propertiesFactory.isSet(IRule.class, this.name)) {return (IRule)this.propertiesFactory.get(IRule.class, config, this.name);} else {//初始化Rule对象为ZoneAvoidanceRuleZoneAvoidanceRule rule = new ZoneAvoidanceRule();rule.initWithNiwsConfig(config);return rule;}}}
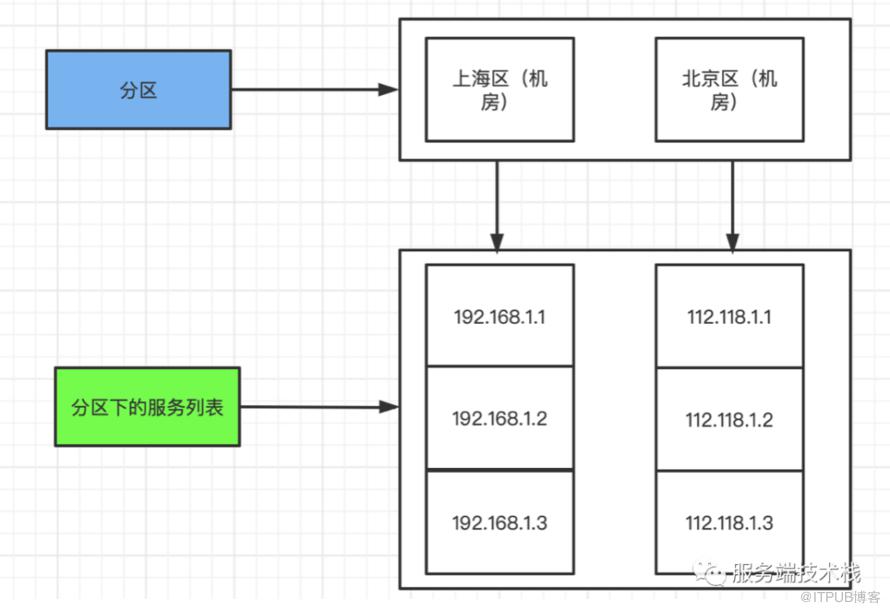
ZoneAwareLoadBalancer,Rule类默认配置的是ZoneAvoidanceRule,他们都使用了条件注解@ConditionalOnMissingBean,也就是我们如果有自定义的负载规则可以覆盖这两个默认配置。loadbalancer和Rule都是以Zone开头,Zone是区域的意思,也就是说他们能够按照区域实现负载均衡,这种Rule是代表按区域负载均衡的机制,一般在大型互联网公司都会有多个机房,这种情况下就存在按区域负载的必要性了。
如下图一样,一个公司的服务会分区部署,不同的区的服务器资源都有可能不一样
package com.netflix.loadbalancer;public class Server {private String host;private int port = 80;//服务所属区域private String zone ;private String scheme;private volatile String id;private volatile boolean isAliveFlag;}
public Server chooseServer(Object key) {//1、按区域负载没有开启if (!ENABLED.get() || getLoadBalancerStats().getAvailableZones().size() <= 1) {logger.debug("Zone aware logic disabled or there is only one zone");return super.chooseServer(key);}Server server = null;try {//2、获取有所分区快照LoadBalancerStats lbStats = getLoadBalancerStats();Map<String, ZoneSnapshot> zoneSnapshot = ZoneAvoidanceRule.createSnapshot(lbStats);logger.debug("Zone snapshots: {}", zoneSnapshot);//3、计算哪些是可用的分区Set<String> availableZones = ZoneAvoidanceRule.getAvailableZones(zoneSnapshot, triggeringLoad.get(), triggeringBlackoutPercentage.get());logger.debug("Available zones: {}", availableZones);//4、这里是可用分区小于总分区数的时候(说明当前存在有区域不可用的情况),从可用分区选择一个分区,如果所有区域都可用,可以不走区域负载逻辑if (availableZones != null && availableZones.size() < zoneSnapshot.keySet().size()) {//5、随机选择一个分区String zone = ZoneAvoidanceRule.randomChooseZone(zoneSnapshot, availableZones);logger.debug("Zone chosen: {}", zone);if (zone != null) {BaseLoadBalancer zoneLoadBalancer = getLoadBalancer(zone);//6、从可用区选择一个具体的服务server = zoneLoadBalancer.chooseServer(key);}}} catch (Exception e) {logger.error("Error choosing server using zone aware logic for load balancer={}", name, e);}if (server != null) {//7、通过区域负载获取到了可用服务,直接返回return server;} else {//8、不使用按区域负载logger.debug("Zone avoidance logic is not invoked.");return super.chooseServer(key);}}
public ZoneSnapshot getZoneSnapshot(List<? extends Server> servers) {if (servers == null || servers.size() == 0) {return new ZoneSnapshot();}int instanceCount = servers.size();int activeConnectionsCount = 0;int activeConnectionsCountOnAvailableServer = 0;int circuitBreakerTrippedCount = 0;double loadPerServer = 0;long currentTime = System.currentTimeMillis();for (Server server: servers) {ServerStats stat = getSingleServerStat(server);if (stat.isCircuitBreakerTripped(currentTime)) {circuitBreakerTrippedCount++;} else {activeConnectionsCountOnAvailableServer += stat.getActiveRequestsCount(currentTime);}activeConnectionsCount += stat.getActiveRequestsCount(currentTime);}if (circuitBreakerTrippedCount == instanceCount) {//服务全被熔断了if (instanceCount > 0) {// should be NaN, but may not be displayable on EpicloadPerServer = -1;}} else {//计算每个服务平均负载 活跃的请求线程数/(总服务-熔断服务)loadPerServer = ((double) activeConnectionsCountOnAvailableServer) / (instanceCount - circuitBreakerTrippedCount);}return new ZoneSnapshot(instanceCount, circuitBreakerTrippedCount, activeConnectionsCount, loadPerServer);}
第二步就是从所有分区里选出可用的分区了
public static Set<String> getAvailableZones(Map<String, ZoneSnapshot> snapshot, double triggeringLoad,double triggeringBlackoutPercentage) {if (snapshot.isEmpty()) {return null;}Set<String> availableZones = new HashSet<String>(snapshot.keySet());if (availableZones.size() == 1) {return availableZones;}Set<String> worstZones = new HashSet<String>();double maxLoadPerServer = 0;boolean limitedZoneAvailability = false;//循环分区,找到可用分区for (Map.Entry<String, ZoneSnapshot> zoneEntry : snapshot.entrySet()) {String zone = zoneEntry.getKey();ZoneSnapshot zoneSnapshot = zoneEntry.getValue();int instanceCount = zoneSnapshot.getInstanceCount();if (instanceCount == 0) {availableZones.remove(zone);limitedZoneAvailability = true;} else {double loadPerServer = zoneSnapshot.getLoadPerServer();//熔断的服务比例大于99%if (((double) zoneSnapshot.getCircuitTrippedCount())/ instanceCount >= triggeringBlackoutPercentage|| loadPerServer < 0) {//服务的平均负载小于0(服务全被熔断了,从可用分区剔除)availableZones.remove(zone);limitedZoneAvailability = true;} else {// 负载和最大负载相近 1/100000 记录为最差if (Math.abs(loadPerServer - maxLoadPerServer) < 0.000001d) {// they are the same considering double calculation// round error 记录最差的worstZones.add(zone);} else if (loadPerServer > maxLoadPerServer) {//负载比最大负载还大,重新记录最差maxLoadPerServer = loadPerServer;worstZones.clear();worstZones.add(zone);}}}}// 最大负载都小于0.2,说明服务可用性都还好,并且没有剔除任何区if (maxLoadPerServer < triggeringLoad && !limitedZoneAvailability) {// zone override is not needed herereturn availableZones;}//从最差的区里随机取一个String zoneToAvoid = randomChooseZone(snapshot, worstZones);//从可用区里移除最差的一个分区if (zoneToAvoid != null) {availableZones.remove(zoneToAvoid);}return availableZones;}
可以看到最后,最终是通过随机函数Random.nextInt()方法从可用分区里获取一个分区。代码比较冗长,但是逻辑是很清晰的,可以参考下方时序图

可用服务的选择|逻辑较复杂!!
上面分区选好了,下面就是从可用分区里选择可用服务了。
重要说明:说明选择服务的源码逻辑比上方选择分区逻辑复杂多了,不过多看几遍就好了
//获取loadbalancerBaseLoadBalancer zoneLoadBalancer = getLoadBalancer(zone);//获取服务server = zoneLoadBalancer.chooseServer(key);
getLoadBalancer这里运用了享元模式,每个分区都只会创建一次负载均衡器对象,创建好了就缓存起来,下次请求就使用缓存中的负载均衡对象了。
BaseLoadBalancer getLoadBalancer(String zone) {zone = zone.toLowerCase();//首先查缓存BaseLoadBalancer loadBalancer = balancers.get(zone);if (loadBalancer == null) {// We need to create rule object for load balancer for each zoneIRule rule = cloneRule(this.getRule());loadBalancer = new BaseLoadBalancer(this.getName() + "_" + zone, rule, this.getLoadBalancerStats());//1个分区一个loadBalancerBaseLoadBalancer prev = balancers.putIfAbsent(zone, loadBalancer);if (prev != null) {loadBalancer = prev;}}return loadBalancer;}
每个分区创建一个Rule,一个BaseLoadBalancer,服务选择是通过BaseLoadBalancer选择出来的。
继续跟进chooseServer方法可知,使用Rule对象选择服务
public Server chooseServer(Object key) {if (counter == null) {counter = createCounter();}counter.increment();if (rule == null) {return null;} else {try {return rule.choose(key);} catch (Exception e) {logger.warn("LoadBalancer [{}]: Error choosing server for key {}", name, key, e);return null;}}}
前文讲过自动装配类初始化Rule为ZoneAvoidanceRule类,它继承了PredicateBasedRule,而PredicateBasedRule最终使用AbstractServerPredicate进行服务抉择!
首先拿到所有的服务,这里所有服务是存储在BaseLoadBalancer
public class BaseLoadBalancer {//所有服务列表(name = PREFIX + "AllServerList", type = DataSourceType.INFORMATIONAL)protected volatile List<Server> allServerList = Collections.synchronizedList(new ArrayList<Server>());}
继续跟进AbstractServerPredicate我们终于看到了负载均衡的庐山真面目
public Optional<Server> chooseRoundRobinAfterFiltering(List<Server> servers, Object loadBalancerKey) {//获取所有可用服务列表List<Server> eligible = getEligibleServers(servers, loadBalancerKey);if (eligible.size() == 0) {return Optional.absent();}//轮训获取服务return Optional.of(eligible.get(incrementAndGetModulo(eligible.size())));}
执行完chooseRoundRobinAfterFiltering方法就拿到了最终选择的服务了,它通过轮训方式获取一个服务。
在getEligibleServers方法里通过Predicate服务决策器过滤,过滤出所有可用的服务列表。
在ZoneAvoidanceRule构造器里面,我们可以看到它默认使用两个决策器,进行过滤服务,一个是ZoneAvoidancePredicate,一个是AvailabilityPredicate,使用到组合器CompositePredicate将两者结合(组合设计模式)。
public ZoneAvoidanceRule() {super();ZoneAvoidancePredicate zonePredicate = new ZoneAvoidancePredicate(this);AvailabilityPredicate availabilityPredicate = new AvailabilityPredicate(this);compositePredicate = createCompositePredicate(zonePredicate, availabilityPredicate);}private CompositePredicate createCompositePredicate(ZoneAvoidancePredicate p1, AvailabilityPredicate p2) {return CompositePredicate.withPredicates(p1, p2).addFallbackPredicate(p2).addFallbackPredicate(AbstractServerPredicate.alwaysTrue()).build();}}
com.netflix.loadbalancer.ZoneAvoidancePredicate 负责匹配过滤满足区域可用的服务 com.netflix.loadbalancer.AvailabilityPredicate 负责匹配过滤满足可用性的服务
获取服务实现里面,并没有从最开始获取好的分区里面去找服务,而是再次实时获取全部服务,再通过区域过滤器,服务可用性过滤器,选择可用的服务。
这个原因到底是为什么呢? 可想而知,分区是否可用,服务是否可用这些都是一直在变化的,每次获取最新的服务信息才是更加可靠的!!
总结
好啦,上面就是今天的全部内容,我们从LoadBalancerFeignClient开始,介绍了openFeign集成Ribbon负载均衡能力,而Ribbon使用到LoadBalancer和Rule实现负载均衡,他默认使用按区域负载均衡的策略。分别使用ZoneAvoidanceRule和ZoneAwareLoadBalancer实现负载均衡核心逻辑。
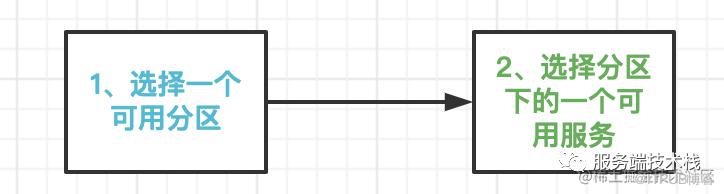
核心流程分两步:

到此OpenFeign集成负载均衡能力核心流程已经分析完了。
后面将继续分析OpenFeign的其他组件能力。
哈哈都看到这里了,关注我一起学习吧!!
原文作者:服务端技术栈;如有侵权,请联系管理员删除。

