数数国内的大模型,ChatGLM是一个知名度较高、也绕不过去的产品,源自清华系的团队,2022年11月,斯坦福大学大模型中心对全球30个主流大模型进行了全方位的评测,GLM-130B(ChatGLM 的技术底座) 是亚洲唯一入选的大模型。
https://chatglm.cn/ 官方访问地址
 目前尚在内测期,想体验需要提交内测申请,不过很快会被审核通过。
与ChatGPT的布局类似,左菜单右内容结构,ChatGLM 的训练数据截止到 2023 年,所以它不是一个能够获取实时数据的大语言模型。从官方的文字介绍来看,文案能力还可以,在面对许多事实性知识任务时,可能会生成不正确的信息;她也不擅长逻辑类问题的解答。
 如果你只是普通的文案应用,不妨将 ChatGLM 作为了一个备选项使用,毕竟 ChatGPT 的使用门槛现在还是挺高的。
局限和不足
ChatGLM-6B 具备了一定条件下较好的对话与问答能力,ChatGLM-6B 也有相当多已知的局限和不足,官方给出的提示如下:
模型容量较小:6B 的小容量,决定了其相对较弱的模型记忆和语言能力。在面对许多事实性知识任务时,ChatGLM-6B 可能会生成不正确的信息;她也不擅长逻辑类问题(如数学、编程)的解答。 可能会产生有害说明或有偏见的内容:ChatGLM-6B 只是一个初步与人类意图对齐的语言模型,可能会生成有害、有偏见的内容。 较弱的多轮对话能力:ChatGLM-6B 的上下文理解能力还不够充分,在面对长答案生成,以及多轮对话的场景时,可能会出现上下文丢失和理解错误的情况。 英文能力不足:训练时使用的指示大部分都是中文的,只有一小部分指示是英文的。因此在使用英文指示时,回复的质量可能不如中文指示的回复,甚至与中文指示下的回复矛盾。 易被误导:ChatGLM-6B 的“自我认知”可能存在问题,很容易被误导并产生错误的言论。例如当前版本模型在被误导的情况下,会在自我认知上发生偏差。即使该模型经过了1万亿标识符(token)左右的双语预训练,并且进行了指令微调和人类反馈强化学习(RLHF),但是因为模型容量较小,所以在某些指示下可能会产生有误导性的内容。
生态发展
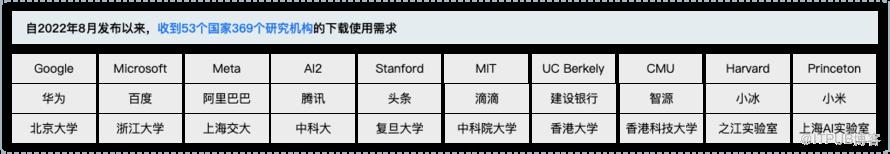 在学习和研究领域,ChatGLM-6B 作为一款开源产品,受欢迎程度还是比较高的。有很多模型或者基于ChatGLM的微调,不少基于或使用了 ChatGLM-6B 的开源项目,对 ChatGLM 进行加速的开源项目,还有一些支持 ChatGLM-6B 和相关应用在线训练的示例项目等等,对国内外大模型的发展还是能起到一些推动作用。
手动部署演示
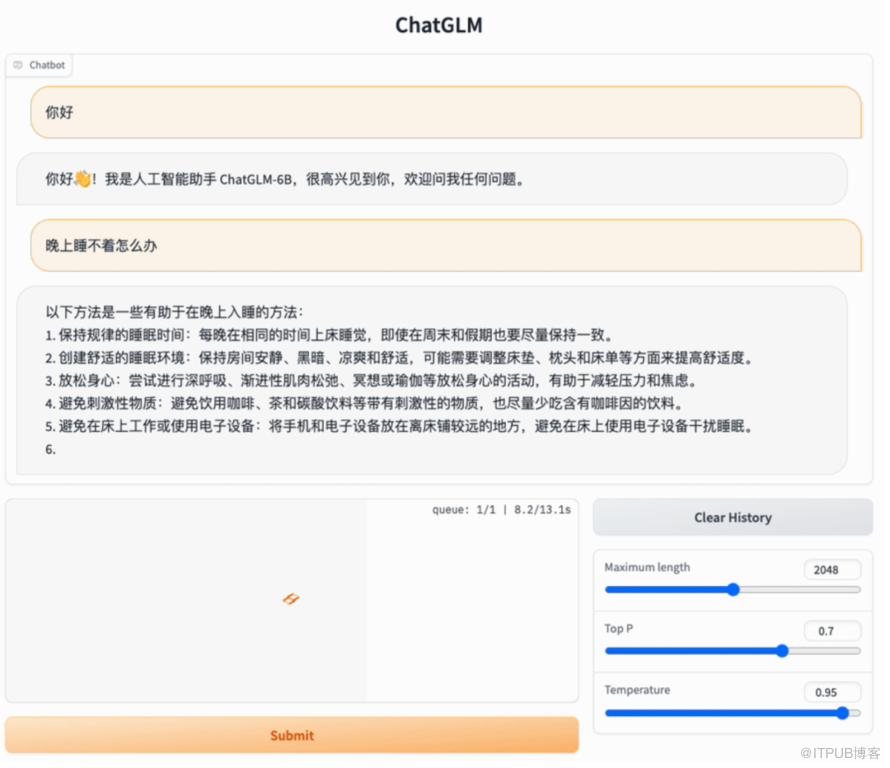
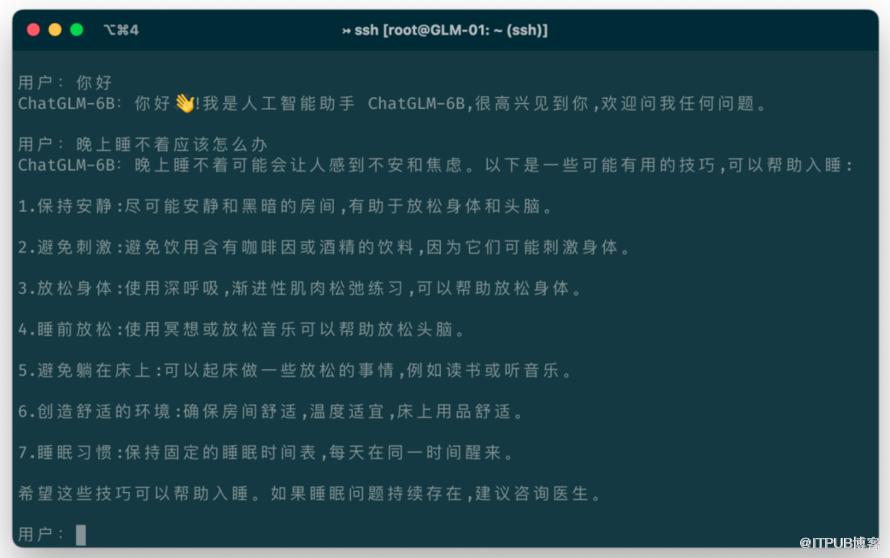
如果你的动手能力比较强的话,ChatGLM 提供了一个基于 Gradio 的网页版 Demo 和一个命令行 Demo,普通用户访问官方的网站使用即可。
https://github.com/THUDM/ChatGLM-6B 官方仓库地址
原文作者:MavenTalk;如有侵权,请联系管理员删除。

