知道这50个正则表达式,能让你少写1,000行代码
重磅干货,第一时间送达 每日干货
每日分享,获取代更多学习资料、视频、电子书,在“程序员Style”微信公众号后台回复文字“666”即可!
阅读本文约需要12分钟
正则表达式,一个十分古老而又强大的文本处理工具,仅仅用一段非常简短的表达式语句,便能够快速实现一个非常复杂的业务逻辑。熟练地掌握正则表达式的话,能够使你的开发效率得到极大的提升。
一、正则表达式语法
正则表达式包括普通字符(例如字符 a 到 z)、非打印字符(例如\n)、特殊字符(称为"元字符")、限定符(例如{n,m})和定位符(例如^)。
1.1 普通字符
普通字符包括所有大写和小写字母、所有数字、所有标点符号和一些其他符号。
1.2 非打印字符
非打印字符也可以是正则表达式的组成部分。下表列出了表示非打印字符的转义序列:
字符 描述 \n 匹配一个换行符。等价于 \x0a 和 \cJ。 \r 匹配一个回车符。等价于 \x0d 和 \cM。 \s 匹配任何空白字符,包括空格、制表符、换页符等等。等价于 [ \f\n\r\t\v]。 \S 匹配任何非空白字符。等价于 [^ \f\n\r\t\v]。 \t 匹配一个制表符。等价于 \x09 和 \cI。 \v 匹配一个垂直制表符。等价于 \x0b 和 \cK。
1.3 特殊字符
所谓特殊字符,就是一些有特殊含义的字符,在试图匹配它们时要特别对待。若要匹配这些特殊字符,必须首先使字符"转义",即,将反斜杠字符\ 放在它们前面。下表列出了正则表达式中的特殊字符:
特别字符 描述 $ 匹配输入字符串的结尾位置。如果设置了 RegExp 对象的 Multiline 属性,则 $ 也匹配 '\n' 或 '\r'。要匹配 $ 字符本身,请使用 \$。 ( ) 标记一个子表达式的开始和结束位置。子表达式可以获取供以后使用。要匹配这些字符,请使用 ( 和 )。 * 匹配前面的子表达式零次或多次。要匹配 * 字符,请使用 \*。 + 匹配前面的子表达式一次或多次。要匹配 + 字符,请使用 \+。 . 匹配除换行符 \n 之外的任何单字符。要匹配 . ,请使用 \. 。 [ 标记一个中括号表达式的开始。要匹配 [,请使用 \[。 ? 匹配前面的子表达式零次或一次,或指明一个非贪婪限定符。要匹配 ? 字符,请使用 \?。 \ 将下一个字符标记为或特殊字符、或原义字符、或向后引用、或八进制转义符。例如, 'n' 匹配字符 'n'。'\n' 匹配换行符。序列 '\' 匹配 "",而 '(' 则匹配 "("。 ^ 匹配输入字符串的开始位置,除非在方括号表达式中使用,此时它表示不接受该字符集合。要匹配 ^ 字符本身,请使用 \^。 { 标记限定符表达式的开始。要匹配 {,请使用 \{。 | 指明两项之间的一个选择。要匹配 |,请使用 \ (?:pattern) 匹配 pattern 但不获取匹配结果,也就是说这是一个非获取匹配,不进行存储供以后使用。这在使用 "或" 字符 (|) 来组合一个模式的各个部分是很有用。例如, 'industr(?:y|ies) 就是一个比 'industry|industries' 更简略的表达式。 (?=pattern) 正向肯定预查,在任何匹配pattern的字符串开始处匹配查找字符串。这是一个非获取匹配,也就是说,该匹配不需要获取供以后使用。例如,"Windows(?=2000)"能匹配"Windows2000"中的"Windows",但不能匹配"Windows3.1"中的"Windows"。 (?!pattern) 正向否定预查,在任何不匹配pattern的字符串开始处匹配查找字符串。这是一个非获取匹配,也就是说,该匹配不需要获取供以后使用。例如"Windows(?2000)"能匹配"Windows3.1"中的"Windows",但不能匹配"Windows2000"中的"Windows"。 (?<=pattern) 反向肯定预查,与正向肯定预查类似,只是方向相反。例如," (?<=2000)Windows"能匹配"2000Windows"中的"Windows",但不能匹配"3.1Windows"中的"Windows"。(?<!pattern) 反向否定预查,与正向否定预查类似,只是方向相反。例如" (?<!2000)Windows"能匹配"3.1Windows"中的"Windows",但不能匹配"2000Windows"中的"Windows"。
1.4 限定符
限定符用来指定正则表达式的一个给定组件必须要出现多少次才能满足匹配。有 ***** 或 + 或 ? 或 {n} 或 {n,} 或 {n,m} 共6种。正则表达式的限定符有:
字符 描述 * 匹配前面的子表达式零次或多次。例如,zo* 能匹配 "z" 以及 "zoo"。* 等价于{0,}。 + 匹配前面的子表达式一次或多次。例如,'zo+' 能匹配 "zo" 以及 "zoo",但不能匹配 "z"。+ 等价于 {1,}。 ? 匹配前面的子表达式零次或一次。例如,"do(es)?" 可以匹配 "do" 、 "does" 中的 "does" 、 "doxy" 中的 "do" 。? 等价于 {0,1}。 {n} n 是一个非负整数。匹配确定的 n 次。例如,'o{2}' 不能匹配 "Bob" 中的 'o',但是能匹配 "food" 中的两个 o。 {n,} n 是一个非负整数。至少匹配n 次。例如,'o{2,}' 不能匹配 "Bob" 中的 'o',但能匹配 "foooood" 中的所有 o。'o{1,}' 等价于 'o+'。'o{0,}' 则等价于 'o*'。 {n,m} m 和 n 均为非负整数,其中n <= m。最少匹配 n 次且最多匹配 m 次。例如,"o{1,3}" 将匹配 "fooooood" 中的前三个 o。'o{0,1}' 等价于 'o?'。请注意在逗号和两个数之间不能有空格。
1.5 定位符
定位符用来描述字符串或单词的边界,^ 和 $ 分别指字符串的开始与结束,\b 描述单词的前或后边界,\B 表示非单词边界。正则表达式的定位符有:
字符 描述 ^ 匹配输入字符串开始的位置。如果设置了 RegExp 对象的 Multiline 属性,^ 还会与 \n 或 \r 之后的位置匹配。 $ 匹配输入字符串结尾的位置。如果设置了 RegExp 对象的 Multiline 属性,$ 还会与 \n 或 \r 之前的位置匹配。 \b 匹配一个单词边界,即字与空格间的位置。 \B 非单词边界匹配。 二、常用正则表达式
正则表达式经常被用于字段或任意字符串的校验,如下面这段校验基本日期格式的JavaScript代码:
var reg = /^(\\d{1,4})(-|\\/)(\\d{1,2})\\2(\\d{1,2})$/;var r = fieldValue.match(reg);if(r==null)alert('Date format error!');
下面是小编整理的,在前端开发中经常使用到的20个正则表达式。
1 . 校验密码强度
密码的强度必须是包含大小写字母和数字的组合,不能使用特殊字符,长度在8-10之间。
^(?=.*\\d)(?=.*[a-z])(?=.*[A-Z]).{8,10}$
2. 校验中文
字符串仅能是中文。
^[\\u4e00-\\u9fa5]{0,}$
3. 由数字、26个英文字母或下划线组成的字符串
^\\w+$
4. 校验E-Mail 地址
同密码一样,下面是E-mail地址合规性的正则检查语句。
[\\w!#$%&'*+/=?^_`{|}~-]+(?:\\.[\\w!#$%&'*+/=?^_`{|}~-]+)*@(?:[\\w](?:[\\w-]*[\\w])?\\.)+[\\w](?:[\\w-]*[\\w])?
5. 校验身份证号码
下面是身份证号码的正则校验。15 或 18位。
15位:
^[1-9]\\d{7}((0\\d)|(1[0-2]))(([0|1|2]\\d)|3[0-1])\\d{3}$18位:
^[1-9]\\d{5}[1-9]\\d{3}((0\\d)|(1[0-2]))(([0|1|2]\\d)|3[0-1])\\d{3}([0-9]|X)$6. 校验日期“yyyy-mm-dd“ 格式的日期校验,已考虑平闰年。
^(?:(?!0000)[0-9]{4}-(?:(?:0[1-9]|1[0-2])-(?:0[1-9]|1[0-9]|2[0-8])|(?:0[13-9]|1[0-2])-(?:29|30)|(?:0[13578]|1[02])-31)|(?:[0-9]{2}(?:0[48]|[2468][048]|[13579][26])|(?:0[48]|[2468][048]|[13579][26])00)-02-29)$
7. 校验金额
金额校验,精确到2位小数。
^[0-9]+(.[0-9]{2})?$
8. 校验手机号
下面是国内 13、15、18开头的手机号正则表达式。(可根据目前国内收集号扩展前两位开头号码)
^(13[0-9]|14[5|7]|15[0|1|2|3|5|6|7|8|9]|18[0|1|2|3|5|6|7|8|9])\\d{8}$
9. 判断IE的版本
IE目前还没被完全取代,很多页面还是需要做版本兼容,下面是IE版本检查的表达式。
^.*MSIE [5-8](?:\\.[0-9]+)?(?!.*Trident\\/[5-9]\\.0).*$
10. 校验IP-v4地址
IP4 正则语句。
\\b(?:(?:25[0-5]|2[0-4][0-9]|[01]?[0-9][0-9]?)\\.){3}(?:25[0-5]|2[0-4][0-9]|[01]?[0-9][0-9]?)\\b
11. 校验IP-v6地址
IP6 正则语句。
(([0-9a-fA-F]{1,4}:){7,7}[0-9a-fA-F]{1,4}|([0-9a-fA-F]{1,4}:){1,7}:|([0-9a-fA-F]{1,4}:){1,6}:[0-9a-fA-F]{1,4}|([0-9a-fA-F]{1,4}:){1,5}(:[0-9a-fA-F]{1,4}){1,2}|([0-9a-fA-F]{1,4}:){1,4}(:[0-9a-fA-F]{1,4}){1,3}|([0-9a-fA-F]{1,4}:){1,3}(:[0-9a-fA-F]{1,4}){1,4}|([0-9a-fA-F]{1,4}:){1,2}(:[0-9a-fA-F]{1,4}){1,5}|[0-9a-fA-F]{1,4}:((:[0-9a-fA-F]{1,4}){1,6})|:((:[0-9a-fA-F]{1,4}){1,7}|:)|fe80:(:[0-9a-fA-F]{0,4}){0,4}%[0-9a-zA-Z]{1,}|::(ffff(:0{1,4}){0,1}:){0,1}((25[0-5]|(2[0-4]|1{0,1}[0-9]){0,1}[0-9])\\.){3,3}(25[0-5]|(2[0-4]|1{0,1}[0-9]){0,1}[0-9])|([0-9a-fA-F]{1,4}:){1,4}:((25[0-5]|(2[0-4]|1{0,1}[0-9]){0,1}[0-9])\\.){3,3}(25[0-5]|(2[0-4]|1{0,1}[0-9]){0,1}[0-9]))
12. 检查URL的前缀
应用开发中很多时候需要区分请求是HTTPS还是HTTP,通过下面的表达式可以取出一个url的前缀然后再逻辑判断。
if (!s.match(/^[a-zA-Z]+:\\/\\//)){s = 'http://' + s;}
13. 提取URL链接
下面的这个表达式可以筛选出一段文本中的URL。
^(f|ht){1}(tp|tps):\\/\\/([\\w-]+\\.)+[\\w-]+(\\/[\\w- ./?%&=]*)?
14. 文件路径及扩展名校验
验证windows下文件路径和扩展名(下面的例子中为.txt文件)
^([a-zA-Z]\\:|\\\\)\\\\([^\\\\]+\\\\)*[^\\/:*?"<>|]+\\.txt(l)?$
15. 提取Color Hex Codes
有时需要抽取网页中的颜色代码,可以使用下面的表达式。
^#([A-Fa-f0-9]{6}|[A-Fa-f0-9]{3})$
16. 提取网页图片
假若你想提取网页中所有图片信息,可以利用下面的表达式。
\\< *[img][^\\\\>]*[src] *= *[\\"\\']{0,1}([^\\"\\'\\ >]*)
17. 提取页面超链接提取html中的超链接。
(<a\\s*(?!.*\\brel=)[^>]*)(href="https?:\\/\\/)((?!(?:(?:www\\.)?'.implode('|(?:www\\.)?', $follow_list).'))[^"]+)"((?!.*\\brel=)[^>]*)(?:[^>]*)>18. 查找CSS属性
通过下面的表达式,可以搜索到相匹配的CSS属性。
^\\s*[a-zA-Z\\-]+\\s*[:]{1}\\s[a-zA-Z0-9\\s.#]+[;]{1}
19. 抽取注释
如果你需要移除HMTL中的注释,可以使用如下的表达式。
<!--(.*?)-->
20. 匹配HTML标签
通过下面的表达式可以匹配出HTML中的标签属性。
<\\/?\\w+((\\s+\\w+(\\s*=\\s*(?:".*?"|'.*?'|[\\^'">\\s]+))?)+\\s*|\\s*)\\/?>
21. 非负整数
^\d+$
22. 正整数
^[0-9]*[1-9][0-9]*$
23.非正整数
^((-\d+)|(0+))$
24. 负整数
^-[0-9]*[1-9][0-9]*$
25. 整数
^-?\d+$
26. 非负浮点数
^\d+(\.\d+)?$
27. 正浮点数
^((0-9)+\.[0-9]*[1-9][0-9]*)|([0-9]*[1-9][0-9]*\.[0-9]+)|([0-9]*[1-9][0-9]*))$
28. 非正浮点数
^((-\d+\.\d+)?)|(0+(\.0+)?))$
29. 负浮点数
^(-((正浮点数正则式)))$
30. 英文字符串
^[A-Za-z]+$
31. 英文大写串
^[A-Z]+$
32. 英文小写串:
^[a-z]+$
33. 英文字符数字串
^[A-Za-z0-9]+$
34. 英数字加下划线串
^\w+$
36. 邮政编码
^[1-9]\d{5}$
37. 中文
^[\u0391-\uFFE5]+$
38. 电话号码
^((\d2,3)|(\d{3}\-))?(0\d2,3|0\d{2,3}-)?[1-9]\d{6,7}(\-\d{1,4})?$
39. 手机号码
^((\d2,3)|(\d{3}\-))?13\d{9}$
40. 双字节字符(包括汉字在内)
^\x00-\xff
41. 匹配首尾空格
(^\s*)|(\s*$)(像vbscript那样的trim函数)
42. 匹配HTML标记
<(.*)>.*<\/\1>|<(.*) \/>
43. 匹配空行
\n[\s| ]*\r
44. 提取信息中的网络链接
(h|H)(r|R)(e|E)(f|F) *= *('|")?(\w|\\|\/|\.)+('|"| *|>)?
45. 提取信息中的浮点数(即小数)
(-?\d*)\.?\d+
46. 提取信息中的任何数字
(-?\d*)(\.\d+)?
47. 腾讯QQ号
^[1-9]*[1-9][0-9]*$
48. 帐号(字母开头,允许5-16字节,允许字母数字下划线)
^[a-zA-Z][a-zA-Z0-9_]{4,15}$
49. 中文、英文、数字及下划线
^[\u4e00-\u9fa5_a-zA-Z0-9]+$
50. xml文件
^([a-zA-Z]+-?)+[a-zA-Z0-9]+\\.[x|X][m|M][l|L]$
三、学习更多正则表达式的相关语法
可以查看正则表达式 – 语法 | 菜鸟教程,里面对正则表达式进行了详解。可以用来快速查找相关语法。
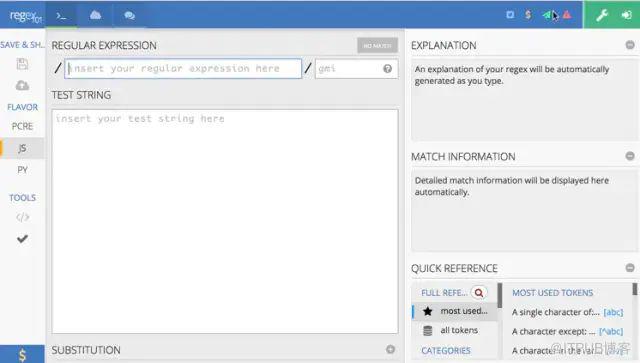
正则表达式在线测试工具
regex101是一个非常不错的正则表达式在线测试工具,你可以直接在线测试你的正则表达式哦。
今天小编先整理到这里,后续持续更新中...
感觉不错的话,麻烦动动小手关注一下小编啦




如有收获,点个【在看】
原文作者:程序员Style;如有侵权,请联系管理员删除。

