事务(Transaction)及其 ACID 属性
事务:由一组 SQL 语句组成的逻辑处理单元,事务具有以下四个属性,通常简称为事务的 ACID属性。
原子性(Atomicity):事务是一个原子操作单元,其对数据的修改,要么全部执行,要么全部不执行。
一致性(Consistent):事务必须使数据库从一个一致性状态变到另一个一致性状态。例如,一次转账的事务操作,要求A账户转出的钱,等于B账户转入的钱,实际上,一致性,是具体业务场景的约束
隔离性(Lsolation):数据库系统提供一定的隔离机制,保障事务在不受外部并发操作影响的“独立”环境执行。事务相互独立,互不干扰
持久性(Durable):事务完成之后,它对于数据的修改是永久性的,即使出现系统故障也能保持。
并发事务带来的问题
更新丢失
当两个或多个事务选择同一行,然后基于最初选定的值更新该行值,由于每个事务都不知道其他事务的存在,就会发生丢失更新问题,最后的更新覆盖来其他事务所做的更新
脏读
一个事务正在对一条记录做修改,在这个事务完成并提交前,这个条记录的数据就处于不一致的状态;这时另外一个事务也来读取同一条记录,如果不加控制,第二个事务读取来这些“脏”数据,并据此做进一步的处理,就会产生未提交的数据依赖关系。这种现象被形象的叫做“脏读”。
总结:事务A读取到来事务B已经修改但尚未提交的数据,还在这个数据基础上做来操作。此时,如果事务B回滚,事务A读取的数据无效,不符合一致性要求。
不可重复读
一个事务在读取某些数据后的某个时间,再次读取以前读过的数据,却发现其读出的数据已经发生来改变、或某些记录已经被删除了,这种现象就叫做“不可重复读”。
总结:事务A读取到了事务B已经提交的修改数据,不符合隔离性。
幻读
一个事务按相同的查询条件重新读取以前检索过的数据,却发现其他事务插入了满足其查询条件的新数据,这种现象就称为“幻读”。
总结:事务A读取到了事务B提交的新增数据,不符合隔离性。
原子性,持久性与一致性的实现
原子性,持久性和一致性主要是通过redo log、undo log、Force Log at Commit和Double Write机制来完成的。
redo log重做日志用于在崩溃时恢复数据
在事务提交之后,先去预写日志,保证持久化的落盘
undo log 用于对事务回滚时进行撤销,也会用于隔离性的多版本控制
Force Log at Commit 机制保证事务提交后redo log日志都已经持久化(由innodb_flush_log_at_trx_commit 控制)
Double Write 机制用来提高数据库的可靠性,用来解决脏页落盘时部分写失效问题
InnoDB事务整体流程分析
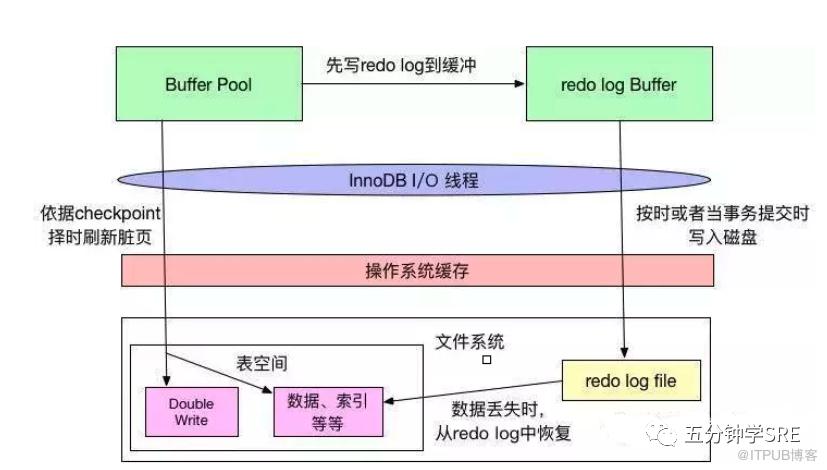
使用redo log实现事务的一致性与持久性
内存数据落盘的整体思路与分析
buffer pool存储数据页与索引页,事务提交后先写redo log Buffer,根据innodb_flush_log_at_trx_commit参数定时写入磁盘
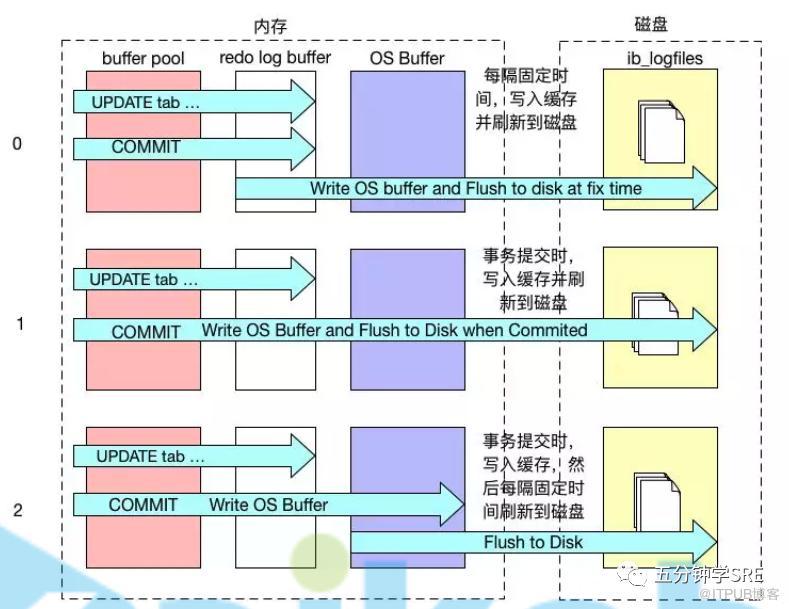
innodb_flush_log_at_trx_commit = 0 就是每秒调用 flush + fsync ,定时器自己维护。
innodb_flush_log_at_trx_commit = 1 就是实时调用 flush + fsync 没法批处理,性能很低。
innodb_flush_log_at_trx_commit = 2 就是实时flush ,定时 fsync 交给OS维护定时器。
checkPoint检查点机制
当数据库发生宕机时,数据库不需要重做所有的日志,因为Checkpoint之前的页都已经刷新回磁盘。数据库只需对Checkpoint后的重做日志进行恢复,这样就大大缩短了恢复的时间。
当缓冲池不够用时,根据LRU算法会溢出最近最少使用的页,若此页为脏页,那么需要强制执行 Checkpoint,将脏页也就是页的新版本刷回磁盘。
当重做日志出现不可用时,因为当前事务数据库系统对重做日志的设计都是循环使用的,并不是让 其无限增大的。重做日志可以被重用的部分是指这些重做日志已经不再需要,当数据库发生宕机 时,数据库恢复操作不需要这部分的重做日志,因此这部分就可以被覆盖重用。如果重做日志还需 要使用,那么必须强制Checkpoint,将缓冲池中的页至少刷新到当前重做日志的位置。
Double Write双写
如果说Insert Buffer给InnoDB存储引擎带来了性能上的提升,那么Double Write带给InnoDB存储 引擎的是数据页的可靠性。
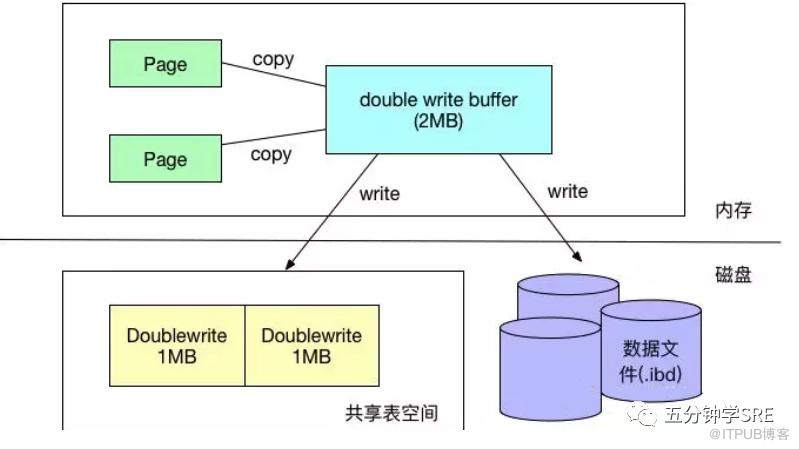
Double Write由两个部分组成,一部分是内存中的Double Write buffer,大小为2MB,另外一部分是物理磁盘上的共享表空间连续的128页,大小也为2MB。
在对缓冲池的脏页进行刷新时,并不直接写磁盘,而是通过memcpy函数将脏页先复制到内存中的 double write buffer区域,之后通过double write buffer再分两次,每次1MB顺序地写入共享表 空间的物理磁盘上,然后马上调用fsync函数,同步磁盘,避免操作系统缓冲写带来的问题。在完成 double write页的写入后,再讲double wirite buffer中的页写入各个表空间文件中。
如果操作系统在将页写入磁盘的过程中发生了崩溃,在恢复过程中,InnoDB存储引擎可以从共享表空间 中的double write中找到该页的一个副本,将其复制到表空间文件中,再应用重做日志。
事务的隔离级别
“脏读”、“不可重复读”、“幻读”,其实都是数据库读一致性问题,必须由数据库提供一定的事务隔离机制来解决
事务有隔离性(Isolation),并发事务间相互独立,互不干扰;几个要点:
基本目标:不同线程,发起并发事务,要实现不同线程操作数据时,不互相干扰;
相互干扰:脏读、不可重复读、幻读;
四个隔离级别
1. 未提交读 (READ UNCOMMITTED)
一个事务中对数据所做的修改,即使没有提交,这个修改对其他的事务仍是可见的,这种情况下就容易出现脏读,影响了数据的完整性
2. 读提交 (READ COMMITTED)
SELECT的时候无法重复读,即同一个事务中两次执行同样的查询语句,若在第一次与第二次查询之间时间段,其他事务又刚好修改了其查询的数据且提交了,则两次读到的数据不一致。
- 这种级别可以避免“脏数据”
- 这种隔离级别会导致“不可重复读取”
3. 可重复读 (REPEATABLE READ)
SELECT的时候可以重复读,即同一个事务中两次执行同样的查询语句,得到的数据始终都是一致的。实现的原理是,在一个事务对数据行执行读取或写入操作时锁定了这些数据行。
但是这种方式又引发了幻想读的问题。因为只能锁定读取或写入的行,不能阻止另一个事务插入数据,后期执行同样的查询会产生更多的结果。
- MySQL默认级别
4. 可串行 (SERIALIZABLE)
与可重复读的唯一区别是,默认把普通的SELECT语句改成SELECT …. LOCK IN SHARE MODE。即为查询语句涉及到的数据加上共享琐,阻塞其他事务修改真实数据。
serializable模式中,事务被强制为依次执行。这是SQL标准建议的默认行为。

数据库的事务隔离越严格,并发副作用越小,但付出的代价也就越大,因为事务隔离实质上就是使事务在一定程度上“串行化”进行,这显然与“并发”是矛盾的。
同时,不同应用对读一致性和事务隔离程度的要求也是不同的,比如许多应用对“不可重复读”和“幻读” 并不敏感,可能更关系数据并发访问的能力。
隔离级别的实现
SQL规范定义了以上四种隔离级别,但是并没有给出如何实现四种隔离级别,因此不同数据库的实现方式和使用方式也并不相同。而SQL隔离级别的标准是依据基于锁的实现方式来制定的
传统隔离级别的实现
传统的隔离级别是基于锁实现的,我们先来了解一下锁
传统的锁有两种:
共享锁(
Shared Locks):简称S锁,事务对一条记录进行读操作时,需要先获取该记录的共享锁。排他锁(
Exclusive Locks):简称X锁,事务对一条记录进行写操作时,需要先获取该记录的排他锁。
需要注意的是,加了共享锁的记录,其他事务也可以获得该记录的共享锁,但是无法获取该记录的排他锁,即S锁和S锁是兼容的,S锁和X锁是不兼容的;而加了排他锁的记录,其他事务既无法获取该记录的共享锁也无法获取排他锁,即X锁和X锁也是不兼容的。
事务对一条记录进行读操作时,需要先获取该记录的S锁,但有时事务在读取记录时需要阻止其他事务访问该记录,这时就需要获取该记录的X锁
读取时对记录加
S锁:
SELECT ... LOCK IN SHARE MODE;
如果事务执行了该语句,则会在读取的记录上加S锁,这样就允许其他事务也能获取到该记录的S锁;而如果其他事务需要获取该记录的X锁,那么就需要等待当前事务提交后释放掉S锁。
读取时对记录加
X锁:
SELECT ... FOR UPDATE;
如果事务执行了该语句,则会在读取的记录上加X锁,这样其他事务想要说去该记录的S锁或X锁,那么需要等待当前事务提交后释放掉X锁。
对于锁的粒度而言,锁又可以分为两种:
行锁:只锁住某一行记录,其他行的记录不受影响。
表锁:锁住整个表,所有对于该表的操作都会受影响。
MySQL隔离级别的实现(MVCC)
最早的数据库系统,只有读读之间可以并发,读写,写读,写写都要阻塞。引入多版本之后,只有写写之间相互阻塞,其他三种操作都可以并行,这样大幅度提高了InnoDB的并发度。在内部实现中,InnoDB是在undolog中实现的,通过undolog可以找回数据的历史版本。找回的数据历史版本可以提供给用户读(按照隔离级别的定义,有些读请求只能看到比较老的数据版本),也可以在回滚的时候覆盖数据页上的数据。在InnoDB内部中,会记录一个全局的活跃读写事务数组,其主要用来判断事务的可见性。
多版本并发控制(MVCC),来实现 MySQL 上的
多事务并发访问时,隔离级别控制;数据版本:并发事务执行时,同一行数据有多个版本
事务版本:每个事务都有一个事务版本
通过 MVCC 实现一种效果:
同一时刻,同一张表,多个并发事务,看到的数据是不同的
回滚段/undo log
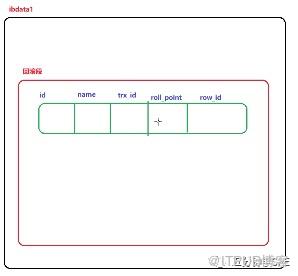
根据行为的不同,undo log分为两种:insert undo log和update undo log
insert undo log
是在 insert 操作中产生的 undo log
因为 insert 操作的记录只对事务本身可见,对于其它事务此记录是不可见的,所以 insert undo log 可以在事务提交后直接删除而不需要进行 purge 操作。
update undo log
是 update 或 delete 操作中产生的 undo log
因为会对已经存在的记录产生影响,为了提供 MVCC机制,因此 update undo log 不能在事务提交时 就进行删除,而是将事务提交时放到入 history list 上,等待 purge 线程进行最后的删除操作。
为了保证事务并发操作时,在写各自的undo log时不产生冲突,InnoDB采用回滚段的方式来维护undo log的并发写入和持久化。回滚段实际上是一种 Undo 文件组织方式。
版本链
对于使用InnoDB存储引擎的表来说,它的聚簇索引记录中都包含两个必要的隐藏列(row_id并不是必要的,我们创建的表中有主键或者非NULL唯一键时都不会包含row_id列):
trx_id:每次对某条聚簇索引记录进行改动时,都会把对应的事务id赋值给trx_id隐藏列。roll_pointer:每次对某条聚簇索引记录进行改动时,都会把旧的版本写入到undo日志中,然后这个隐藏列就相当于一个指针,可以通过它来找到该记录修改前的信息。
比方表t现在只包含一条记录:
CREATE TABLE t (id INT PRIMARY KEY,c VARCHAR(100)Engine=InnoDB CHARSET=utf8;SELECT * FROM t;+----+--------+id | c |+----+--------+1 | alex |+----+--------+1 row in set (0.01 sec)
假设插入该记录的事务id为80,那么此刻该条记录的示意图如下所示:
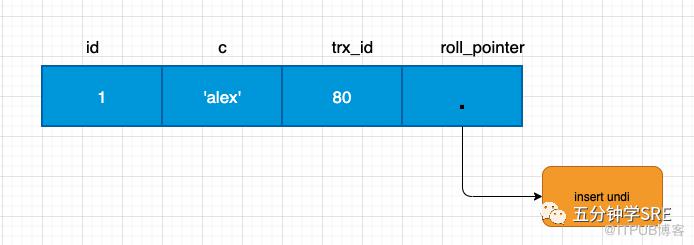
后面两个id分别为100、200的事务对这条记录进行UPDATE操作,操作流程如下:
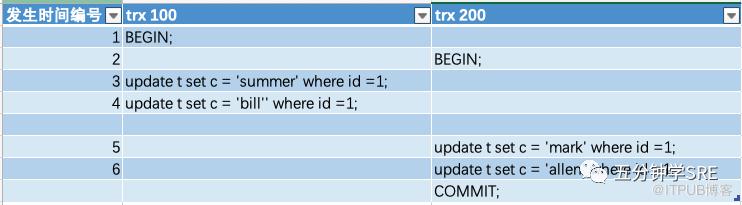
每次对记录进行改动,都会记录一条undo日志,每条undo日志也都有一个roll_pointer属性(INSERT操作对应的undo日志没有该属性,因为该记录并没有更早的版本),可以将这些undo日志都连起来,串成一个链表,所以现在的情况就像下图一样:
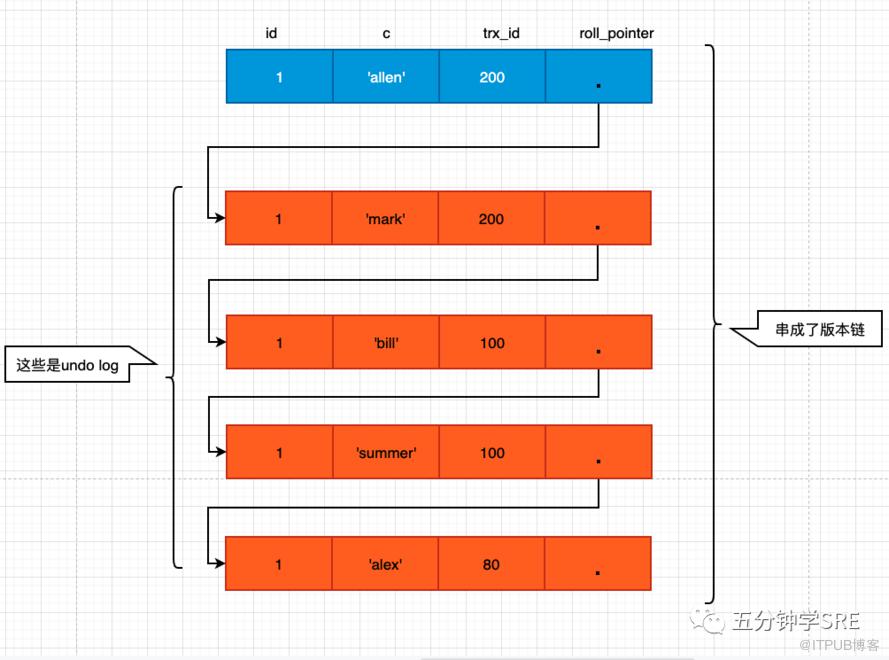
对该记录每次更新后,都会将旧值放到一条undo日志中,就算是该记录的一个旧版本,随着更新次数的增多,所有的版本都会被roll_pointer属性连接成一个链表,我们把这个链表称之为版本链,版本链的头节点就是当前记录最新的值。另外,每个版本中还包含生成该版本时对应的事务id
ReadView
对于使用
READ UNCOMMITTED隔离级别的事务来说,直接读取记录的最新版本就好了,对于使用SERIALIZABLE隔离级别的事务来说,使用加锁的方式来访问记录
使用READ COMMITTED和REPEATABLE READ隔离级别的事务,就需要用到我们上边所说的版本链了
核心问题就是:需要判断一下版本链中的哪个版本是当前事务可见的
所以设计InnoDB的设计者提出了一个ReadView的概念,这个ReadView中主要包含当前系统中还有哪些活跃的读写事务,把它们的事务id放到一个列表中,我们把这个列表命名为为m_ids。这样在访问某条记录时,只需要按照下边的步骤判断记录的某个版本是否可见:
如果被访问版本的
trx_id属性值小于m_ids列表中最小的事务id,表明生成该版本的事务在生成ReadView前已经提交,所以该版本可以被当前事务访问。如果被访问版本的
trx_id属性值大于m_ids列表中最大的事务id,表明生成该版本的事务在生成ReadView后才生成,所以该版本不可以被当前事务访问。如果被访问版本的
trx_id属性值在m_ids列表中最大的事务id和最小事务id之间,那就需要判断一下trx_id属性值是不是在m_ids列表中,如果在,说明创建ReadView时生成该版本的事务还是活跃的,该版本不可以被访问;如果不在,说明创建ReadView时生成该版本的事务已经被提交,该版本可以被访问。
tip:
在MySQL中,READ COMMITTED和REPEATABLE READ隔离级别的的一个非常大的区别就是它们生成ReadView的时机不同
1,READ COMMITTED --- 每次读取数据前都生成一个ReadView
2,REPEATABLE READ ---在第一次读取数据时生成一个ReadView
MVCC(Multi-Version Concurrency Control ,多版本并发控制)指的就是在使用READ COMMITTD、REPEATABLE READ这两种隔离级别的事务在执行普通的SEELCT操作时访问记录的版本链的过程,这样子可以使不同事务的读-写、写-读操作并发执行,从而提升系统性能。READ COMMITTD、REPEATABLE READ这两个隔离级别的一个很大不同就是生成ReadView的时机不同,READ COMMITTD在每一次进行普通SELECT操作前都会生成一个ReadView,而REPEATABLE READ只在第一次进行普通SELECT操作前生成一个ReadView,之后的查询操作都重复这个ReadView就好了。
原文作者:五分钟学SRE;如有侵权,请联系管理员删除。

