缓冲区的本质
缓冲区的本质
缓冲通过对数据进行暂存,然后批量进行传输或者操作,多采用顺序方法,来缓解不同设备之间次数频繁但速度缓慢的随机读写。
文件读写流
I/O流设计,采用的是装饰者模式。
在读写和写入流的API中,BufferedInputStream和BufferedRead可以加快读取字符串的速度,BufferedOutputStream和BufferedWriter可以加快写入的速度。
那直接读写不行吗?为什么要加入一个缓冲区呢?
因为:字节流操作的对象,一般是文件或者Socket,要从这些缓慢的设备中,通过频繁的交互获取数据,效率很慢。但也不能全部数据都读取到缓冲区,需要权衡,内存的价格很高,不能无限制使用。
日志缓冲
SLFJ是标准的日志记录库,最常用的实现是LogBack,它记录日志的时候,使用了缓冲队列,当缓冲的内容达到阈值的时候,才会把缓冲区的内容写到文件里。
缓冲区优化思想
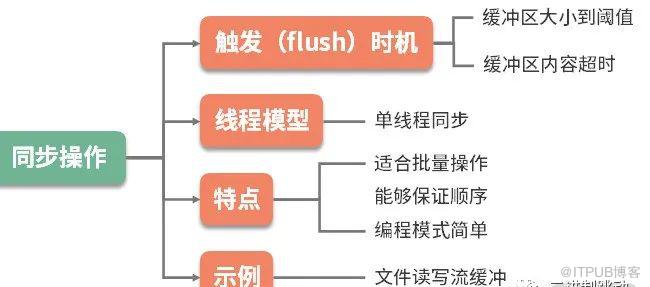
缓冲区是提高性能的,但会引入异步的问题,使得问题变得复杂。
同步操作
异步操作

Kafka缓冲区示例

生产者会把发送到同一个partition的多条消息,封装在一个batch(缓冲区)中,当batch(batch.size)满了,或者消息达到超时时间,缓冲区的消息会被发送到broker上。
这里的缓冲默认是16K,如果缓冲区突然停电,这16K的数据就会丢失。解决方法如下:
把缓冲区设置小,消息基本按单条发送,但这样会影响性能。
消息发送前记录一条日志,消息发送成功后,通过回调再记录一条日志,通过扫描生成的日志,就可以知道哪些消息丢失了。
其他做法
Stringbuilder和StringBuffer,通过要处理的字符串缓冲起来,最后完成拼接,提高字符串拼接性能。
MySQL的InnoDB引擎,通过配置buffer_pool_size的大小,减少换页,增加数据库的性能。
常见的ID生成器,会通过缓冲一部分ID段,就可以避免频繁,耗时交互。
比较严重的是缓冲区内容的丢失。所以内容在写入缓冲区之前,需要预写日志,一般采用WAL(write Ahead Logging)日志解决。
原文作者:二进制跳动;如有侵权,请联系管理员删除。

