系统设计目标(二):系统怎样做到高可用?
高可用性(High Availability,HA)是系统设计中常听到的术语,指系统具备较高的无故障运行能力。在许多开源组件的文档中,HA方案旨在提升组件可用性,以确保系统不会因故障而停止服务。例如,在Hadoop 1.0中,NameNode是单点的,一旦发生故障,整个集群将无法使用;而在Hadoop 2中,引入了NameNode HA方案,同时启动两个NameNode,一个为Active状态,另一个为Standby状态,它们共享存储。一旦Active NameNode发生故障,Standby NameNode可以切换为Active状态,确保服务持续运行,从而增强了Hadoop的持续无故障运行能力,提高了其可用性。
可用性的度量:
可用性是一个抽象的概念,你需要知道要如何来度量它,与之相关的概念是:MTBF 和 MTTR。
MTTR(Mean Time To Repair)表示故障的平均恢复时间,也可以理解为平均故障时间。这个值越小,故障对于用户的影响越小。
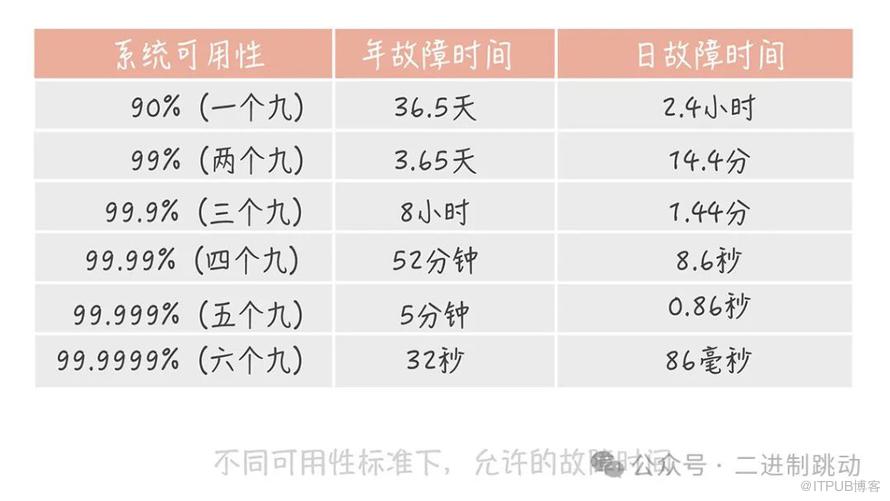
对于高并发大流量的系统,系统出现故障比性能下降对用户体验的影响更严重。例如,一个日活用户过百万的系统,一分钟的故障可能会影响上千用户。随着系统活跃用户数量的增加,一分钟的故障可能影响的用户数量也会增加,因此对系统可用性的要求也会提高。
高可用系统设计的思路
1. 系统设计
"Design for failure"是高可用系统设计中的首要原则。在应对百万QPS的高并发系统中,集群通常由数百甚至上千台机器组成,单机故障是常态,几乎每天都有可能发生。因此,预防故障至关重要。
在系统设计阶段,我们必须将故障视为一个重要考虑因素,并提前思考如何自动检测和应对故障。除了具备预见性思维外,我们还需要掌握一些优化方法,如故障转移、超时控制以及降级和限流策略。一般而言,故障转移涉及两种情况:一是在完全对等的节点之间进行故障转移;二是在非对等的节点间,即系统中存在主备节点。在对等节点之间进行故障转移相对简单。在这类系统中,所有节点均处理读写流量,且节点不保存状态,因此每个节点都可视为另一个节点的镜像。在这种情况下,如果某一节点访问失败,简单地随机访问另一节点即可。
目前最广泛使用的故障检测机制是"心跳"。这种机制通过在客户端定期向主节点发送心跳包,或者在备份节点上定期发送心跳包来实现。当一段时间内未收到心跳包时,系统可以判断主节点可能发生了故障,从而触发选主操作,将备份节点提升为新的主节点。
除了故障转移,系统间调用超时的控制也是高可用系统设计中的重要考虑因素。在复杂的高并发系统中,通常由多个系统模块组成,并且依赖于多个组件和服务,如缓存组件、队列服务等。这些组件之间的调用中,延迟往往比失败更为令人担忧,因为失败通常是瞬时的,可以通过重试来解决。然而,一旦某个调用发生较大延迟,调用方可能会被阻塞,而已占用的资源无法释放。如果存在大量此类阻塞请求,调用方可能会因资源耗尽而崩溃。
为了应对这种情况,可以采取超时控制策略。通过设置适当的调用超时时间,当某个调用未在规定时间内完成时,调用方可以选择放弃此次调用,并释放相关资源,从而避免资源的长时间占用和系统的阻塞。超时控制可以通过各种方式实现,例如在调用方设置超时时间,并在超时后执行相应的处理逻辑,或者在被调用方设置最大处理时间,并在超时时返回相应的错误信息。综合考虑系统的特点和需求,选择合适的超时控制策略对确保系统的高可用性至关重要。
降级是为了保证核心服务的稳定而牺牲非核心服务的做法。举例来说,当用户发一条微博时,通常会经过反垃圾服务的检测,以验证内容是否包含广告等不良信息,然后才会执行诸如写入数据库等后续逻辑。虽然反垃圾检测是一项相对耗时的操作,因为它涉及到大量的策略匹配,但在日常流量下仍能正常响应。然而,在高并发情况下,它有可能成为瓶颈,而且并非微博发布的主要流程。因此,我们可以暂时关闭反垃圾服务的检测,以确保主要流程的稳定性。
这种降级策略允许我们在高负载时暂时关闭或简化非核心服务,从而减轻系统压力,确保核心服务的稳定性。当系统负载降低时,可以重新启用这些服务,以提供更完整的功能和服务。这种灵活的降级策略有助于应对突发的高负载情况,保障系统的可用性和稳定性。
限流完全是另外一种思路,它通过对并发的请求进行限速来保护系统。比如对于 Web 应用,我限制单机只能处理每秒 1000 次的请求,超过的部分直接返回错误给客户端。虽然这种做法损害了用户的使用体验,但是它是在极端并发下的无奈之举,是短暂的行为,因此是可以接受的。
2. 系统运维
在系统设计阶段为了保证系统的可用性可以采取上面的几种方法,那在系统运维的层面又能做哪些事情呢?其实,我们可以从灰度发布、故障演练两个方面来考虑如何提升系统的可用性。
在业务平稳运行期间,系统很少发生故障,而大约90%的故障发生在上线变更阶段。举例来说,当上线了新功能时,由于设计方案的问题,数据库的慢请求数量翻倍,导致系统请求变慢甚至故障。如果没有这次变更,数据库也不会出现这么多无缘无故的慢请求。因此,重视变更管理对提升系统的可用性至关重要。除了提供必要的回滚方案以便在问题出现时快速回滚恢复外,另一个重要手段是灰度发布。
灰度发布意味着系统变更不是一次性全部推到线上,而是按照一定比例逐步推进的。通常,灰度发布是以机器维度进行的。例如,首先在10%的机器上进行变更,同时观察系统性能指标和错误日志。如果一段时间后系统指标稳定且没有大量错误日志,那么再推动全量变更。灰度发布为开发和运维团队提供了观察变更影响的机会,是确保系统高可用的重要关键。
除了灰度发布,在系统正常运行时,为了了解系统在发生故障时的表现,故障演练也是一个重要手段。故障演练指的是对系统进行一些破坏性的操作,观察局部故障时整体系统的表现,从而发现潜在的可用性问题。一个复杂的高并发系统依赖于许多组件,如磁盘、数据库、网卡等,这些组件随时可能发生故障。因此,通过故障演练可以发现并解决系统中存在的潜在可用性问题,确保系统在面对故障时仍能保持高可用性。
原文作者:二进制跳动;如有侵权,请联系管理员删除。

