一个完整的分布式追踪系统是什么样子的?
从广义上讲,一个完整的分布式追踪系统,应该由数据收集、数据存储和数据展示三个相对独立的子系统构成;而从狭义上讲,则就只是特指链路追踪数据的收集部分。比如Spring Cloud Sleuth就属于狭义的追踪系统,通常会搭配 Zipkin 作为数据展示,搭配 Elasticsearch 作为数据存储来组合使用。
那么这样来看,我们就可以从下面两个角度来观察分布式追踪的特征:
链路追踪的目标是通过记录系统服务调用的详细过程来帮助诊断问题和分析性能。简单来说,系统在运行时会不断处理请求并生成跟踪信息,这些信息被组织成一系列的服务调用记录,帮助我们理解服务之间是如何相互作用的。通过查看这些服务调用的时间和结果,我们可以快速找到那些响应慢或者出错的部分,进而对系统性能进行优化。
实现链路追踪意味着需要为每次服务调用创建跟踪记录,并构建出一种追踪结构。虽然这个过程本质上不太复杂,但实际上却因为服务的多样性而面临挑战。因为系统中的服务可能使用不同的编程语言和网络协议,所以要兼容所有这些不同的环境确实需要不少工作。
而非功能性的挑战,具体就来源于以下这四个方面
低性能影响:追踪不应该明显拖慢服务速度。
透明性:对开发者来说,加入追踪应该简单,最好是感觉不到它的存在。
自动扩展:随着服务规模的变化,追踪系统应该能自动适应,不需要人工调整。
持续运行:追踪系统需要全天候运作,以捕捉和分析任何时刻可能出现的问题。
数据收集的三种主流实现方式
目前,追踪系统根据数据收集方式的差异,可以分为三种主流的实现方式,分别是基于日志的追踪(Log-Based Tracing),基于服务的追踪(Service-Based Tracing)和基于边车代理的追踪(Sidecar-Based Tracing)。
基于日志的追踪
基于日志的追踪是一种利用应用程序日志来实现调用链跟踪的方法。它通过将Trace和Span等关键信息输出到应用日志中,随后通过日志归集系统将来自所有节点的日志汇总,从而反推出整个系统的调用链拓扑关系。这种方法的优点在于:
低侵入性:对网络通信没有任何侵入,对应用程序的侵入性也很小。
低性能影响:对系统性能的影响相对较低,因为它主要依赖于现有的日志记录机制。
然而,基于日志的追踪也存在一些明显的缺点:
依赖日志归集:这种追踪方法的准确性和可靠性直接依赖于日志归集过程的效率和准确性。如果日志归集过程出现延迟或丢失,将直接影响追踪数据的完整性和准确性。
可能的追踪失真:业务调用的完成和日志的归集可能不同步,由不同进程处理,这可能导致业务已经结束但日志尚未归集,从而出现追踪数据的延迟或缺失。
在介绍Elastic Stack时提到的观点也是基于这种背景,虽然ELK(Elasticsearch, Logstash, Kibana)可以在日志管理、追踪和度量方面提供一定的便利,尤其是对中小型应用来说,但对于需要高度准确性和可靠性的大型系统而言,使用专门设计用于分布式追踪的专业工具更为合适。这些工具能够提供更精确、实时的追踪数据,更好地支持复杂系统的性能分析和故障排查。
基于服务的追踪
基于服务的追踪技术,如你所提到的Zipkin、SkyWalking和Pinpoint,是目前分布式系统追踪中最常见的实现方式。这种方式通过向目标应用注入追踪探针(比如通过Java Agent)来工作。这些探针就像是寄生在目标服务上的微服务系统,具有自己的服务注册和心跳检测功能。它们通过专用的数据收集协议将监控到的服务调用信息发送给追踪系统,通常是通过HTTP或RPC请求。
与基于日志的追踪相比,基于服务的追踪方法确实会消耗更多资源并具有更高的侵入性。然而,这种方法的优势在于能够提供更高的追踪精确性和稳定性,因为它不依赖于日志归集来传输数据。通过这种方式,可以直接从追踪系统中获取到非常详细的方法级调用信息,包括参数、变量等,这对于诊断问题和性能分析来说是非常宝贵的。
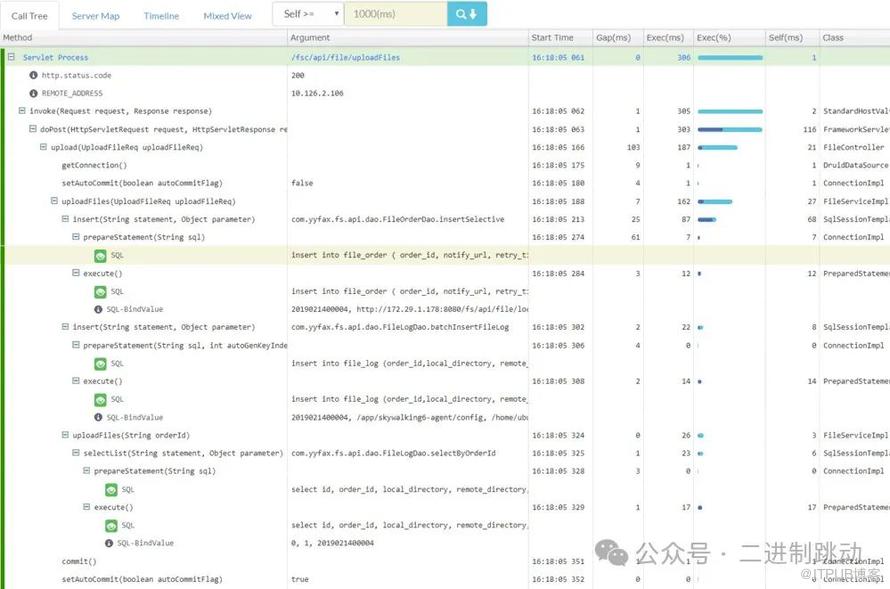
尽管基于服务的追踪能够提供非常详细和精确的追踪信息,但这种详细程度的追踪对应用系统的性能压力是相当大的。正如Pinpoint这样的系统,虽然功能强大,能够提供丰富的方法级调用信息,但它确实是一个重负载系统。Pinpoint的运行依赖于HBase,这不仅增加了系统维护的复杂性,也限制了其适用范围,特别是对于资源有限或对性能要求极高的环境。
基于边车代理的追踪
基于边车代理的追踪确实提供了一个理想的分布式追踪模型,尤其是在服务网格架构中。这种模式通过在每个服务旁边部署一个边车代理来实现,边车代理负责拦截进出的网络请求,并自动进行追踪数据的收集和上报。这样的设计带来了几个显著的优点:
对应用透明:应用无需进行任何修改,就可以实现追踪,因为所有的追踪工作都是通过边车代理完成的。这意味着无论应用的日志记录方式如何,或者服务是如何实现的,追踪机制都不会受到影响。
编程语言无关:由于边车代理工作在网络层,它完全独立于应用程序使用的编程语言。这使得基于边车的追踪方案非常灵活,适用于多种技术栈的系统。
独立的数据通道:追踪数据的收集和上报通过独立的控制平面完成,不依赖于应用的正常通信或日志系统,从而避免了对业务流程的干扰,保证了追踪的精确性和轻量性。
尽管基于边车代理的追踪模型拥有这些显著优势,但目前其普及程度受限于服务网格技术的应用范围。服务网格作为一种较新的技术架构,其复杂性和部署成本在一定程度上限制了它的快速普及。
然而,随着云原生技术的持续发展和成熟,服务网格及其内建的追踪能力预计将会得到更广泛的应用。这种基于边车代理的追踪方法,由于其高度的灵活性、透明性和低侵入性,有望成为分布式系统追踪的主流实现方式之一,为云原生时代的应用提供强大的性能监控和故障诊断能力。
原文作者:二进制跳动;如有侵权,请联系管理员删除。

